Про Groq LPU и dataflow
Как говорится: “сначала маленькая историческая справка”. Dataflow-архитектуры это концепция, которую сформулировал Джек Деннис в MIT ещё в 1974. Идея простая: процессор не исполняет программу как последовательность инструкций, а гоняет данные через сеть вычислительных узлов. Узел запускается ровно тогда, когда на всех его входах накопились операнды, и порядок исполнения определяется готовностью данных, а не счётчиком команд. Сама идея идет в противовес фон Неймановской машине с регистровым файлом и указателем на следующую инструкцию. В 80-х под это пилили реальные машины (Manchester Dataflow, MIT Tagged-Token, Monsoon), и все они померли, потому что фон Нейман + кэш + спекулятивное исполнение оказались дешевле и универсальнее. Идея ушла в спячку и осталась жить в нишах вроде систолических массивов, FPGA-пайплайнов, DSP и т.п. А через 40+ лет ее снова стали реанимировать, потому что наконец появился новый клаас задач, на который эта архитектура хорошо ложится.
Что это за класс задач. Инференс LLM на batch=1 упирается в memory bandwidth: на каждый сгенерированный токен надо прочитать все веса модели целиком и прогнать через них один входной вектор. Например, Llama-70B в fp16 это 140 ГБ весов, и эти 140 ГБ надо протащить из памяти в матричные юниты один раз на токен. На современном GPU с HBM3 на ~3 ТБ/с теоретический потолок 3000/140 ~ 21 ток/с, и никакие TFLOPS тензорных ядер не спасут, потому что matmul вырождается в matrix-vector ([1, hidden] x [hidden, hidden]), и использование тензорных ядер падает до однозначных процентов. Они большую часть времени простаивают в ожидании данных.
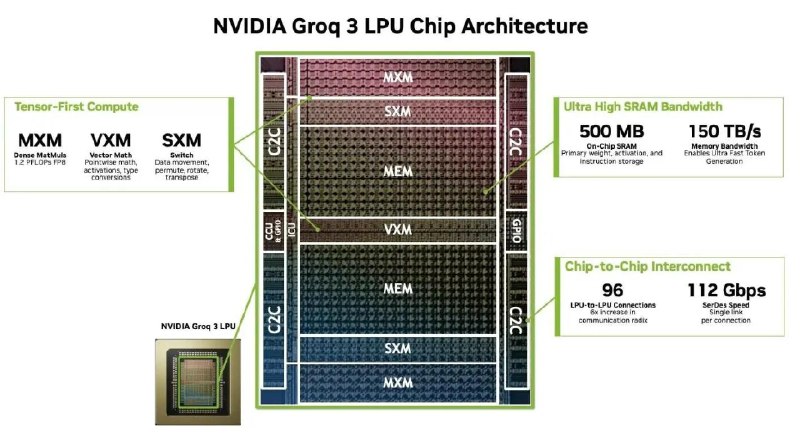
Под эту нишу и заточен Groq. Так как модель исполнения другая, из чипа уходит большая часть привычной GPU инфраструктуры. HBM не нужна, потому что веса целиком держатся в on-chip SRAM. Кэши не нужны, из-за той же SRAM с равномерным доступом => иерархию строить незачем. Warp scheduler не нужен, потому что нет конкурирующих за вычислители потоков. Остаются функциональные блоки: MXM для матриц, VXM для векторов, SXM для пермутаций, MEM для банков SRAM. Они разложены полосами, и данные физически текут через них с фиксированной скоростью, один шаг полосы за такт. Всё расписание фиксируется на этапе компиляции: компилятор знает, что веса лежат в таком-то банке SRAM, активация окажется напротив MXM на такте T, и расставляет операции так, чтобы под каждым юнитом в каждый такт был нужный тензор. В рантайме железо просто исполняет план.
В такой архитектуре кратно возрастает пропускная для весов. SRAM сидит прямо рядом с MAC-ами, доступ занимает фиксированное число тактов, без промахов кэша и без очередей к контроллеру памяти. По пропускной способности это на порядок выше любой HBM (в текущем поколении LP30 порядка 150 ТБ/с против 20 ТБ/с на стек HBM3e). MXM-массивы не простаивают, потому что операнд гарантированно приедет в нужный такт по расписанию.
Но у этого подхода есть ряд недостатков. SRAM маленький, поэтому модель приходится размазывать на много чипов в детерминированной сети + компилятор планирует ещё и межчиповые передачи такт в такт. Под обучение всё это в принципе не годится: там нужны большие батчи, динамические графы, бэкпроп и прочее. Плюс вся сложность размещения, шедулинга и межчиповой синхронизации переехала в компилятор, и под каждую модель надо перекомпилировать весь граф
Post #295
15.7K

- 🔥 14
- 👌 4