TGViewer
Channel Public Channel
Машинное обучение RU

Машинное обучение RU

@machinelearning_ru

Все о машинном обучении

админ - @workakkk

@data_analysis_ml - анализ даннных

@ai_machinelearning_big_data - Machine learning

@itchannels_telegram -лучшие ит-каналы

@pythonl - Python

@pythonlbooks- python 📚

@datascienceiot - 📚

РКН: clck.ru/3FmrUw
Subscribers
18.2K
Photos
1.8K
Videos
258
Links
2.2K

Showing posts older than #2423 · Back to latest

Older Posts 14 shown
Post #2422 3.07K
🔥 DeepSeek Code Companion — это локальный чат-бот для помощи в программировании, основанный на модели DeepSeek-R1!

🌟 Он предоставляет функции отладки кода, генерации документации и разработки решений, при этом работает полностью офлайн, что обеспечивает конфиденциальность данных. Взаимодействие с ботом осуществляется через Gradio, предоставляя удобный веб-интерфейс.

🖥 Github

@machinelearning_ru
  • 👍 7
  • 👎 2
  • 👏 2
  • ❤ 1
  • 🔥 1
Post #2418 2.27K
Post #2415 2.33K
⚡️ OmniHuman-1 - новая ИИ-модель генерации видео от китайской компании ByteDance

Все видео были сгенерированы из одного входного изображения и одной аудио дорожки.

По сравнению с существующими методами OmniHuman не только создает более реалистичные видео, но и обеспечивает большую гибкость в управлением генерацией.

https://huggingface.co/papers/2502.01061
  • 👍 12
  • ❤ 4
  • 🔥 3
Post #2412 2.01K

Forwarded from Machinelearning

🌟 Mixture-of-Mamba: метод повышения эффективности MMLM.

Mixture-of-Mamba — экспериментальная архитектура, которая делает мультимодальные модели (работающие с разными типами данных, например, текстом, изображениями и речью) более эффективными и быстрыми. Она использует идею разреженности, чтобы уменьшить количество вычислений, сохраняя при этом высокое качество работы модели.

Разреженность — это подход, при котором модель фокусируется только на приоритетных данных, игнорируя менее значимые. Это похоже на то, как человек читает текст: мы не вникаем в каждую букву, а схватываем ключевые слова и фразы. В ML разреженность позволяет: уменьшить вычислительные затраты, ускорить обучение и инференс, повысить качество.


Mixture-of-Mamba добавляет модально-ориентированную разреженность в блоки Mamba и динамически выбирает модально-специфичные веса в каждом компоненте обработки ввода блоков Mamba.

В отличие от MoE-Mamba, где разреженность применяется только к MLP-слоям, Mixture-of-Mamba модифицирует непосредственно структуру блока Mamba. Модально-специфичная параметризация применяется к входной проекции, промежуточным и выходной проекциям. Сверточные слои и переходы состояний остаются общими.

Обучение Mixture-of-Mamba происходит в 3 модальных режимах: Transfusion (чередование текста и непрерывных токенов изображений с диффузионной потерей), Chameleon (чередование текста и дискретных токенов изображений) и расширенная трехмодальная среда со включением речи.

В Transfusion Mixture-of-Mamba достигает эквивалентных значений потерь для изображений, используя при этом лишь 34.76% от общего объема вычислительных ресурсов (FLOPs) при масштабе модели 1.4B. В сценарии Chameleon аналогичный уровень потерь при обработке изображений при использовании 42.50% FLOPs, а при обработке текстовых данных – 65.40% FLOPs. В трехмодальной среде Mixture-of-Mamba показывает потери в речевом режиме при 24.80% FLOPs на масштабе 1.4B.

▶️Практическая реализация архитектуры доступна в репозитории проекта на Github.


📌Лицензирование: MIT License.


🟡Arxiv
🖥GitHub


@ai_machinelearning_big_data

#AI #ML #MMLM #Mamba #MixtureOfMamba
  • 👍 4
  • ❤ 2
  • 🔥 2
Post #2411 2.42K
🔎 Perplexica — это поисковая система на базе ИИ, являющаяся альтернативой Perplexity AI!

🌟 Она использует передовые алгоритмы машинного обучения, такие как поиск по схожести и встраивание (embeddings), чтобы улучшить результаты поиска и предоставить более релевантные ответы. Среди особенностей Perplexica — интеграция с локальными моделями ИИ, различные режимы поиска (например, академический или поиск по YouTube) и поддержка API для разработчиков. Для получения актуальных и защищённых результатов система использует метапоиск через движок SearxNG.

🔐 Лицензия: MIT

🖥 Github

@machinelearning_ru
  • 👍 7
  • ❤ 4
  • 👏 1
Post #2409 2.13K

Forwarded from Machinelearning

⚡ LitGPT

20+ производительных LLM, написанных с нуля, с подробным описанием, инструкциями, файнтюнигу и деплою.

Особенности:
🟢 Модели написаны с нуля
🟢 Нет абстракций
🟢 Подходит для обучения новичков
🟢 Flash attention
🟢 FSDP
🟢 LoRA, QLoRA, Adapter
🟢 Уменьшение памяти GPU (fp4/8/16/32)
🟢 1-1000+ GPU/TPUs
🟢 20+ LLMs

Установка:


pip install 'litgpt[all]'

Пример:

from litgpt import LLM

llm = LLM.load("microsoft/phi-2")
text = llm.generate("Fix the spelling: Every fall, the familly goes to the mountains.")
print(text)
# Corrected Sentence: Every fall, the family goes to the mountains.


▪Github
▪Docs
▪Video

@ai_machinelearning_big_data


#LitGPT #tutorial #llm #ai #ml
  • 👍 5
  • 🔥 3
  • ❤ 2
Post #2406 2.4K
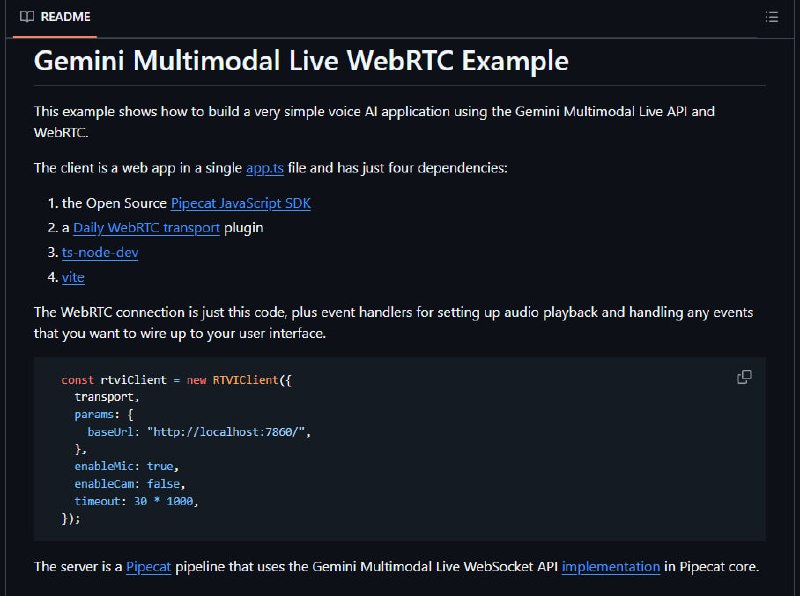
🔥 gemini-webrtc-web-simple — это пример простой реализации голосового AI-приложения с использованием Gemini Multimodal Live API и протокола WebRTC!

🌟 Репозиторий содержит минималистичный клиент, написанный на TypeScript, и сервер, использующий Pipecat, который выступает как прокси между WebRTC и API Gemini. Эта архитектура позволяет обеспечить низкую задержку и высокую производительность при обработке голосовых данных в реальном времени.

🖥 Github

@machinelearning_ru
  • 👍 8
  • ❤ 2
  • 🔥 2
Post #2405 2.92K
🖥 QuicKB — это инструмент для оптимизации поиска информации в документах с помощью машинного обучения!

🌟 Он автоматически разбивает документы на части, используя семантические и статистические методы, а затем генерирует синтетические обучающие данные (вопросы и ответы) для улучшения качества поиска. Это особенно полезно для создания специализированных баз знаний и эффективного поиска по большим текстовым массивам.

🔐 Лицензия: MIT

🖥 Github

@machinelearning_ru
  • 👍 12
  • ❤ 2
  • 🔥 2
Post #2403 2.69K
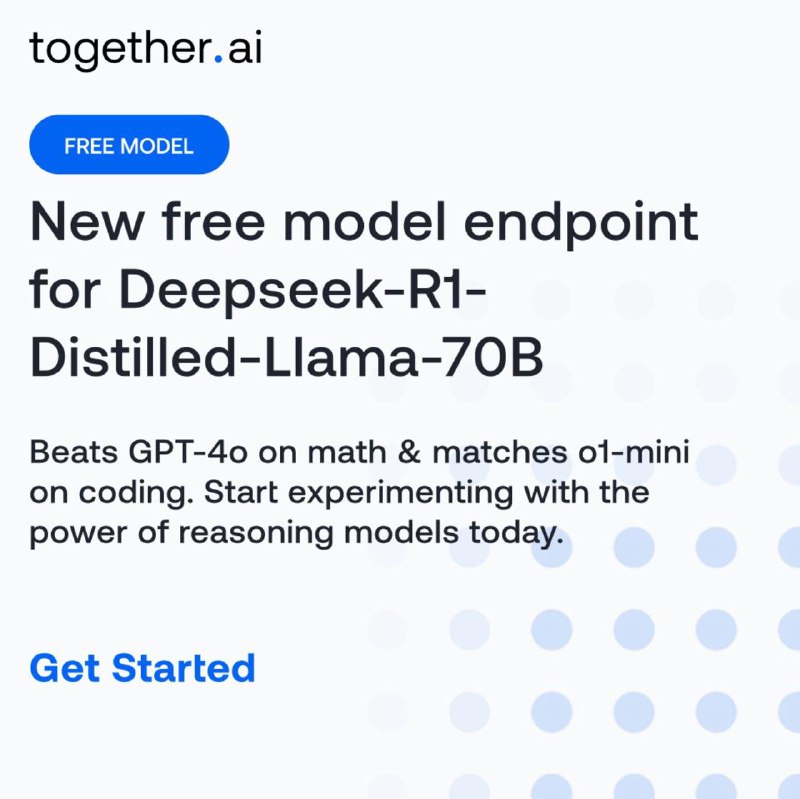
🚀 Свежий 100% бесплатный API с дистиллированным DeepSeek-R1 Llama 70B.

Доступно на Together AI, они размещают эти модели в своих собственных центрах обработки данных, и никакие данные не отправляются обратно в DeepSeek.

Примечание: эндпоинт бесплатной модели имеет ограничения по скорости и производительности по сравнению с их платными режимами Turbo, тем не менее все работает.

https://api.together.ai/playground/chat/deepseek-ai/DeepSeek-R1-Distill-Llama-70B-free

@machinelearning_ru
  • 🔥 8
  • 👍 4
  • 👎 3
  • ❤ 1
Post #2402 2.34K
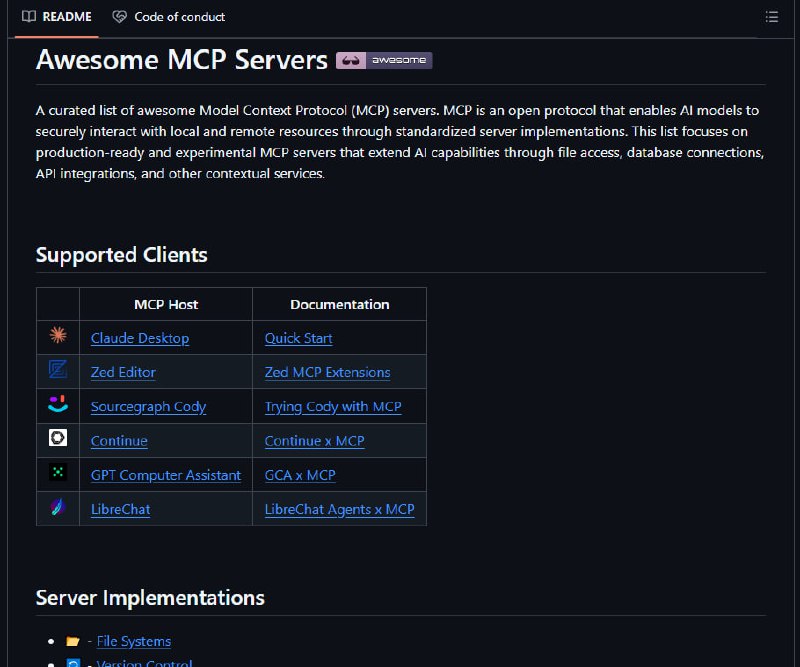
🔥 Awesome MCP Servers — это коллекция ресурсов, посвящённых серверам, использующим протокол Model Context Protocol (MCP)!

💡 MCP — это открытый протокол, который позволяет языковым моделям (LLMs) взаимодействовать с локальными и удалёнными ресурсами через стандартизированные серверные реализации. Репозиторий содержит список готовых к использованию и экспериментальных MCP-серверов, расширяющих возможности LLM за счёт доступа к файлам, базам данных, API, системам управления версиями и другим сервисам.

🖥 Github

@machinelearning_ru
  • 👍 3
  • ❤ 1
Post #2401 2.37K
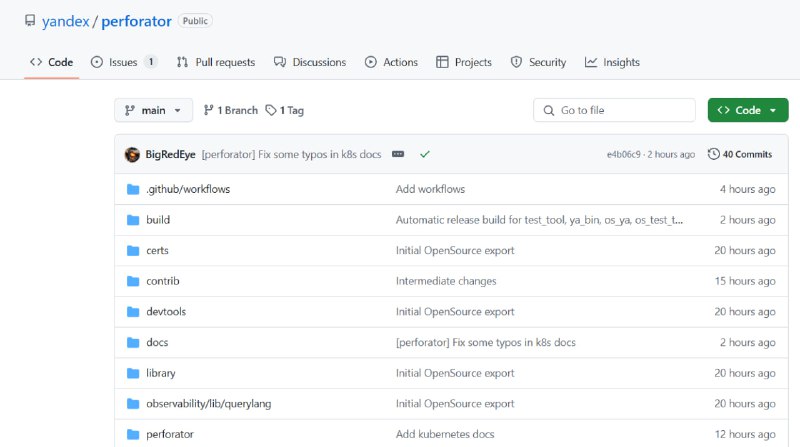
🔥 Perforator — уникальная система от Яндекса для оптимизации серверов и экономии на инфраструктуре

🌟 Это первый в России открытый инструмент непрерывного профилирования с подобным широким функционалом. Perforator помогает оценить код на уровне компании, находит неэффективности и показывает, какие участки потребляют слишком много ресурсов. В инфраструктуре Яндекса система уже оптимизировала работу крупнейших сервисов.

🌟 Система позволяет сократить затраты на серверное оборудование до 20%. Perforator работает без модификации исходного кода, поддерживает C++, C, Go, Rust (скоро добавят Python и Java).

🔐 Лицензия: MIT

🖥 Github

@machinelearning_ru
  • 👎 7
  • 👍 4
  • 😁 3
  • ❤ 2
  • 🥰 1
Post #2400 2.39K
🔥 OmAgent — это Python-библиотека для создания мультимодальных языковых агентов!

🌟 Она обеспечивает простой интерфейс для разработки агентов, способных работать с текстом, изображениями, видео и аудио, скрывая сложные аспекты оркестрации рабочих процессов, управления очередями задач и оптимизации узлов. OmAgent включает поддержку мультимодальных моделей, таких как Vision-Language Models (VLM), и функционал для подключения мобильных устройств.

🔐 Лицензия: Apache-2.0

🖥 Github

@machinelearning_ru
  • ❤ 6
  • 👍 2
  • 🔥 1
Post #2395 2.41K

Forwarded from Machinelearning

⚡️ Hailuo AI выпустили новую версию своего генератора видео T2V 01 Director, в которой упор сделан на контроль камеры!

Модель управления и движения камеры работает просто великолепно.

✨ Что нового:
- Уменьшена хаотичность движений генераций.
- Повышена точность управления.
- Улучшена эстетика движения камеры.

📌 Попробовать

@ai_machinelearning_big_data


#video #ai #videogenerator #Hailuo
  • 👍 8
  • ❤ 3
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →