TGViewer
Channel Public Channel
Машинное обучение RU

Машинное обучение RU

@machinelearning_ru

Все о машинном обучении

админ - @workakkk

@data_analysis_ml - анализ даннных

@ai_machinelearning_big_data - Machine learning

@itchannels_telegram -лучшие ит-каналы

@pythonl - Python

@pythonlbooks- python 📚

@datascienceiot - 📚

РКН: clck.ru/3FmrUw
Subscribers
18.2K
Photos
1.8K
Videos
258
Links
2.3K

Showing posts older than #2329 · Back to latest

Older Posts 17 shown
Post #2328 2.72K

Forwarded from Machinelearning

🖥 Magnetron

Этот проект был создан, с целью изучения понимания внутренней работы PyTorch и других популярных фреймворков глубокого обучения.

Главная цель проекта - создание с нуля минималистичного, но при этом мощного фреймворк глубокого обучения, который можно использовать как для исследований, так и для продакшена.

Фреймворк написан на C и Python и спроектирован так, чтобы его было легко понять и модифицировать.

Знаменитая цитат Ричарда Фейнмена - То, что я не могу создать, я не понимаю.

Создание собственного языка программирования, игрового движка и конечно фреймворка машинного обучения позволит понять, как работает современное программное обеспечение, до мельчайших деталей.

◾️GitHub
◾️Demo
◾️Docs

@ai_machinelearning_big_data

#c99 #python #framework
  • 👍 7
  • 🔥 4
  • ❤ 1
Post #2327 3.12K
🔥 scikit-opt — библиотека на Python для решения задач оптимизации с использованием методов роя и эволюционных алгоритмов!

🌟 Она включает такие алгоритмы, как генетический алгоритм (GA), оптимизация роя частиц (PSO), имитация отжига (SA), алгоритм муравьиной колонии (ACO), дифференциальная эволюция и другие.

🔐Лицензия: MIT

🖥 Github

@machinelearning_ru
  • 👍 7
  • ❤ 4
  • 🔥 1
Post #2326 3.23K
🔥 "your-source-to-prompt.html" — инструмент, который позволяет превращать исходный код проектов в текстовые запросы для LLM, используя только ваш локальный компьютер!

🌟 Все операции выполняются в браузере, без необходимости установки дополнительных зависимостей. Это решение ориентировано на безопасность (код не покидает устройство) и удобство работы с любыми папками и репозиториями. Оно поддерживает создание предустановок для повторяющихся задач и может минимизировать код для экономии места в контексте модели.

🖥 Github

@machinelearning_ru
  • ❤ 4
  • 👍 2
  • 👏 2
  • 🥰 1
Post #2325 3.19K
🔥 ebook2audiobook — это инструмент, который преобразует текст из электронных книг в аудиокниги! Он поддерживает клонирование вашего голоса и более 1100 языков!

🔗 Ссылка: *клик*

@machinelearning_ru
  • ❤ 7
  • 🥰 2
  • 🤯 2
  • 👎 1
Post #2324 3.34K
Это мы
  • 😁 25
  • 👍 3
  • ❤ 2
  • 🔥 2
  • 😱 2
  • 👎 1
Post #2322 3.33K
🔥 Gateway — это легковесное и быстрое решение для маршрутизации запросов к более чем 250 языковым, визуальным и аудиомоделям!

🌟 Оно предлагает единый API для интеграции моделей менее чем за 2 минуты, поддерживает балансировку нагрузки, условную маршрутизацию, автоматическое восстановление и встроенные механизмы защиты (guardrails). Система оптимизирована для масштабирования AI-приложений, обеспечивает надёжность и безопасность, подходя как для индивидуальных разработчиков, так и для корпоративного использования.

🔐 Лицензия: MIT

🖥 Github

@machinelearning_ru
  • 👍 6
  • 🔥 3
  • ❤ 1
  • 👏 1
Post #2321 3.05K
🔍 Hands-On Large Language Models — репозиторий, который содержит учебные материалы и примеры из одноименной книги для работы с LLM!

🌟 Этот проект ориентирован на разработчиков и исследователей, желающих освоить методы работы с моделями, такими как GPT, BERT и другие. В репозитории собраны ресурсы, примеры кода и пошаговые инструкции по использованию LLM в реальных приложениях, включая задачи обработки естественного языка, генерацию текста, перевод и другие.

🔐 Лицензия: Apache-2.0

🖥 Github

@machinelearning_ru
  • 👍 6
  • 🔥 4
  • ❤ 3
Post #2319 2.71K
Невероятный прогресс за год )

@machinelearning_ru
  • 😁 20
  • ❤ 2
  • 👎 2
  • 🤬 2
  • 🔥 1
  • 😢 1
Post #2317 2.53K

Forwarded from Machinelearning

🌟 OmniAudio: Мультимодальная модель для обработки аудио и текста.

OmniAudio - мультимодальная модель с 2.6 млрд. параметров, объединяющая в себе Gemma-2-2b, Whisper turbo и специализированный проекционный модуль для обработки аудио и текста на потребительских устройствах. В отличие от традиционных подходов, использующих последовательное соединение моделей ASR и LLM, OmniAudio, объединяет эти функции в единой архитектуре, минимизируя задержку инференса и потребление ресурсов.

OmniAudio применима в сценариях голосовых запросов в автономном режиме, ведения диалогов, генерации контента, создания кратких обзоров записей и модификации интонации голоса.

Например, можно задать вопрос "Как развести костер без спичек?" и получить полезные инструкции, не имея подключения к Интернет. Модель может поддержать беседу, если вы скажете "У меня сегодня был тяжелый день на работе", или сгенерировать хайку на тему осенних листьев. OmniAudio способна преобразовать обычную голосовую заметку в формальное сообщение, сохраняя при этом основную идею.

OmniAudio обучалась в три этапа:

🟠Предварительное обучение - alignment аудио и текста с применением датасета MLS English 10k transcription. Для различения задач транскрибирования и завершения был введен специальный токен <|transcribe|>.

🟠Этап SFT улучшил возможности ведения диалога за счет использования синтетических данных, полученных на основе контекстно релевантных ответов к тому же датасету. Для из синтеза создания применялась собственная модель.

🟠На финальном этапе, DPO, было повышено качество за счет исправления неточностей при сохранении семантического соответствия с помощью GPT-4o в качестве эталона. Для стабильности качества при обработке как аудио, так и текстовых данных, ответы Gemma2 использовались как «золотой стандарт».

Производительность модели была протестирована на потребительском оборудовании. На Mac Mini M4 Pro модель Qwen2-Audio-7B-Instruct, работающая на Transformers, достигла скорости декодирования 6.38 токенов в секунду.

В то же время OmniAudio через Nexa SDK показала 35.23 токенов в секунду в формате FP16 GGUF и 66 токенов в секунду в квантованном формате Q4_K_M GGUF.

Модель опубликовала в 4 вариантах квантования в формате GGUF:

🟢OmniAudio-2.6B-model-fp16 - 5.24 Gb
🟢OmniAudio-2.6B-model-q8_0 - 2.78 Gb
🟢OmniAudio-2.6B-model-q4_K_M - 1.71 Gb
🟢OmniAudio-2.6B-model-q4_0 - 2.78 Gb

⚠️ Разработчик рекомендует локальный инференс в Nexa-SDK, опенсорс-фреймворке на основе GGLM, написанный на C++ для инференса моделей разных модальностей.

⚠️ В качестве ориентира по планированию ресурсов: для запуска OmniAudio версии q4_K_M требуется 1.30GB RAM.


📌Лицензирование: Apache 2.0 License.


🟡Страница проекта
🟡Модель
🟡Demo
🟡Сообщество в Discord


@ai_machinelearning_big_data

#AI #ML #OmniAudio #NexaAI
  • 👍 3
  • ❤ 1
  • 🔥 1
Post #2314 2.62K
🔥 FireFlow — метод быстрого инверсного преобразования и редактирования изображений, основанный на модели FLUX-dev!

🌟 FireFlow использует численный решатель второго порядка для работы с моделями ReFlow, что позволяет достичь высокой точности при сравнительно низких вычислительных затратах. Этот подход применяется для задач, таких как реконструкция изображений и их семантическое редактирование.

🔐 Лицензия: Apache-2.0

🖥 Github

@machinelearning_ru
  • 👍 2
  • 🔥 2
Post #2313 2.72K
🔥 Мультимодальность, открытый код и гиперперсонализация вошли в тройку ИИ-трендов следующего года.

Эксперты отрасли рассказали, что в ближайшем будущем модели будут двигаться в сторону ориентирования сразу на несколько форматов данных — текст, изображения, аудио и видео. Опенсорс продолжит развиваться — разработчики будут использовать открытый код и выкладывать новые модели в Open Source.

По словам специалиста Яндекса, уровень развития опенсорса уже сейчас достаточно высок, особенно это заметно в области LLM с открытым кодом. IT-компании во всем мире применяют собственные знания вместе с опенсорс-решениями, подстраивая их под потребности бизнеса и пользователей.

Кроме того, в списке трендов — автономные системы, гибридные подходы ИИ и интеграция ИИ в повседневную жизнь.

📌 Источник

@machinelearning_ru
  • 👍 3
  • 🔥 1
Post #2312 2.73K
🔥 Kheish — платформа для оркестрации многоагентных рабочих процессов с использованием LLM!

🌟 Она поддерживает внешние модули и технологии RAG для работы с большими кодовыми базами. Платформа позволяет интегрировать различные агенты (предложитель, рецензент, валидатор, форматировщик) и модули (например, файловая система или команды shell) для выполнения сложных задач в виде последовательности шагов, основанных на YAML-конфигурациях.

🔐 Лицензия: Apache-2.0

🖥 Github

@machinelearning_ru
  • 👍 4
  • ❤ 1
  • 🔥 1
Post #2309 3.42K
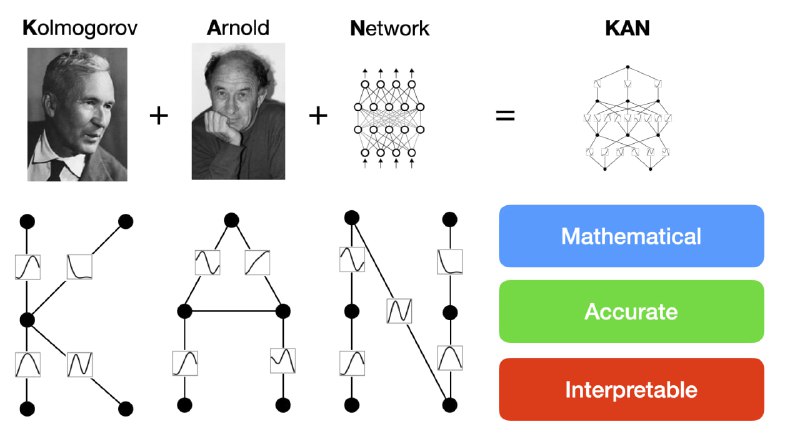
👩‍💻 pykan — это проект, который реализует Kolmogorov-Arnold Networks (KANs)!

💡 KAN (сеть Колмогорова-Арнольда) представляет собой тип искусственных нейронных сетей, который отличается от классических многослойных перцептронов (MLP). В KAN используются особые функции активации на рёбрах сети, что позволяет решать задачи с высокой точностью и интерпретируемостью.

🔍 Возможности использования:

🌟 Научные задачи: Благодаря своей точности и способности моделировать сложные зависимости, KAN может использоваться для вычислительных задач, таких как решение сложных дифференциальных уравнений или моделирование физических процессов.

🌟 Нейронные сети и машинное обучение: KAN может быть использован для задачи обучения с учётом данных, которые трудно моделировать с использованием стандартных MLP или других популярных архитектур.

🔐 Лицензия: MIT

📖 Arxiv
🖥 Github

@machinelearning_ru
  • 😁 17
  • 🤩 6
  • 👍 4
  • ❤ 2
  • 🔥 1
Post #2307 2.83K
Свежий мини-курс по работе с моделями типа O1 и другими «reasoning»-моделями.

Это официальный гайд по промптингу, созданный в сотрудничестве с OpenAI и ключевым разработчиком Колином Джарвисом (главой подразделения решений в области искусственного интеллекта).

Курс научит вас новым важным техникам для модификации запросов, выполнения планов, генерации кода, рассуждений и многого другого.

Он поможет улучшить ответы нейросети O1, ведь стандартные методы промпт-инжиниринга зачастую приводят к ухудшению качества ответов.

Гайды разработаны при участии OpenAI, поэтому им можно доверять:

https://www.deeplearning.ai/short-courses/reasoning-with-o1/
  • 👍 3
  • ❤ 2
  • 🔥 1
Post #2303 2.98K

Forwarded from Machinelearning

🌟 CAD-Recode: создание САПР-моделей из облаков точек.

CAD-Recode - модель для преобразования облака точек в последовательность эскизов и экструзии, записанных как код Python с использованием библиотеки CadQuery. CAD-Recode способен создавать точные CAD модели с минимальным количеством входных точек, а возможность редактирования кода с помощью LLM открывает новые возможности для интерактивного изменения геометрии САПР-моделей.

CAD-Recode состоит из двух частей: проектора, который переводит облака точек в данные для обработки, и LLM на основе Qwen2-1.5B, в которой был сохранен оригинальный токенизатор и добавлен один дополнительный линейный слой.

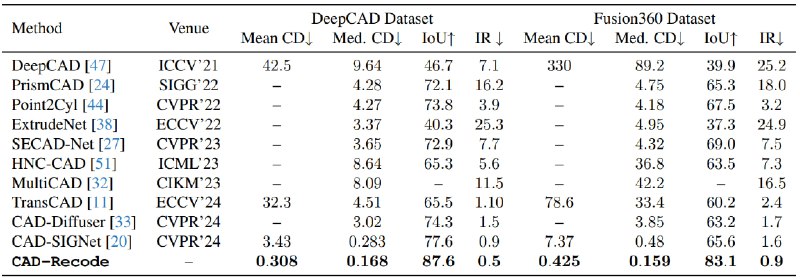
Модель обучалась на 1 млн. CAD-моделей. Качество обучения модели оценивалось по 3 показателям: расстоянию Хаусдорфа (CD), пересечению над объединением (IoU) и доле неверных результатов (IR).

Эксперименты с полученной моделью проводились на 3 датасетах: DeepCAD, Fusion360 и CC3D.

CAD-Recode показал значительное улучшение по сравнению с другими методами, достигнув медианного CD в 0.168 на DeepCAD и 0.159 на Fusion360. CAD-Recode продемонстрировал 76.5% точность при ответе на вопросы по САПР (CAD-QA) при использовании GPT-4o.

В репозитории проекта на Github доступна простая демонстрация инференса CAD-Recode. Перед использованием необходимо установить пакеты в соответствии с Dockerfile и затем запустить demo.ipynb в jupyter.


📌Лицензирование: Apache 2.0 License.


🟡Модель
🟡Arxiv
🟡Demo
🖥GitHub


@ai_machinelearning_big_data

#AI #ML #LLM #CADRecode
  • ❤ 5
  • 👍 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →