
ИИ-агенты смогут учиться не на датасетах, а на ваших правках
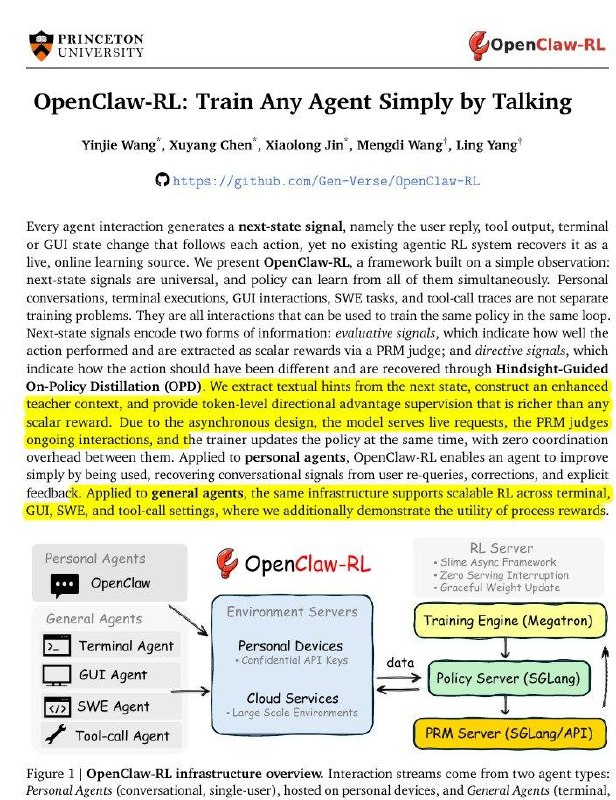
OpenClaw-RL предлагает очень важный сдвиг: модель больше не ждёт, пока люди вручную соберут, разметят и оценят огромный датасет.
Она учится прямо во время обычной работы.
Пользователь поправил ассистента? Это сигнал.
Тест упал? Это сигнал.
Человек задал тот же вопрос ещё раз? Возможно, ответ был плохим.
Лог ошибки показал, где агент сломался? Это тоже обучающий пример.
Главная идея простая: современные RL-системы часто смотрят только на финальный результат - получилось или нет. Но они игнорируют самое ценное: объяснение, почему не получилось и что надо было сделать иначе.
OpenClaw-RL вытаскивает из каждого взаимодействия два типа сигналов:
1. Оценочный сигнал
Система понимает, сработало действие или нет. Например:
- тест прошёл - хорошо;
- пользователь повторил вопрос - вероятно, недоволен;
- задача завершилась ошибкой - агент сделал что-то не так.
2. Направляющий сигнал
Система смотрит, как именно надо было исправить поведение:
- правки пользователя;
- error logs;
- терминальные команды;
- клики в интерфейсе;
- исправления в коде;
- реакции в обычном чате.
Дальше агент учится в фоне и не останавливает работу. Он просто превращает реальные реакции пользователя в постоянный поток обучения.
Это уже не классическое «собрали датасет - обучили модель - выкатили новую версию».
Это ближе к живому агенту, который становится лучше от каждого рабочего контакта с человеком, тестами, терминалом и интерфейсом.
Если подход взлетит, будущие AI Agents будут не просто выполнять задачи, а постепенно подстраиваться под стиль конкретного пользователя, команду и рабочую среду.
Paper: OpenClaw-RL: Train Any Agent Simply by Talking
arxiv.org/abs/2603.10165
Post #3331
2.22K
- 👍 7
- ❤ 4
- 🔥 3
- 👏 1