
🔍 Как избежать хаоса в общих ML-утилитах?
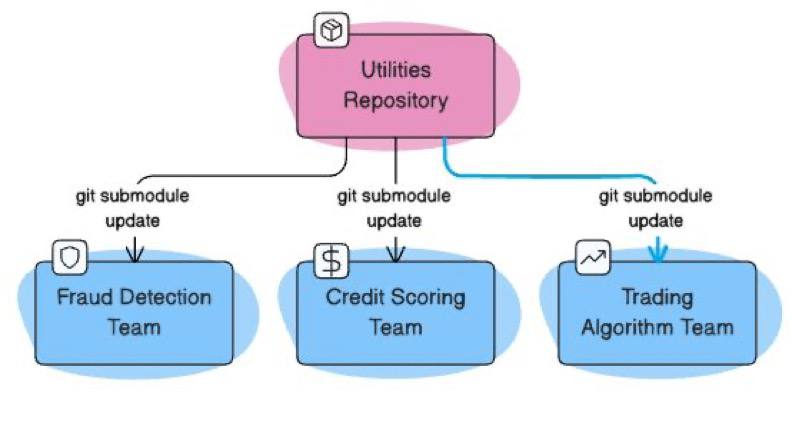
Типичная ситуация в data science: несколько команд используют один и тот же код, но из-за разных репозиториев и релизных циклов версии утилит быстро расходятся. Обновления одной команды не доходят до других, баги фиксируются выборочно, а со временем код и вовсе начинает жить своей жизнью в каждом проекте.
Git submodules решают эту проблему, позволяя встраивать общий репозиторий как подкаталог в другие проекты. Вместо копирования кода — ссылка на конкретный коммит. Так, даже в условиях разных уровней безопасности или частых обновлений, все команды работают с одинаковой версией утилит.
Но при этом подход не идеален: требует аккуратности в работе, но для быстро меняющегося ML-кода — это часто лучшее решение, чем классические пакеты Python. Главное — все изменения остаются прозрачными, а утилиты можно сразу отлаживать в контексте проекта.
🔗 Ссылка - *клик*
@machinelearning_ru
Post #2865
2.44K
- ❤ 6
- 🔥 1
- 🥰 1