


Это модель, которая не просто доказывает теоремы, а учится на своих ошибках.
Kimina-Prover-72B создана на базе Qwen2.5-72B, которая бьет рекорды в формальной математике на Lean 4 и ее облегченные версии 8 и 1,7 миллиарда параметров.
Numina - это некоммерческая научная коллаборация, ориентированная на развитие ИИ в области математики. Ее миссия: создание и публикация обширных баз данных математических задач, разработку open-source ИИ-решателя для их обработки и инструментов для поддержки совместной работы людей и ИИ в фундаментальных науках.
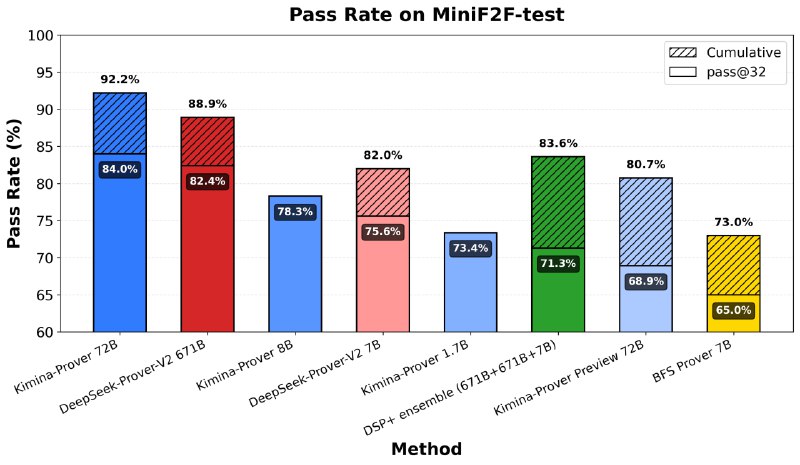
На популярном бенчмарке miniF2F Kimina-Prover-72B достигла внушительной точности в 92.2%, оставив позади Deepseek-Prover-V2 671B.
🟡Ключевая фишка Kimina-Prover - агентный фреймворк для поиска доказательств Test-Time Reinforcement Learning.
Вместо того чтобы пытаться решить сложную задачу в лоб, система научилась декомпозировать ее. Она самостоятельно генерирует, комбинирует и применяет промежуточные утверждения, или леммы, выстраивая из них длинные логические цепочки. По сути, это рекурсивный поиск: для доказательства основной теоремы модель может сначала доказать несколько вспомогательных лемм.
🟡Механика доказательств.
Система отслеживает «рейтинг полезности» каждой леммы и отбраковывает те, что ведут в тупик. Вторым эшелоном идет механизм проверки на вменяемость. Прежде чем использовать новую лемму, модель пытается доказать ее отрицание. Если это удается, значит, лемма противоречива и ее сразу выбрасывают. Такая комбинация гарантирует логическую строгость и надежность всего доказательства.
🟡Kimina-Prover умеет учиться на ошибках.
В отличие от других систем, которые в случае неудачи просто начинают заново, Kimina-Prover умеет читать сообщения об ошибках от компилятора Lean и предлагать исправления.
Для этого ее специально дообучали на датасете из комбинаций «неверное доказательство – фидбэк – верное доказательство». Чтобы обучение шло стабильно, использовали стратегию Batched Failure Replay: все неудачные попытки с одной итерации собираются и используются как обучающий батч для следующей. И это оказалось куда эффективнее, чем бездумный перебор вариантов при том же бюджете вычислений.
📌Лицензирование: MIT License.
🟡Статья
🟡Набор моделей
🟡Demo
🖥GitHub
@ai_machinelearning_big_data
#AI #ML #LLM #TTRL #Reasoning #KiminaProver