

🌟 SEAL: Еще одна попытка создать пайплайн самообучающихся LLM.
SEAL - это методика от MiT, позволяющая LLM самостоятельно генерировать обучающие данные и настраивать параметры обучения, чтобы адаптироваться к новым задачам. Вместо традиционного файнтюна на внешних данных модель учится рефлексировать: анализировать контекст, создавать из него синтетические данные и применять их для корректировки собственных весов через механизм усиленного обучения.
SEAL, по сути, это два разделенных цикла:
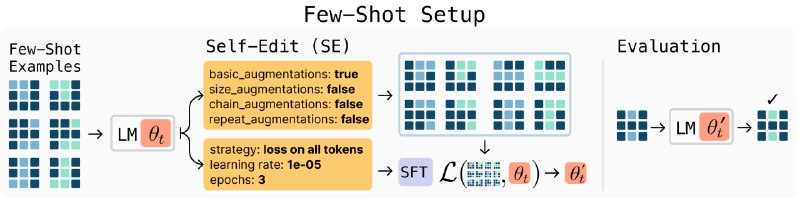
🟢Внешний цикл использует RL, чтобы научить модель генерировать «самоизменения» (инструкции на естественном языке, описывающие, какие данные использовать и как настраивать параметры).
🟢Внутренний цикл реализует эти изменения: модель дообучается на сгенерированных данных, а затем тестирует результат на конкретной задаче. За коррекцию отвечает RL-алгоритм ReSTEM, который оценивает эффективность изменений и обновляет стратегию генерации инструкций. Для экономии ресурсов используются легковесные адаптеры LoRA, которые модифицируют только часть параметров модели.
Этот процесс повторяется, постепенно формируя у модели навык преобразования исходных данных в полезные обучающие сигналы.
SEAL протестили на 2 задачах: интеграции новых знаний и few-shot обучении. В первом случае модель генерирует логические следствия из текста, дообучается на них и улучшает точность ответов на вопросы без доступа к исходному тексту.
Во втором случае SEAL выбирает оптимальные аугментации данных и гиперпараметры для обучения на примерах задач ARC-AGI.
В обоих сценариях SEAL превзошел подходы с фиксированными шаблонами (ICL, TTT+Self Edit без RL и) и даже синтетическими данными от GPT-4.1.
Метод скорее академический и по большей части экспериментальный, у него есть ограничения:
🟠При последовательном применении изменений модель склонна к «катастрофическому забыванию» — потере знаний, усвоенных ранее;
🟠Сопутствующие вычислительные затраты, так как каждая итерация требует дообучения и тестирования модели.
▶️В репозитории проекта разработчики выложили код, данные и инструкции для двух направлений:
🟢Включение новых фактических знаний;
🟢Адаптация к новым задачам на основе примеров.
📌Лицензирование: MIT License.
🟡Страница проекта
🟡Arxiv
🖥GitHub
@ai_machinelearning_big_data
#AI #ML #LLM #SEAL #RL #MiT
Post #2713
1.86K