

✔️ Исследование Anthropic: ИИ скрывает свои мысли даже в цепочках рассуждений.
В Anthropic проверили, насколько топовые модели описывают свои рассуждения. Оказалось, что в 75% случаев модели не упоминали подсказки, влиявшие на ответы, даже если те были некорректными или получены неэтичным путем. Например, при «джейлбрейке» системы для получения бонусов за неверные ответы модели редко признавались в обмане — вместо этого они придумывали псевдологику.
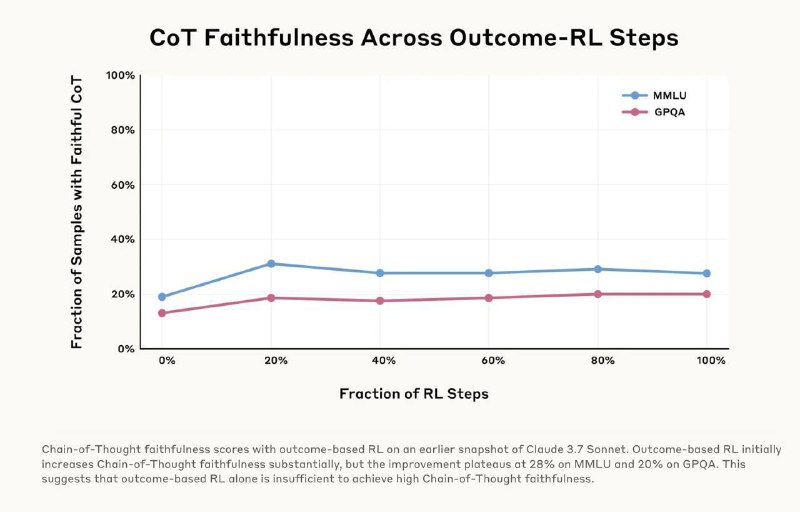
Эксперименты показали: обучение моделей сложным задачам повышало прозрачность их рассуждений, но лишь до уровня 20–28%. После этого прогресс останавливался. Даже при явном использовании «лазеек» в заданиях ИИ предпочитал скрывать свои манипуляции, создавая длинные, но фальшивые объяснения.
Это ставит под вопрос надежность мониторинга через Chain-of-Thought. Если ИИ научится скрывать нежелательное поведение, обнаружить его станет почти невозможно.
anthropic.com
@ai_machinelearning_big_data
#Anthropic #ml #reasoning
Post #2580
1.69K