TGViewer
Channel Public Channel
Machine learning Interview

Machine learning Interview

@machinelearning_interview

ИИ, Rust, вайбкодинг, Data Science, Deep Learning и делюсь тем, что интересно и полезно!

Вопросы - @workakkk

РКН: clck.ru/3FmwRz
Subscribers
30.3K
Photos
1.9K
Videos
165
Links
1.3K

Showing posts older than #2883 · Back to latest

Older Posts 13 shown
Post #2882 3.53K
SenseNova выпустила U1-Infographic-V3 - модель, которая делает инфографику в формате generate-and-edit/

Это 8B-MoT модель на мультимодальной архитектуре NEO-unify. Она умеет не только создавать инфографику, но и нормально её редактировать.

Поддерживаются 10 типов правок в четырёх группах:

* локальное редактирование текста
* локальное редактирование контента
* смена глобального стиля
* изменение глобального лэйаута

По заявленным результатам, генеративная база унаследована от V2 и в их сравнении опережает Qwen-Image-2.0 и Z-Image на BizGenEval и IGenBench.

Лицензия — Apache 2.0.

Модель: https://modelscope.ai/models/SenseNova/SenseNova-U1-8B-MoT-Infographic-V3
Пейпер: https://modelscope.ai/papers/2605.12500
  • 👍 8
  • ❤ 6
  • 🔥 6
Post #2880 9.79K
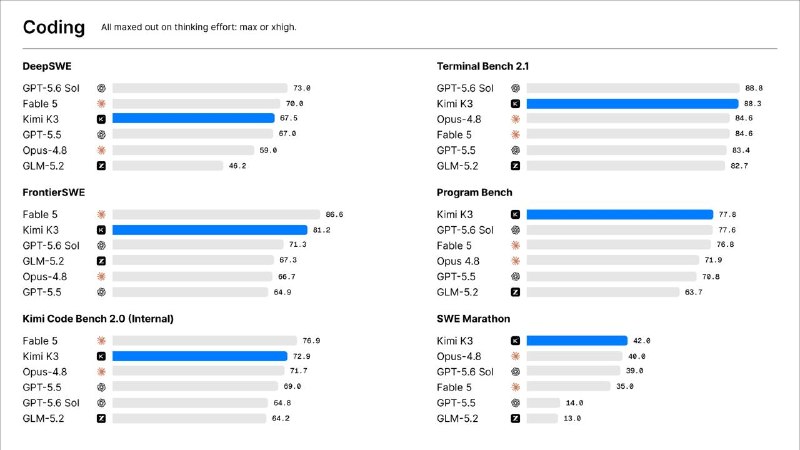
Kimi K3 может стать моментом DeepSeek 2.0

Первые бенчмарки выглядят очень сильно. Kimi K3 уже называют моделью, которая сокращает разрыв между китайскими open-weight моделями и закрытыми флагманами США. FT пишет, что K3 должна превзойти Opus 4.8 в ряде бенчмарков, но при этом всё ещё не дотягивает до закрытой Fable.

Opus 4.8 вышла в конце мая, Anthropic позиционировала её как заметное обновление для agentic-задач, reasoning и работы с инструментами. Если Kimi K3 действительно обходит её в части тестов, тезис «Китай стабильно отстаёт на 6–8 месяцев» становится всё слабее.

Отдельно Kimi-K3 уже вышла на первое место в Frontend Code Arena с 1679 pts, обойдя Claude Fable 5. В frontend она стала №1 в 6 из 7 доменов: Brand & Marketing, Reference-Based Design, Data & Analytics, Consumer Product, Simulations и Content Creation Tools.

Конечно, бенчмарки ещё нужно проверять реальным использованием: coding agents, большие репозитории, 3D, интерфейсы, долгие задачи, стабильность и цена.

Китайские модели всё ближе к frontier-уровню американских закрытых.

Kimi K3 - не Fable и не Mythos. Но она уже слишком близко к топовым западным моделям, чтобы относиться к ней как к «ещё одной open model».


kimi.com/code/docs/en/kimi-code/models

@machinelearning_interview
  • ❤ 23
  • 🔥 7
  • 👍 6
  • 🤩 3
Post #2874 26.7K
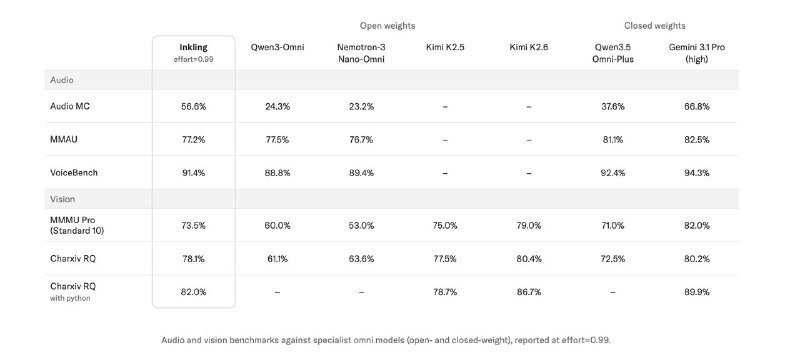
Thinking Machines Lab выкатила Inkling - свою первую open-weights модель.

И это сразу тяжёлый релиз:

* 975B total params
* 41B active
* 1M context
* обучение на 45T токенов
* текст, изображения, аудио и видео
* рядом идёт preview Inkling-Small с 12B active

Они прямо пишут, что Inkling не лидер среди всех open и closed моделей. Ставка другая: дать сильную multimodal базу, которую можно дообучать под свои задачи.

Самая интересная часть - связка с Tinker.

Inkling можно fine-tune’ить прямо на платформе Thinking Machines. В демо модель даже сама написала себе fine-tuning job, обучилась избегать буквы “e” в ответах, прогнала eval и переключилась на новые веса.

То есть они показывают полный контур кастомизации:

модель → задача → данные → fine-tune → eval → новые веса.


Похоже, Thinking Machines строит фабрику моделей под конкретные продукты.

https://thinkingmachines.ai/news/introducing-inkling/
  • ❤ 12
  • 👍 5
  • 🤣 4
  • 🔥 3
  • 😈 2
Post #2873 4.02K
🚀 Anthropic выложили reference harness для поиска и исправления уязвимостей с Claude

Очень недооценённый репозиторий для defensive security.

Идея простая: Claude проходит полный цикл работы с уязвимостью:

* threat model
* поиск подозрительных мест
* проверка
* triage
* отчёт
* патч

Внутри есть Claude Code skills вроде /vuln-scan, /triage и /patch, которые можно запускать интерактивно.

Есть и автономный harness: можно настроить цель, ограничения и дать агенту самому пройти цикл анализа.

https://github.com/anthropics/defending-code-reference-harness
  • 👍 9
  • ❤ 7
  • 😁 3
Post #2872 4.82K
Кто-то только что переписал 40 лет PostgreSQL с нуля на Rust.

И он уже проходит 100% официальных тестов Postgres.

Проект называется pgrust.

Это не форк, а полная реализация с нуля, которая уже проходит все 46 066 запросов из официального тестового набора PostgreSQL 18.3.

Postgres разрабатывается уже 40 лет, и некоторые архитектурные решения из 80-х до сих пор приводят к сбоям:

- один поток на соединение, фактически отдельный OS-процесс на пользователя
- 350+ параметров настройки, которыми нужно управлять вручную
- один только VACUUM стал причиной тысяч инцидентов

pgrust выбрасывает всё это и начинает заново.

Что уже работает:

- проходит 96% regression suite PostgreSQL
- psql подключается из коробки, есть совместимость с wire protocol
- query planner, buffer cache, storage engine, B-tree индексы
- JSON/JSONB, window functions, foreign keys, EXPLAIN ANALYZE, regex
- тот же движок компилируется в WebAssembly и запускается прямо в браузере на pgrust.com

100% open source.

https://github.com/malisper/pgrust
  • 🔥 49
  • 🤔 12
  • 👍 3
  • 🙈 3
  • 🥰 2
  • 😁 2
Post #2870 3.83K
Sakana AI показали “умные кирпичи”, которые понимают свою форму и находят повреждения

Звучит как sci-fi, но это уже опубликованная работа в Nature Communications.

Исследователи собрали простые кубические модули. У каждого — одинаковая маленькая нейросеть, связь только с соседними блоками и никакой карты всей конструкции.

Но вместе они могут определить, во что собраны: стол, лодку, самолёт, гитару и другие формы.

Cистеме не нужен центральный контроллер. Ни один “кирпич” не знает, где он находится. Глобальная картина появляется из локальных сообщений между соседями.

Что умеют Smart Cellular Bricks:

* распознавать общую 3D-форму
* работать при шумной связи
* переживать отказ части модулей
* находить, где структура повреждена
* подсказывать, куда нужно добавить новые блоки для восстановления

Это похоже на то, как живые ткани самоорганизуются и восстанавливаются после повреждений.

Пока это не “здание, которое само себя чинит”, а исследовательский прототип. Но направление мощное: материалы и конструкции, которые сами понимают свою конфигурацию, замечают поломки и помогают себя ремонтировать.
  • 🔥 20
  • 👍 10
  • 🥰 2
Post #2869 3.67K
⚡️ OpenChronicle - локальная память для AI-агентов

Одна из главных проблем AI-агентов: они быстро теряют контекст.

Сегодня вы обсуждали проект, архитектуру, людей, решения и инструменты. Завтра агент снова спрашивает: «А что мы делаем?»

OpenChronicle пытается закрыть эту дыру.

Он запускается на Mac, смотрит на рабочий контекст и превращает его в постоянную Markdown-память:

* проекты
* решения
* инструменты
* людей
* последние действия
* важные рабочие детали

Память хранится локально, её можно открыть и прочитать руками. Под капотом - Markdown на диске и SQLite.

https://github.com/Einsia/OpenChronicle
  • 👍 8
  • 🤣 8
  • ❤ 6
  • 🤔 2
  • 🔥 1
Post #2867 3.91K
WTF: Apple подала в суд на OpenAI из-за предполагаемой кражи коммерческой тайны.

Компания утверждает, что OpenAI якобы вела скоординированную кампанию по получению конфиденциальной информации о ещё не выпущенных продуктах Apple для собственного AI-железа.

В иске упоминаются глава hardware-направления OpenAI Тан Тан, бывший VP по продуктовому дизайну Apple, и бывший инженер Apple Чан Лю.

Apple заявляет, что Лю скачал десятки конфиденциальных файлов по hardware-разработкам.

Также компания утверждает, что OpenAI поощряла уходящих сотрудников делиться материалами, чертежами и информацией о продуктах.

По данным иска, сейчас в OpenAI работают более 400 бывших сотрудников Apple.

Apple требует, чтобы OpenAI уничтожила эти материалы и переработала будущие устройства, если в них используется её технология.

На момент публикации Bloomberg OpenAI ещё не ответила.

https://www.bloomberg.com/news/articles/2026-07-10/apple-sues-openai-for-trade-secret-theft-in-blockbuster-case
  • 🤣 14
  • 🔥 4
  • ❤ 3
  • 👍 2
Post #2866 4.05K
🧠Сравнение методов дообучения LLM: что действительно влияет на качество

Исследователи лаборатории научных исследований группы «Т-Технологии» представили на ICML 2026 единый подход к сравнению методов дообучения больших языковых моделей, обучающихся на парах ответов.

Подход позволяет привести разные алгоритмы к одинаковым условиям и понять, что именно влияет на качество. Главный вывод работы: решающим фактором является способ ранжирования ответов: попарный или поточечный.

Идея простая:
• разные методы обычно сравниваются в разных условиях
• исследователи привели их к единому протоколу сравнения, чтобы выровнять условия экспериментов и сделать результаты сопоставимыми
• дополнительно исследователи ввели параметр β, который регулирует силу дообучения на человеческих предпочтениях и позволяет более корректно сравнивать методы.

В результате оказалось, что ключевую роль играет именно тип ранжирования ответов. Когда модель выбирает лучший вариант из пары, качество оказывается выше, чем при оценке каждого ответа по отдельности.

🔗Статья: https://arxiv.org/pdf/2502.01237
  • 👍 31
  • 🔥 2
  • ❤ 1
Post #2864 3.97K
Goldman Sachs: использование токенов AI-агентами может вырасти в 24 раза к 2030 году.

AI-агенты становятся первым серьёзным тестом на стоимость для всего AI-бума. На этой неделе уже писали, что Uber и Microsoft пересматривают дорогие сценарии использования агентов.

Обычный чат-бот может просто ответить один раз.

А агент планирует, вызывает инструменты, проверяет результат, исправляет ошибки и снова повторяет цикл.

Из-за этого один пользовательский запрос может съесть в 10 раз, 50 раз или даже намного больше токенов, чем обычный ответ.

Бычий сценарий Goldman Sachs: месячное потребление может дойти до 120 квадриллионов токенов к 2030 году, при этом стоимость inference за токен будет падать на 60–70% в год.
  • 👍 7
  • ❤ 6
  • 🔥 4
  • 😁 1
Post #2863 3.94K
Gemma 4 Technical Report

Gemma 4 - новая открытая мультимодальная линейка моделей Google.

Она умеет рассуждать, читать изображения, понимать аудио, работать с длинным контекстом и эффективно запускаться в разных размерах от 2.3B до 31B параметров.

Модели E2B и E4B с эффективным размером 2.3B и 4B примерно догоняют или обгоняют Gemma 3 27B, используя примерно в 10 раз меньше параметров.

Аудиоэнкодер стал на 78% меньше, а KV-cache для длинного контекста удалось сократить до 37.5%.

E4B даже обходит Gemma 3 27B на long-context benchmark RULER 128k: 86.6 против 66.0.

Интересная деталь: 12B-модель не использует отдельные vision и audio encoders. Вместо этого она напрямую подаёт image patches и audio chunks в LLM.

А 31B-модель стала лучшей dense open model в Arena Text. При этом 26B MoE активирует всего 3.8B параметров и всё равно набирает 1438 Elo.

https://www.alphaxiv.org/abs/2607.02770
  • 👍 7
  • 🔥 7
  • ❤ 4
Post #2862 3.91K
DeepSeek разрабатывает собственный inference-чип, чтобы снизить зависимость от NVIDIA и Huawei на китайском рынке AI-чипов объёмом около $50 млрд.

Пока проект на ранней стадии: компания работает с внешними партнёрами и в закрытом режиме нанимает инженеров по chip design.

Продвинутые фабрики и HBM-память остаются узкими местами, потому что ограничения США режут Китаю доступ к ключевым технологиям.

Но у DeepSeek всё равно есть сильный сценарий: сделать более узкий чип под собственные модели.

Такой кастомный inference-чип может снизить стоимость обслуживания моделей, уменьшить энергопотребление и дать компании больше контроля над связкой софт + железо.

reuters.com/world/china/chinas-deepseek-developing-its-own-ai-chip-sources-say-2026-07-07/
  • 🔥 9
  • 👍 3
  • ❤ 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →