
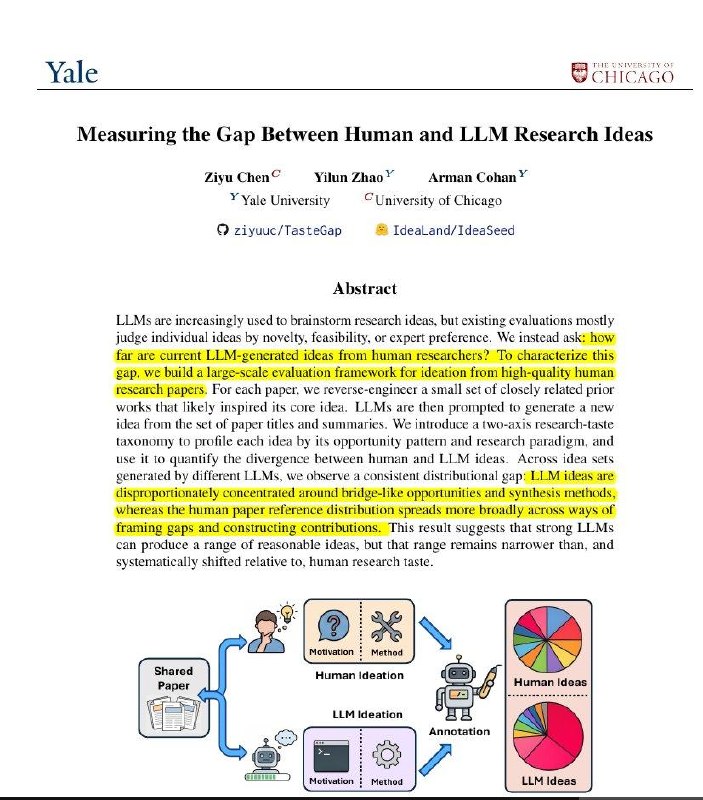
LLM придумывают исследования заметно уже людей
Исследователи сравнили идеи девяти моделей с идеями из 11 683 реальных научных работ. Условия были одинаковыми: и людям, и LLM давали один набор близких предыдущих исследований и просили найти новый научный вопрос и предложить метод.
Разница оказалась не столько в качестве отдельной идеи, сколько в разнообразии подходов.
Люди чаще искали причины явлений, проверяли ограничения, меняли отдельные механизмы, создавали инструменты измерения и изучали сбои. Модели в основном выбирали безопасный сценарий: соединить две существующие работы или объединить несколько методов.
Такую мотивацию использовали только 12,1% человеческих идей, но от 47,1% до 64,2% идей LLM. Синтез и объединение стали основным методом в 5,1% человеческих работ против 22,5–38,7% у моделей.
Показательный результат: более долгое рассуждение не расширило диапазон идей. В некоторых тестах модели ещё сильнее концентрировались на знакомых шаблонах.
LLM могут быстро выдать убедительную научную гипотезу. Но при массовом использовании они рискуют снова и снова предлагать одну формулу: возьмём A, соединим с B и назовём это новым методом.
Исследование показывает важное ограничение AI Scientist: модель может хорошо развивать найденное направление, но выбор самого направления пока остаётся заметно человеческой задачей.
arxiv.org/abs/2607.01233
Post #2921
4.32K
- 👍 33
- 😁 7
- ❤ 4
- 🤔 3
- 🔥 2
- 💯 2
- 🙈 2
- 🤗 2