
🚀🚀🚀 Tencent открыли HPC-Ops — продакшн-библиотеку операторов для LLM-инференса, выжимающую максимум из GPU
HPC-Ops — это библиотека операторов от Tencent HY, созданная для достижения пиковых показателей производительности на массовых inference-картах. Решает главную боль продакшена: стандартные библиотеки часто не доходят до реального потолка железа.
Главные плюсы
🔹 +30% к пропускной способности
- До +30% QPM для моделей Tencent HY
- +17% для DeepSeek в реальных продакшн-сценариях
🔹 Оптимизация под железо
С нуля написано на CUDA + CuTe, чтобы максимально загрузить GPU и убрать узкие места типичных стеков.
🔹 SOTA по ядрам
- Attention — до 2.22× быстрее, чем FlashInfer / FlashAttention
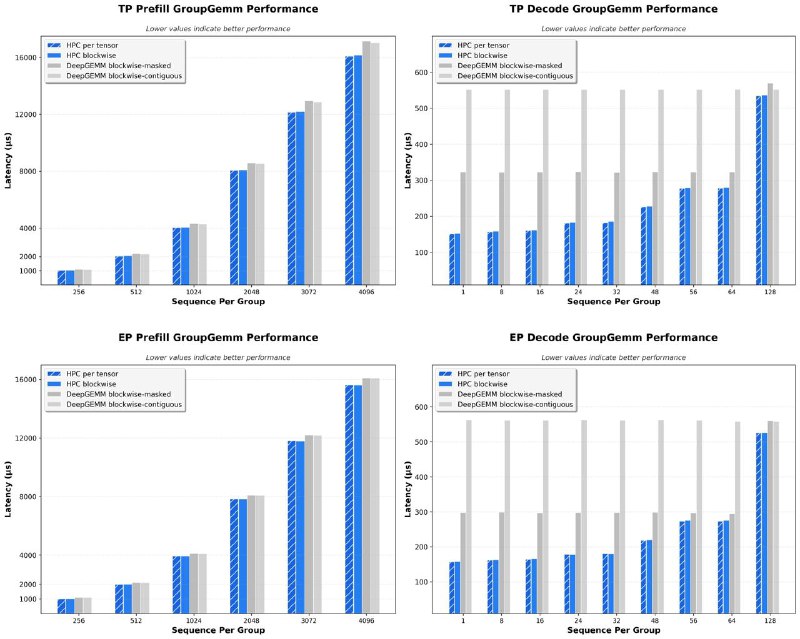
- GroupGEMM — до 1.88× быстрее, чем DeepGEMM
- FusedMoE — до 1.49× быстрее, чем TensorRT-LLM
🔹 Готово к продакшену
- Поддержка ключевых операторов: FusedMoE, GroupGEMM
- Многонодовая коммуникация
- Чистая абстракция для кастомизации под свои пайплайны
Библиотека уже используется в крупномасштабных инференс-сервисах Tencent.
Если вы крутите LLM в проде и упёрлись в пределы производительности — это как раз тот слой, где можно вытащить дополнительные десятки процентов без смены железа.
🔗 GitHub: https://github.com/Tencent/hpc-ops
Post #2519
4.88K


- ❤ 10
- 👍 5
- 🔥 3
- 👏 2