
🚀 QWEN представили SAPO - Soft Adaptive Policy Optimization.
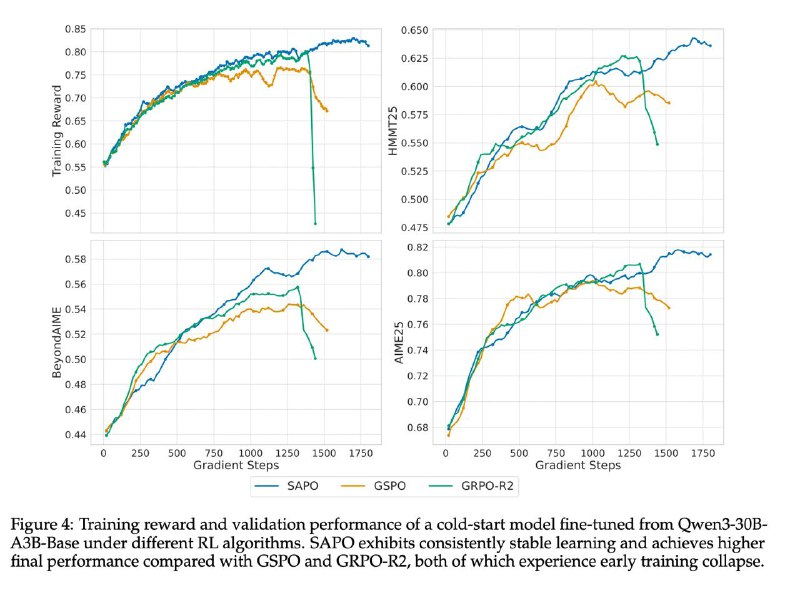
Новый метод обучения LLM, делающий RL-тюнинг более стабильным и масштабируемым.
Зачем он нужен?
🔹 Жёсткое ограничение градиентов часто ломает обучение, то они исчезают, то взрываются .
🔹 В MoE-моделях эта нестабильность усиливается ещё больше
Что делает SAPO:
✓ вместо резких границ - плавный «температурный» контроллер
✓ более мягкая зона доверия - без внезапного обнуления градиентов
✓ согласованное поведение на уровне последовательности
✓ адаптация на уровне токенов - сохраняет полезные сигналы и ускоряет обучение
✓ асимметричные температуры - сильный выигрыш по стабильности, особенно для MoE
Что это даёт:
📌 длинные стабильные RL-тренировки
📌 выше точность (Pass@1)
📌 заметный прирост в задачах математики, кода и мультимодальности (например, на Qwen3-VL)
SAPO - шаг к более надёжному и предсказуемому RL-тюнингу больших моделей.
📄 Paper: https://arxiv.org/abs/2511.20347
📚 Blog: https://qwen.ai/blog?id=sapo
🔍 Видео: https://www.youtube.com/watch?v=aQyzIzUw9zI
Post #2404
4.21K


- ❤ 11
- 👍 5