
MIT + Harvard + Google DeepMind показали, почему обычные трансформеры почти не умеют в многозначное умножение — и как это починить одной идеей
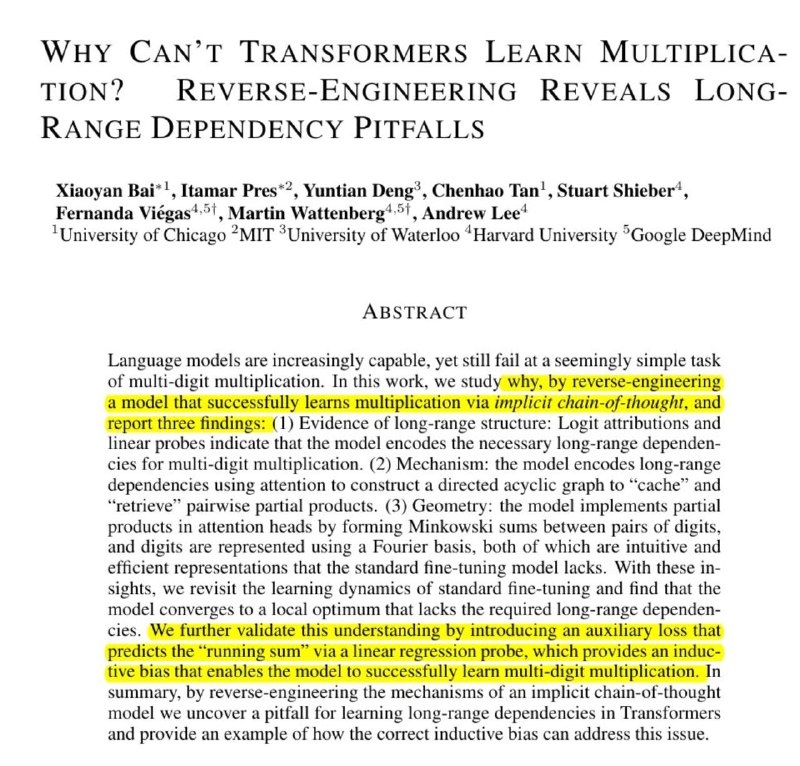
Команда обучила два маленьких Transformer-а считать 4-значное × 4-значное умножение.
Первый - с методом implicit chain-of-thought (ICoT): модель сначала видит все промежуточные шаги вычисления, а затем эти шаги постепенно убирают.
То есть модель вынуждают “думать внутри себя”, а не на видимых подсказках.
Результат: 100% точность на всех примерах.
Второй - обычное обучение: вход → ответ, без промежуточных шагов.
Результат: около 1% правильных ответов.
Почему так?
- Многозначное умножение требует длинных зависимостей
- Нужно запоминать и переносить “сумму + перенос” между разными позициями
- Модель должна хранить промежуточные частичные произведения и возвращаться к ним позже
- Рабочая модель формирует “бегущую сумму” и carry, как человек
- Внутри attention появляется структура наподобие небольшого бинарного дерева
- Представления цифр формируют особое пространство (пятилучевая призма + Fourier-код)
Обычное обучение захватывает “краевые” цифры и застревает — не может связать середину.
ICoT даёт правильный inductive bias: заставляет модель строить внутренний алгоритм, а не угадывать шаблон.
Главная идея: чтобы ИИ делал арифметику (и, возможно, логику), ему нужен скрытый расчётный процесс, а не просто больше данных.
Это шаг к пониманию того, как обучать модели *думать*, а не просто *запоминать*.
Post #2299
4.69K
- 🔥 34
- 👍 5
- ❤ 2
- 👌 2
- 🥰 1