
⚡ Что такое vLLM и зачем он нужен?
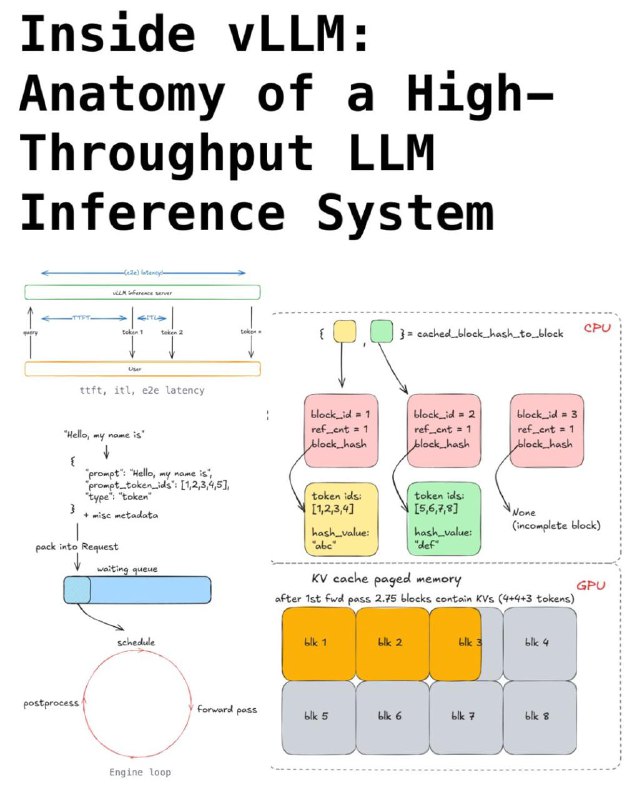
Это движок для сверхбыстрого инференса больших языковых моделей. В блоге Алески Гордича разобрали, как он устроен под капотом.
Главные фишки:
• KV-cache с paged attention — умно хранит память, чтобы модель не тормозила на длинных запросах.
• Continuous batching — новые запросы можно подмешивать прямо во время работы, без ожидания.
• Оптимизации:
• chunked prefill — длинные промпты режутся на куски, чтобы не блокировать других
• prefix caching — общий префикс считается один раз, а не заново для всех
• guided decoding — модель пишет строго по правилам (например, JSON)
• speculative decoding — маленькая модель «накидывает» текст, большая подтверждает.
• Масштабирование: работает и на одной видеокарте, и на кластере из десятков.
• Автотюнинг и бенчмарки: встроенные тесты подбирают оптимальные настройки под SLA.
Итог: vLLM — это уже не просто библиотека, а полноценная архитектура для работы LLM в проде: быстрая, гибкая и экономная.
🟠Подробный разбор: https://www.aleksagordic.com/blog/vllm
@machinelearning_interview
Post #2141
4.06K
- 👍 25
- ❤ 8
- 🔥 5