
🚀 Fantastic Pretraining Optimizers and Where to Find Them
Исследователи проектировали 10 оптимизаторов на моделях от 0.1B до 1.2B параметров и разных объёмах данных (1–8× Chinchilla).
Что выяснили:
- ⚡ Muon и Soap — самые быстрые, они используют матрицы вместо скаляров.
- ➕ Прирост скорости есть, но он падает с масштабом: от 1.4× быстрее AdamW на маленьких моделях до всего 1.1× на больших.
- 🔧 Настройки гиперпараметров не переносятся между оптимизаторами.
- 📉 По ранним кривым лосса нельзя судить о финальном качестве.
- ⚖ Оптимальный выбор зависит от того, сколько данных на модель.
👉 Итог: новые оптимизаторы реально полезны на малых моделях, но на больших их преимущество почти исчезает.
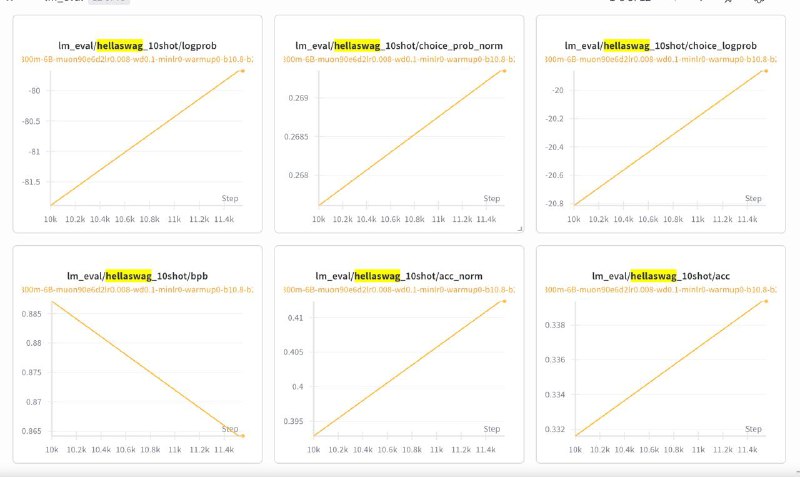
Подробнее: wandb.ai/marin-community/optimizer-scaling
Post #2140
3.94K
- ❤ 12
- 👍 6
- 🔥 6