
🎙 Microsoft представила VibeVoice-Large — open-source TTS модель для выразительных, продолжительных диалогов (и подкастов).
Что делает её особенной:
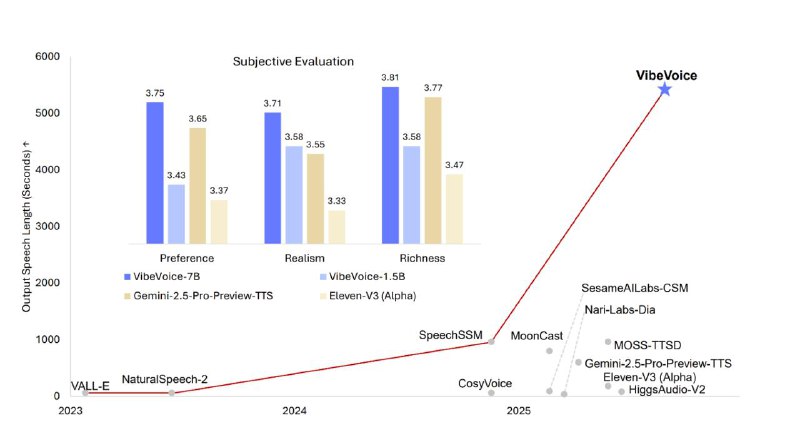
- Синтезирует до 45 минут речи с четырьмя разными голосами — намного больше, чем у большинства моделей.
- Использует continuous acoustic & semantic tokenizers с низкой частотой (7.5 Hz) для высокого качества и эффективности на длинных аудио.
- Основа — LLM (Qwen 2.5) + diffusion head для генерации деталей речи (около 600M параметров).
- Генерация до ~45 минут при контексте до 32K токенов.
Технические детали:
- 9.34B параметров
- Тип тензоров — BF16
- MIT-лицензия
Ограничения и меры безопасности:
- Только для исследований, не для коммерции
- Запрещено использовать для голосового клонирования без разрешения или создания фейков
- Встроенный дисклеймер *“This segment was generated by AI”*
- Водяной знак для подтверждения происхождения
Полезные ссылки:
- Репозиторий: https://huggingface.co/microsoft/VibeVoice-Large
- Код: https://github.com/microsoft/VibeVoice
⚡️ VibeVoice-Large — шаг вперёд в генерации естественных, длительных диалогов с несколькими голосами.
@machinelearning_interview
Post #2139
4.12K
- 👍 14
- ❤ 6
- 🥰 3