
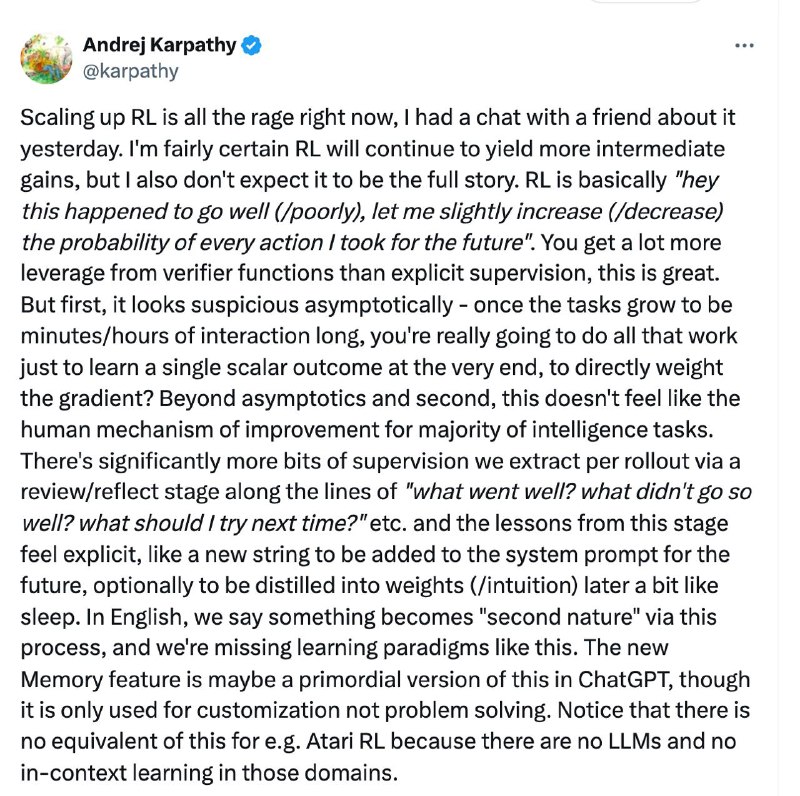
🧠 Андрей Карпаты выпустил интересный пост о масштабировании RL.
Все говорят о масштабировании RL — и не зря. Но ощущение, что это только часть большой картины.
Вчера обсуждали с другом: Reinforcement Learning даёт более масштабируемую обратную связь, чем SFT, и это действительно мощный рычаг. Вместо явных меток — просто: "получилось хорошо → усилим действия", "плохо → ослабим". Но...
🔸 Проблема №1 — асимптотика
Как только задача выходит за пределы секунд и становится минутами/часами взаимодействий, RL сводится к тому, что ты делаешь тонну действий, чтобы в конце получить одну скалярную метку — и по ней обновить весь градиент? Это кажется неэффективным.
🔸 Проблема №2 — не по-человечески
Мы (люди) улучшаемся не только по результату "успех/провал". Мы рефлексируем:
- Что сработало?
- Что нет?
- Что стоит попробовать в следующий раз?
Этот "урок" мы потом либо держим в голове, либо записываем. Он становится частью интуиции или инструкции. В языке это называют *second nature*.
И таких механизмов в обучении ИИ пока нет.
🔍 Пример алгоритма:
1. Несколько rollout'ов
2. Все примеры + награды → в один контекст
3. Промпт на рефлексию: *"Что сработало? Что улучшить?"*
4. Сгенерированная строка → системный промпт или база "уроков"
Это и есть lesson-инъекция. Например, в Claude было явно прописано:
> "Если тебя просят посчитать буквы — раздели по запятым и считай по одному"
Это патч-урок, не выученный, а вручную внедрённый. Вопрос: как заставить агента учить такие уроки сам? И — как потом их дистиллировать, чтобы не раздувать контекст?
🧭 TLDR:
- RL будет давать приросты — оно более “горькое”, но и более leverage‑friendly, чем SFT
- Но это не вся история
- Реальные "S-кривые" могут скрываться в новых парадигмах обучения, которые специфичны для LLM и не похожи на Atari или роботов
- Возможно, "рефлексия → урок → встроенная привычка" — это один из недостающих слоёв в современных системах
#AI #RL #LLM #agenticlearning #meta #reinforcementlearning
@machinelearning_interview
Post #1952
11.2K
- 👍 26
- ❤ 15
- 🔥 4
- 🍓 4
- 🤪 1