

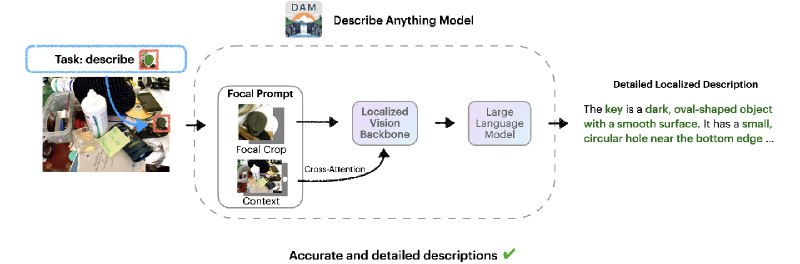
Describe Anything Model (DAM) - архитектура, разработанная Nvidia, для генерации точных и детальных описаний для конкретных областей на изображениях и видео. Традиционные VLM-модели как отдельная сущность или в связке с SAM-помощниками часто теряют ньюансы, особенно при наличии мелких объектов или динамичных сцен на целевом источнике.
DAM справляется с этим за счет 2 инноваций в своей архитектуре:
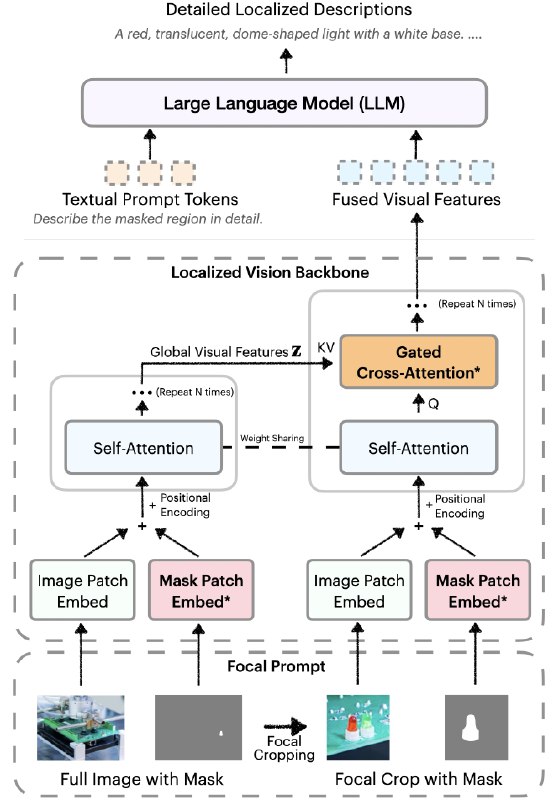
🟢Фокальный промпт — комбинация полного изображения и его маски с обрезанной областью интереса, расширенной для захвата контекста (например, увеличение bounding box в 3 раза).
🟢Локализованный визуальный бэкбон — два параллельных энкодера: глобальный (обрабатывает все изображение) и региональный (анализирует фокальный промпт). Они объединяются механизм cross-attention, позволяя сохранять детали объекта и его связь с окружением.
Модель принимает изображение или видео и бинарную маску целевой области интереса. Глобальный энкодер извлекает общие признаки, региональный — фокусируется на деталях выбранной зоны. Через адаптеры с кросс-вниманием признаки объединяются, после чего LLM генерирует описание. Для видео маски применяются к каждому кадру, а признаки агрегируются во времени.
▶️В релизе DAM представлены 3 модели:
🟠DAM-3B - базовая модель для аннотирования изображений;
🟠DAM-3B-Video - модель для работы с видео;
🟠DAM-3B-Self-Contained - автономная версия базовой модели для интеграций без сторонних зависимостей.
▶️Локальный инференс с интерактивным Gradio WebUI:
# Clone the repo
git clone https://github.com/NVlabs/describe-anything
cd describe-anything

# Create a conda env
conda create -n describe-anything
conda activate describe-anything

# Install dependencies
pip install -v

# Gradio Demo for Image Descriptions
python demo_simple.py

# Gradio Demo for Video Descriptions
python demo_video.py
📌Лицензирование моделей: NVIDIA Noncommercial License.
📌Лицензирование кода : Apache 2.0 License.
🟡Страница проекта
🟡Набор моделей
🟡Demo
🟡Arxiv
🖥GitHub
@ai_machinelearning_big_data
#AI #ML #DAM #NVIDIA #Annotation