TGViewer
Channel Public Channel
Машиннное обучение | Наука о данных Библиотека

Машиннное обучение | Наука о данных Библиотека

@machinelearning_books

админ - @workakkk

@ai_machinelearning_big_data - Machine learning

@itchannels_telegram - 🔥лучшие ит-каналы

@pythonl - Python

@pythonlbooks- python книги📚

@datascienceiot - ml книги📚

№ 5037635661
Subscribers
16.8K
Photos
1K
Videos
23
Links
851

Showing posts older than #983 · Back to latest

Older Posts 9 shown
Post #981 2.75K
⚡️ Implement minimal-GPT from scratch.

MinimalGPT — это небольшое учебное пособие (гайд), в котором демонстрируется «упрощённая» реализация архитектуры GPT. На странице раскрываются основные принципы работы модели и приводится минимально необходимый код для её запуска. Основная идея заключается в том, чтобы показать, как устроена GPT‑модель на базовом уровне, без избыточного усложнения и обилия вспомогательных библиотек.

Внутри гайда обычно можно найти:

▪ Описание основных слоёв GPT (внимание, Feed-Forward блоки и т.д.)
▪ Минимальные примеры кода (часто на Python с использованием PyTorch или аналогичных фреймворков)
▪ Краткие пояснения к каждому этапу (инициализация слоёв, механизм attention, обучение/инференс)
▪ Рекомендации по расширению и дальнейшему совершенствованию кода

Таким образом, MinimalGPT служит отправной точкой для понимания того, как работает GPT, и даёт возможность собрать простейшую версию модели своими руками.

🔗 Читать

@machinelearning_books
  • 🔥 7
  • 👍 5
  • ❤ 4
  • 💩 1
Post #980 3.36K
🔥 «Упражнения по машинному обучению»

В этой книге более 75 упражнений. И она абсолютно БЕСПЛАТНА.

🔗 Книга
🔗 GitHub

@machinelearning_books
  • 🔥 9
  • 👍 5
  • 🥰 2
Post #979 2.96K
📚 «Линейная алгебра»

Вторая лучшая книга по линейной алгебре с ~1000 практических задач.

Идеально для ИИ и машинного обучения.

Книга полностью бесплатна .

Прекрасно подходит для новичков.

📌 Книга

@machinelearning_books
  • 👍 6
  • ❤ 2
  • 🔥 2
Post #978 2.15K

Forwarded from Machinelearning

✔️ "Speech and Language Processing": 3-е издания книги

Этот открытый учебник считается де-факто стандартом и одним из самых авторитетных и всеобъемлющих ресурсов для изучения областей обработки естественного языка (NLP), вычислительной лингвистики и обработки речи.

🌟 Авторы: Дэн Джурафски и Джеймс Х. Мартин - известные фигуры в области NLP и вычислительной лингвистики. Книга считается классическим текстом, обновленным для включения современных методов, таких как трансформеры, которые доминируют в области NLP.

Книга разделена на три части, включающие 24 основные главы и 8 приложений.

Темы охватывают широкий спектр, включая:
😶Фундаментальные алгоритмы
😶Приложения NLP (Обработки Естественного Языка)
😶Регулярные выражения
😶Нейронные сети и трансформеры,
😶Машинный перевод и другие аспекты NLP
😶Аннотирование (или Разметка) лингвистической структуры.

Для каждой главы доступны слайды в форматах PPTX и PDF, что делает ресурс полезным для преподавателей.

Для всех, кто заинтересован в изучении NLP это фантастически полезный ресурс.

🟡Книга в PDF
🟡Все Главы
🟡Еще книги по NLP

@ai_machinelearning_big_data


#freebook #opensource #nlp
  • 👍 9
  • ❤ 3
Post #976 2.83K
Mathematics for Computer Science

Бесплатный учебник от CRC Press объемом 547 страниц.

📚 Книга
  • ❤ 9
  • 👍 5
  • 🔥 3
Post #966 4.08K

Forwarded from Machinelearning

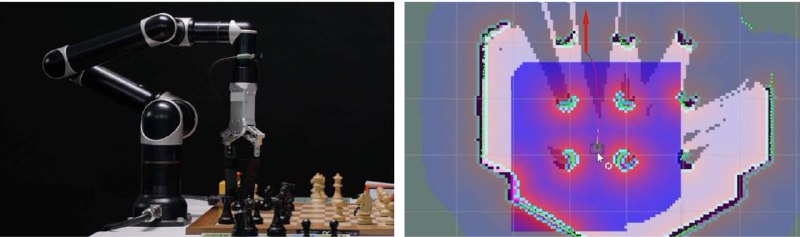
🤖 Modern Robotics Course: Открытый курс по современной робототехнике.

Курс сочетает теорию (математика, физика) и практику (код, симуляторы), помогая разработчикам научиться создавать и программировать роботов.

🌟 Что внутри?
▪ Лекции: От основ робототехники, математики и физики до пространственных преобразований, обратной кинематике и более продвинутым концепциям .
▪ Практика: Примеры кода на Python и C++ для управления роботами.
▪Симуляторы: Интеграция с стимуляторами Gazebo и ROS ( операционная система для робото) для тестирования алгоритмов.
▪Задания: Реальные практические задачи (например, управление манипулятором робота).

🌟 Для кого?
▪ Начинающие робототехники: Освоить кинематику, динамику, управление.
▪ Программисты: Интегрировать алгоритмы в ROS, Gazebo, Python/C++.
▪ Инженеры: Возможность Научиться разрабатывать автономные системы и манипуляторы.
▪Технологические энтузиасты

С курсом можно пройти путь от нуля до создания рабочего прототипа.

С курсом у вас будет возможность проектировать роботов, не имея железа под рукой (через симуляторы).

✔️ Готовые решения: Внутри вы найдете библиотеки для работы с преобразованиями, датчиками, движением.

✔️Карьера в робототехнике: Курс даст возможность получить базовые навыки, востребованные в Bosch, Boston Dynamics, Tesla.

⭐️ Преимущества перед другими открытыми курсами
🟠 Акцент на практике: Минимум абстракций — максимум кода.
🟠Совместимость с ROS: Стандарт для промышленной робототехники.
🟠 Современные алгоритмы: Не только классика, но и нейросетевые подходы.

➡️ Cовет: Для погружения в курс, вам поможет книга Robotics, Vision and Control: Fundamental Algorithms in Python, Peter Corke, вот ее репозиторий с примерами кода.

P.S. Для тех, кто любит формат «сделай сам»: Курс научит вас собирать робота виртуально, а потом переносить решения на реальные устройства. 🤖💡

✔️ Github
✔️ Введение в курс

#course #ai #ml #robots #education #курс #робототехника
  • ❤ 10
  • 🔥 5
  • 👍 2
  • 🥰 1
Post #964 2.52K
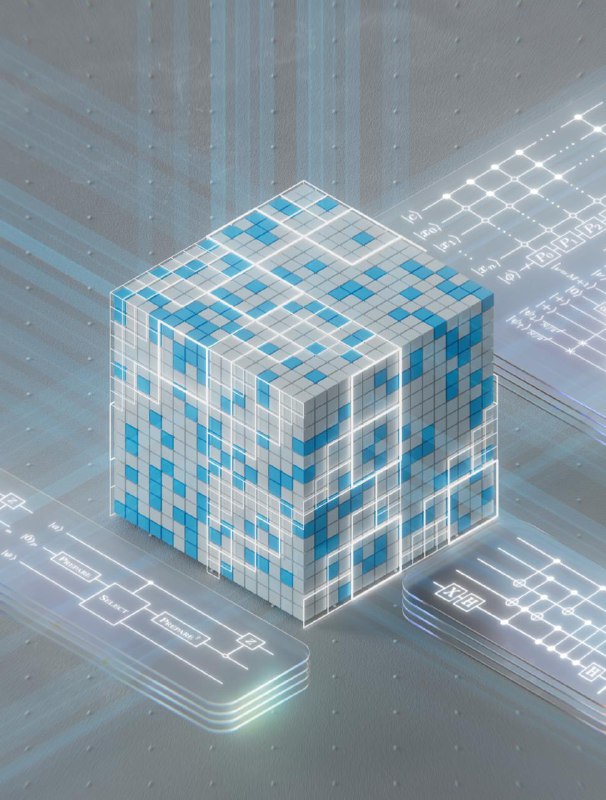
✅ Google опубликовали статью, где описано как ИИ система AlphaTensor-Quantum может сделать квантовые вычисления облее эффективными. 🖥️⚡

Оптимизируя квантовые схемы, она помогает выполнять вычисления быстрее, чтобы экономить ресурсы и ускорять открытия. ↓

🎯 Читать

@machinelearning_books
  • ❤ 5
  • 👍 2
  • ✍ 1
  • 👎 1
Post #963 2.27K
📌 Статья Google Research предлагает метод генерации синтетических данных с использованием дифференциально приватного вывода LLM, чтобы исключить утечки информации из исходного датасета.

Вот ключевые аспекты:

🎯 Цель
Создание синтетических данных, которые:

Сохраняют полезные статистические свойства оригинальных данных.

Гарантируют, что исходные данные нельзя восстановить из сгенерированных образцов.

🔧 Метод
Дифференциально приватный инференс:


Во время генерации текста LLM к выходным распределениям токенов добавляется шум (например, через механизм Гаусса).

Это гарантирует, что наличие/отсутствие отдельного примера в обучающих данных не влияет на результат.

Контроль приватности:

Параметры ε (эпсилон) и δ (дельта) задают уровень приватности.

Чем меньше ε, тем выше защита (например, ε=1–5).

Адаптация под LLM:
Оптимизация добавления шума для сохранения качества текста (согласованность, грамматика).

Использование калибровки шума в зависимости от чувствительности модели к входным данным.

🚀 Технические детали
Механизм шума:
Шум добавляется к логам вероятностей модели перед выборкой токена.

Усечение градиентов: Для ограничения влияния отдельных примеров на обучение (если модель дообучается).

Аггрегирование запросов: Группировка запросов к модели для минимизации утечек через множественные обращения.

📊 Результаты
Качество данных: Синтетические данные сохраняют практическую применимость (например, для обучения downstream-моделей).

Приватность: Гарантируется формальная защита (ε < 5) без значительной деградации качества.

🛠 Применение
Обучение моделей на конфиденциальных данных (медицина, финансы).

Тестирование алгоритмов без доступа к реальным данным.

Совместное использование данных между организациями без риска утечек.

⚖️ Компромиссы
Качество vs. приватность: Чем ниже ε, тем хуже качество текста.

Вычислительные затраты: Добавление шума и проверка приватности увеличивают время инференса.

Итог:
Подход Google позволяет использовать LLM как «дифференциально приватный генератор», что открывает путь к этичному использованию ИИ в sensitive-доменах. Это прорыв в балансировке между полезностью данных и защитой приватности.

Читать
  • 👍 10
  • ❤ 4
  • 🔥 2
Post #954 1.94K

Forwarded from Machinelearning

⭐️ «Open-Source Handwritten Signature Detection Model» - отличная статья, в которой подробно показно решение прикладной ML задачи.

Это подробный гайд, где описан процесс разработки приложения для автоматического обнаружения рукописных подписей в документах.

▶️ Автор протестировал все доступные модели YOLO и показал как их развертывать.

В итоге получился очень годный гайд, со множеством технических деталей.

🟡Подготовка данных: использование двух публичных датасетов (Tobacco800 и Signatures-XC8UP) с последующей предобработкой и аугментацией изображений.

🟡Архитектурное сравнение: в статье приводится детальный анализ современных алгоритмов обнаружения объектов – от семейства YOLO до трансформерных моделей (DETR, RT-DETR, YOLOS).

🟡Оптимизация гиперпараметров:
Сравнительный анализ архитектур показал, что YOLOv8 - обеспечивает идеальный баланс между скоростью и точностью для данной задачи, достигая 94,74 % точности и 89,72 % после оптимизации гиперпараметров с помощью Optuna.

🟡Развёртывание: модель оптимизирована для работы с Triton Inference Server и OpenVINO, что обеспечивает быстрый инференс на CPU и GPU (до 7.657 мс на T4)

🟡 Результаты экспериментов:
Достигнута высокая точность распознавания: mAP@50 – 94.50%, mAP@50-95 – 67.35%.

Итоговая модель демонстрирует сбалансированное соотношение между точностью, скоростью инференса и экономичностью ресурсов.

Статья демонстрирует, как грамотное сочетание современных архитектур обнаружения объектов, тщательная подготовка данных и оптимизация гиперпараметров позволяет создать эффективное и готовое к развёртыванию решение, очень рекомендуем прочесть ее полностью.
А здесь можно почитать описание семейства моделей Yolo.

🟡 Читать: https://huggingface.co/blog/samuellimabraz/signature-detection-model

#yolo #guide #detection #ml
  • ❤ 7
  • 👍 6
  • 🔥 2
  • ❤‍🔥 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →