
NVIDIA показала, что 4-bit обучение LLM больше не выглядит безумием
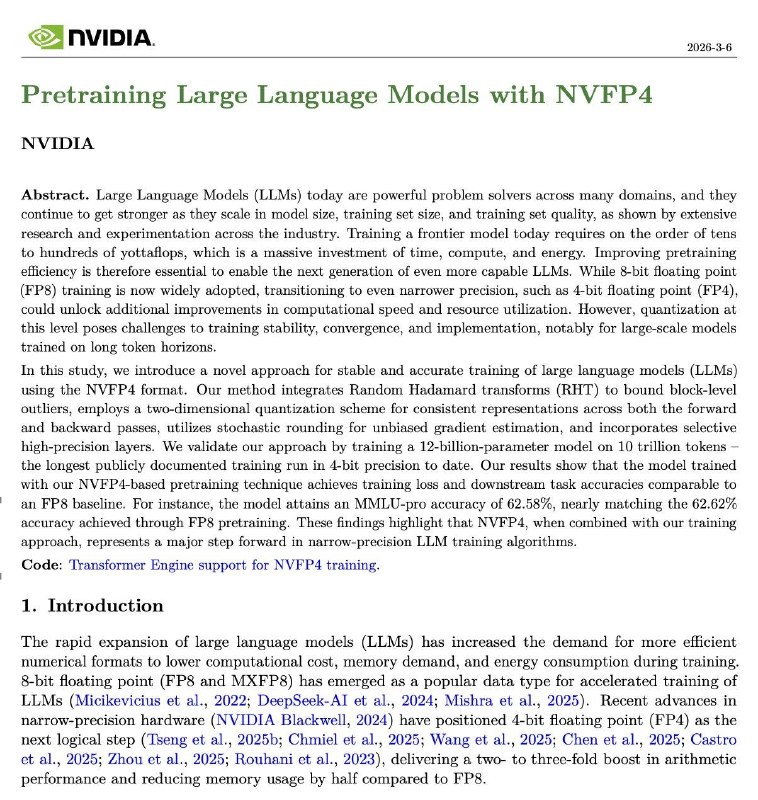
NVIDIA обучила 12-миллиардную LLM в 4-битной точности на 10 триллионах токенов. И это гораздо важнее, чем звучит на первый взгляд.
До сих пор индустрия жила с простым правилом: хочешь нормально обучать большую модель - используй 16-bit или хотя бы 8-bit. Уход в 4-bit считался почти гарантированной дорогой к нестабильности, развалу градиентов и деградации качества.
Но NVIDIA показала, что проблема была не в самой 4-битной точности, а в том, как именно числа представлены.
Ключевая штука - формат NVFP4. Вместо грубого универсального масштаба он использует micro-scaling: числа разбиваются на маленькие блоки, и для каждого блока применяется свой scale factor. Проще говоря, модель получает сильно сжатое представление данных, но без потери важных деталей.
Результат выглядит как сдвиг в экономике обучения:
- арифметика быстрее в 2-3 раза
- память режется примерно на 50%
- качество почти не проседает
- 4-bit модель идёт практически рядом с 8-bit baseline
На MMLU, GSM8K и coding-бенчмарках разница оказалась около 0.1%. То есть модель стала дешевле и легче, но почти не стала глупее.
https://arxiv.org/abs/2509.25149
@machinelearning_books
Post #1421
1.97K
- 🔥 19
- ❤ 3
- 👍 1