
Anthropic показала исследование, где Claude смог решать реальные задачи по биоинформатике, с которыми не справились люди-эксперты.
Речь не про школьные тесты по биологии и не про аккуратные вопросы с очевидным ответом. Проблема старых научных бенчмарков в том, что они часто проверяют «чистые» задания, а не грязную работу с настоящими биологическими датасетами.
Для этого Anthropic сделала BioMysteryBench. В нём правильные ответы спрятаны внутри реальных датасетов, а оценивается только финальный результат. Claude получает стандартные инструменты биологии и доступ к базам данных, а параллельно те же задачи пробуют решать до пяти экспертов.
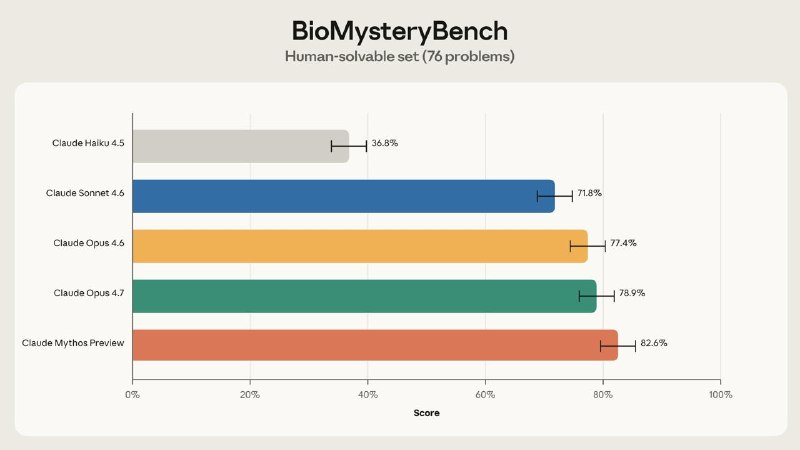
Всего было 99 задач. На 76 задачах, которые смог решить хотя бы один эксперт, лучшая модель набрала около 83%. Но самое интересное - 23 задачи оказались «human-difficult»: экспертная панель не смогла их решить. На этом наборе Claude Mythos Preview решил 29.6%.
Правда, есть важная оговорка. На самых сложных задачах успехи были менее стабильными при пяти повторных попытках. То есть часть побед выглядела не как надёжное мастерство, а как удачная попытка.
Claude начинает быть похож на очень быстрого исследовательского напарника: комбинирует методы, перепроверяет факты, использует широкий фон знаний и помогает быстрее сузить пространство поиска.
https://www.anthropic.com/research/Evaluating-Claude-For-Bioinformatics-With-BioMysteryBench
Post #1413
1.58K
- ❤ 6
- 👍 5