
Всем спасибо за слова поддержки!
Поныли и хватит - продолжаем писать тяжелый технический контент на основе реальных кейсов. Сегодня будет куча инсайтов по N8N и OpenAI.
____
Ранее я писал про сложный проект, который со скрипом удалось доделать.
Сразу после завершения OpenAI что-то поменяли и 20 минут на генерацию отчета превратились в 280.
При таком раскладе экономический смысл затеи терялся, поэтому пришлось придумывать что-то новое.
Вводные данные:
- Я использовал ассистента OpenAI с
threads и gpt-4o-mini. - Мне нужно было сгенерировать 22 сообщения с
structured output (это важный нюанс, так как сильно нагружает LLM).- На входе подается много данных (десяток страниц текста), поэтому тред быстро становится тяжелым и генерация каждого последующего сообщения замедляется.
Что я попробовал:
- Поменял HTTP ноды с
stream параметром на код, так как последние запросы он думал по 20 минут и в конце выдавал какую-то билеберду. Еще я грешил на gpt-4o-mini, но gpt-4.1-mini съедало столько же времени. Для контекста - я использую кастомные HTTP запросы и делаю Run ассистента. В этом случае вам нужно либо получать всю цепочку рассуждений используя stream параметр, либо делать цикл ожидания и проверять результаты каждые Х секунд. - Генерировал без
structured output - это не помогло.Оставалось попробовать:
- Перейти на Responses и молиться, что проблема не на моей стороне.
- Перейти на Chat completions - тут бы пришлось переделать всю структуру запросов, так как нужно будет самим отвечать за контекст, который обычно ложится на плечи
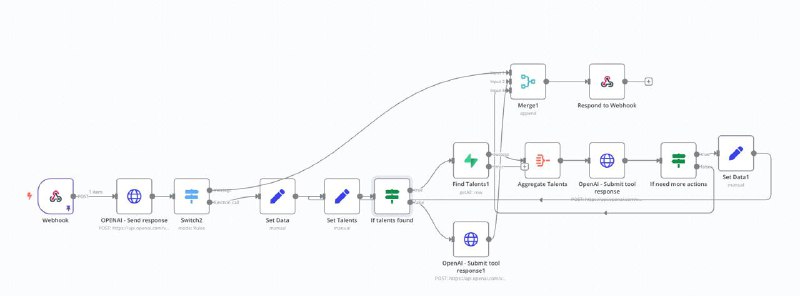
threads.В итоге я решил попробовать реализовать с Responses API.
Что нужно знать об этом подходе в сравнении с Assistants API:
- Тут нет
assistants - инструкции нужно задавать при запросе или они будут наследованы с предыдущего запроса.- Тут нет
threads - вместо них есть указание предыдущего сообщения, через которое собирается вся цепочка сообщений в тред на стороне OpenAI.- Tools нужно указывать при каждом запросе отдельно.
- Один запрос на всё - ответ от custom tool передается так же, как и сообщение пользователя, и при этом требует повторения параметров (к примеру вы дергали запрос с tools и указанием формата JSON schema, он выбрал custom tool, вам нужно отправить ответ от tool вместе с JSON schema, иначе будет дефолтный текстовый формат)
В результате Responses показал такую же результативность, как и была до поломки - около 20 минут на 1 отчет с gpt-4o-mini.
Для понимания - за 2 таких отчета компания берет $800 с клиентов и раньше на каждый из них уходило по 3-4 часа.
Дополнительный плюс от работы с Responses - вы сможете видеть логи всех событий и ответов в дашборде OpenAI.
___
В следующем посте расскажу о том почему интерфейс N8N виснет и как этого избежать.