TGViewer
Channel Public Channel
DevOps Portal | Linux

DevOps Portal | Linux

@loose_code

Присоединяйтесь к нашему каналу и погрузитесь в мир DevOps

Сотрудничество, реклама: @devmangx

Работаем с @Spiral_Yuri

РКН: https://clck.ru/3P8kFH
Subscribers
13.1K
Photos
1K
Videos
134
Links
1.1K

Showing posts older than #2032 · Back to latest

Older Posts 17 shown
Post #2031 2.68K
MinIO прекратил активную разработку: патчи безопасности рассматриваются по индивидуальным запросам, обновления не тестируются. Для компаний с петабайтами данных в MinIO встает вопрос о миграции.
Главная сложность миграции — не выбор нового хранилища, а перенос без остановки бизнес-процессов. Большинство open-source инструментов требуют простоя: приложения нужно останавливать на время переноса данных, а на многотерабайтных объемах это может растянуться на часы или дни простоя сервиса.
На вебинаре разберем, как перенести данные из устаревшего хранилища (на примере MinIO) в другое S3-совместимое — без остановки сервиса.

📅 3 сентября, 16:00 мск

Регистрация
  • 👍 7
  • ❤ 2
Post #2030 2.48K
Большинство инженеров каждый день работают с Kubernetes, но не могут объяснить, что происходит после запуска kubectl apply.

Разберём по шагам.

Когда вы применяете манифест, на самом деле происходит следующее:
- kubectl отправляет YAML в kube-apiserver
- API Server валидирует манифест, аутентифицирует запрос и записывает желаемое состояние в etcd
- Scheduler отслеживает Pod'ы, которые ещё не назначены ни на одну ноду. Он оценивает доступные ноды, выбирает наиболее подходящую и привязывает к ней Pod
- kubelet на выбранной ноде видит новое назначение Pod'а. Он скачивает образ, запускает контейнер и отправляет статус обратно
- kube-proxy следит за изменениями Service'ов и Endpoint'ов. Он обновляет правила iptables или IPVS, чтобы трафик мог доходить до вашего Pod'а

А теперь самое интересное.
- Вся система работает по событийной модели — event-driven. Компоненты не опрашивают друг друга
- Каждый компонент следит за изменениями через API Server и реагирует только тогда, когда это необходимо

Именно поэтому Kubernetes называют системой desired state — «желаемого состояния».

Вы декларативно описываете, что хотите получить. А Kubernetes сам приводит систему к этому состоянию.

В материале подробно разбирается архитектура Kubernetes и показывается, что на самом деле происходит под капотом после запуска kubectl apply.

Читать здесь:
https://devopscube.com/kubernetes-architecture-explained/

👉 DevOps Portal
  • ❤ 13
  • 🔥 2
  • 👍 1
Post #2029 2.32K
Kubernetes HPA не ограничивается только CPU и памятью

Ворклоады можно скейлить и по кастомным метрикам, например

- количество запросов в секунду (RPS)
- длина очереди
- количество активных соединений
- latency приложения

Для этого можно использовать связку HPA + Prometheus + Prometheus Adapter.

Prometheus Adapter прокидывает метрики через Kubernetes Custom Metrics API, после чего HPA использует их для автоскейлинга.

Но выбрать метрику — это только часть настройки автоскейлинга. Нужно ещё контролировать, как HPA будет скейлить ворклоад при изменении значений метрики.

В этой рассылке разобрали, как работает HPA tolerance.

Читать здесь:
https://newsletter.devopscube.com/p/kubernetes-hpa-tolerance-levels

👉 DevOps Portal
  • 👍 7
  • 🔥 2
  • ❤ 1
Post #2027 4.19K
SSH-туннели, или как стать магом сетевой связности

10 практических челленджей, чтобы прокачать port forwarding через SSH-туннели — от простого локального/удалённого проброса портов до продвинутых сценариев с bastion- и jump-хостами:

- Получить доступ к внутреннему debug-порту через SSH-туннель
https://labs.iximiuz.com/challenges/ssh-local-port-forwarding
- Достучаться до приватного сервиса в VPC через SSH-бастион
https://labs.iximiuz.com/challenges/ssh-local-port-forwarding-bastion
- Получить доступ к удалённому loopback-порту через SSH jump host
https://labs.iximiuz.com/challenges/ssh-local-port-forwarding-jump-host
- Ограничить доступ к SSH-бастиону в зависимости от роли пользователя
https://labs.iximiuz.com/challenges/ssh-local-port-forwarding-bastion-hardened
- Получить доступ к внутренним серверам через SSH-бастион без shell-доступа
https://labs.iximiuz.com/challenges/ssh-jump-host-internal-servers
- Получить доступ ко всей VPC через SSH SOCKS-прокси
https://labs.iximiuz.com/challenges/ssh-socks-proxy
- Пробросить локальный сервис наружу через обратный SSH-туннель
https://labs.iximiuz.com/challenges/ssh-remote-port-forwarding
- Пробросить устройство из домашней сети через обратный SSH-туннель
https://labs.iximiuz.com/challenges/ssh-remote-port-forwarding-home-network
- Пробросить всю домашнюю сеть через обратный SSH SOCKS-прокси
https://labs.iximiuz.com/challenges/ssh-reverse-socks-proxy
- Заменить root-доступ по паролю на админский логин по SSH-ключу
https://labs.iximiuz.com/challenges/ssh-harden-new-server


Приятного хакинга!

👉 DevOps Portal
  • ❤ 10
  • 👍 2
  • 🔥 1
Post #2026 2.5K
С Kubernetes-сетями довольно быстро становится сложно, как только выходишь за рамки базовых Service.

В этом туториале Ayobami разбирает, как работают сеть между Pod’ами, ClusterIP, Ingress-контроллеры, NetworkPolicy и CNI-плагины.

Также сравниваются разные CNI и показывается, как Cilium использует eBPF для сетевого взаимодействия, observability и возможностей service mesh.

https://freecodecamp.org/news/kubernetes-networking-explained-from-clusterip-to-cilium-service-mesh/

👉 DevOps Portal
  • 👍 3
  • 🔥 1
Post #2024 2.59K
Паттерн проектирования sidecar – удобный способ вынести прокси, агенты доставки логов, агенты для provisioning секретов и другие вспомогательные процессы за пределы основного контейнера приложения.

Начиная с Kubernetes 1.28, поддержка sidecar-контейнеров стала нативной – и реализована довольно элегантно: никакого нового типа контейнеров, просто initContainer с restartPolicy: Always.

Попрактиковаться в работе с нативными sidecar-контейнерами Kubernetes можно здесь:
https://labs.iximiuz.com/tutorials/kubernetes-native-sidecars

👉 DevOps Portal
  • 👍 8
  • 🔥 2
  • ❤ 1
Post #2023 3.09K
Hubble — полностью распределённая платформа для observability сетевого взаимодействия и безопасности cloud-native workloads.

Она построена поверх Cilium и eBPF и позволяет глубоко анализировать взаимодействие сервисов, их поведение и работу сетевой инфраструктуры.

➜ https://github.com/cilium/hubble

👉 DevOps Portal
  • ❤ 8
  • 👍 3
  • 🔥 3
  • 🤯 1
Post #2022 2.95K
Многие ли знают, что Helm хранит информацию о релизах в Kubernetes Secrets?

Когда вы запускаете helm install или helm upgrade, Helm сохраняет данные о релизе в K8s Secrets в том же namespace.

В Secret хранится, например:
- имя релиза;
- статус деплоя;
- применённые манифесты;
- использованные values;
- информация о chart и другие данные.

Данные в Secret сжимаются с помощью gzip, а затем кодируются в base64.

Имя Secret создаётся по следующему шаблону:
sh.helm.release.v1.[release-name].v[revision]

Когда вы запускаете helm rollback, Helm читает эти Secrets, чтобы восстановить приложение до предыдущей версии.
Helm не нужна внешняя база данных.

Вся информация хранится прямо в вашем кластере в виде нативных Kubernetes Secrets.

Примечание: также можно настроить внешнюю SQL-базу данных для хранения релизов, но эта возможность пока находится в beta

👉 DevOps Portal
  • ❤ 7
  • 🔥 3
Post #2020 2.49K
Как работают мультиплатформенные container images

Когда вы делаете docker pull nginx:1.29 на AMD64-сервере и на ARM64-ноутбуке, Docker подтягивает совершенно разные сборки образа. Но как это возможно, если в обоих случаях используется одно и то же имя образа?

Чтобы представить несколько сборок через одну ссылку на образ (например, nginx:1.29), container registry использует специальный файл — Image Index, в котором перечислены манифесты для отдельных платформенных сборок. Поэтому при pull появляется дополнительный шаг:

- Сначала запрашивается index по адресу https://registry.example[.]com/v2/REPO/manifests/TAG

- Затем в index находится манифест образа для нужной платформы, после чего он запрашивается по digest: https://registry.example[.]com/v2/REPO/blobs/DIGEST

- И уже после этого по digest’ам из манифеста подтягиваются config образа и blobs слоёв файловой системы

Для single-platform image ссылка https://registry.example[.]com/v2/REPO/manifests/TAG указывает сразу на его manifest. То есть здесь на один уровень косвенности меньше.

Подробнее о внутреннем устройстве container images:
https://labs.iximiuz.com/tutorials/container-image-from-scratch

👉 DevOps Portal
  • ❤ 4
  • 🔥 2
  • 🌚 2
  • 🌭 1
  • 👀 1
Post #2019 2.45K
Model Server — одно из ключевых понятий в MLOps.

Если говорить проще:

* Nginx-сервер обслуживает веб-приложения
* Model Server обрабатывает inference-запросы к ML-модели

Работает это следующим образом.

Model Server загружает артефакты обученной модели в оперативную память или память GPU, чтобы не загружать модель заново при каждом запросе.

Он предоставляет inference-эндпоинты по HTTP и gRPC.

Также он экспортирует метрики и трейсы – например, через Prometheus и OpenTelemetry (OTEL).

Среди часто используемых Model Server – MLServer, TensorFlow Serving, NVIDIA Triton Inference Server и другие.

Теперь важный момент.

Model Server сам по себе не умеет горизонтально масштабироваться.

Для масштабирования и обеспечения высокой доступности поверх него используется оркестрация Kubernetes.

Когда речь идёт о model serving, KServe – один из ключевых serving-фреймворков для Kubernetes.

Model Server отвечает за обработку inference-запросов, а KServe выступает в роли слоя оркестрации.

👉 DevOps Portal
  • 👍 3
  • ❤ 1
  • 👀 1
Post #2014 3.06K
Linux 101: Практика по управлению хранилищами

Отработайте основы управления хранилищами в Linux на серии практических заданий – от монтирования существующих файловых систем до разметки дисков и автоматизации их подготовки:

- Смонтировать диск с уже существующими данными и прочитать его содержимое
https://labs.iximiuz.com/challenges/storage-simple-mount

- Создать файловую систему ext4 на неформатированном диске
https://labs.iximiuz.com/challenges/storage-simple-format

- Создать таблицу разделов GUID Partition Table (GPT) на пустом диске
https://labs.iximiuz.com/challenges/storage-simple-partition-table

- Разбить диск на несколько разделов и отформатировать их в ext4 и Btrfs
https://labs.iximiuz.com/challenges/storage-partition-drive

- Смонтировать существующую директорию по новому пути с помощью bind mount
https://labs.iximiuz.com/challenges/storage-bind-mount

- Настроить постоянное монтирование файловой системы, чтобы оно сохранялось после перезагрузки
https://labs.iximiuz.com/challenges/storage-persistent-mount

- Автоматизировать подготовку диска с помощью shell-скрипта
https://labs.iximiuz.com/challenges/storage-provision-drive-script


👉 DevOps Portal
  • 👍 13
  • ❤ 5
  • 🔥 3
Post #2013 3.22K
Как обученная AI-модель превращается в production API в Kubernetes?

KServe — это проект CNCF на стадии Incubating для развёртывания и обслуживания AI-моделей в Kubernetes.

Проще говоря, KServe берёт обученную модель и превращает её в масштабируемый inference-сервис в Kubernetes.

Он берёт на себя деплой, сеть, автоскейлинг и health checks модели.

Важно понимать, что KServe уже давно работает не только с классическими ML-моделями.

Как inference-платформа, он поддерживает две категории AI/ML-нагрузок:

- Predictive AI (классический ML): например, модели на scikit-learn, XGBoost, модели, упакованные через MLflow, и другие.
- Generative AI (LLM): например, запуск и обслуживание LLM через backend vLLM с поддержкой GPU.

Если хотите разобраться, как устроена inference-платформа KServe, можно прочитать свежий выпуск MLOps-рассылки.

В нём разбираются:
- Model Servers и runtimes в KServe
- Как KServe разворачивает AI-модели в Kubernetes
- Деплой MLflow-модели в KServe на практике
- Как выкатывать новые версии моделей
- Rolling Updates, Canary, A/B Testing и Shadow Deployments

И многое другое.

Читать здесь: https://newsletter.devopscube.com/p/kserve

👉 DevOps Portal
  • ❤ 5
  • 👍 5
  • 🔥 3
  • 👀 1
Post #2012 2.82K
KubePlumber проверяет работу сети Kubernetes изнутри кластера, тестируя:

* внутренний DNS,
* трафик между подами,
* внешний DNS,
* пропускную способность между нодами.

➤ https://github.com/David-VTUK/KubePlumber

👉 DevOps Portal
  • ❤ 8
  • 👍 1
  • 👀 1
Post #2011 3.22K
20 Kubernetes-челленджей

Итак, вот 20 вопросов (и ответов):

1. Подсчёт endpoints

2. Ждём чуда

3. Я сказал стоп

4. Проектирование shared-кластеров

5. Kernel panic

6. Прыгай, кролик

7. Сколько — это слишком много

8. Держим свет включённым

9. Прожорливый etcd

10. Умножение pod’ов

11. В одиночку

12. Rollin’

13. All you can eat

14. Bounce

15. В кроличью нору

16. Throttled

17. Липкий бардак

18. Жив или мёртв

19. Связанный по рукам

20. Один, чтобы связать их всех


Вы можете использовать эти задания, чтобы прокачать свои знания, как (очень сложные) вопросы на собеседованиях или чтобы подготовиться к интервью

👉 DevOps Portal
  • 👍 6
  • ❤ 3
  • 🔥 1
  • 👀 1
Post #2009 2.93K
Canary vs Shadow Deployment vs A/B Testing

Когда мы деплоим модель в production, для неё применяются те же стратегии деплоя, которые обычно используются и для обычных приложений.

Разберём три распространённые стратегии деплоя моделей.

1. Canary Traffic Splitting
Небольшой процент реального трафика, например 10%, направляется на новую модель, после чего отслеживается её работа.

Если с предсказаниями всё в порядке, долю трафика постепенно увеличивают, пока она не достигнет 100%.

2. A/B Testing
Одну группу пользователей направляют на модель A, другую — на модель B с помощью sticky routing, после чего сравнивают бизнес-метрики: CTR, conversion rate, revenue и т. д.

3. Shadow Deployment
Каждый реальный запрос, как обычно, обрабатывается старой моделью, и пользователь получает именно её ответ.

При этом копия того же запроса в фоне также отправляется на новую модель.

После этого можно сравнить залогированные предсказания обеих моделей на одном и том же реальном трафике.

👉 DevOps Portal
  • ❤ 4
  • 👍 1
  • 🔥 1
  • 👀 1
Post #2007 2.53K
DevOps-инструмент недели: Ray

ML-нагрузка может отлично работать на одной GPU.

Сложности начинаются, когда её нужно масштабировать на несколько GPU, работающих на разных нодах.

Именно здесь помогает Ray.

Ray – это опенсорс фреймворк с 43K+ звёзд на GitHub.

Он помогает организовать распределённое выполнение задач: планирование задач, распределение ресурсов, параллельное выполнение, обмен данными между воркерами и обработку сбоев.

Ray можно запускать на ноутбуке, виртуальных машинах, bare-metal серверах, облачных инстансах или в Kubernetes.

Для Kubernetes обычно используется KubeRay – Kubernetes Operator для создания и управления Ray-кластерами.

Ray используют такие компании, как OpenAI, Uber, Spotify и Instacart, для масштабных AI- и ML-нагрузок.

https://github.com/ray-project/ray

👉 DevOps Portal
  • ❤ 2
  • 🔥 2
  • 👀 2
  • 👍 1
Post #2006 2.45K
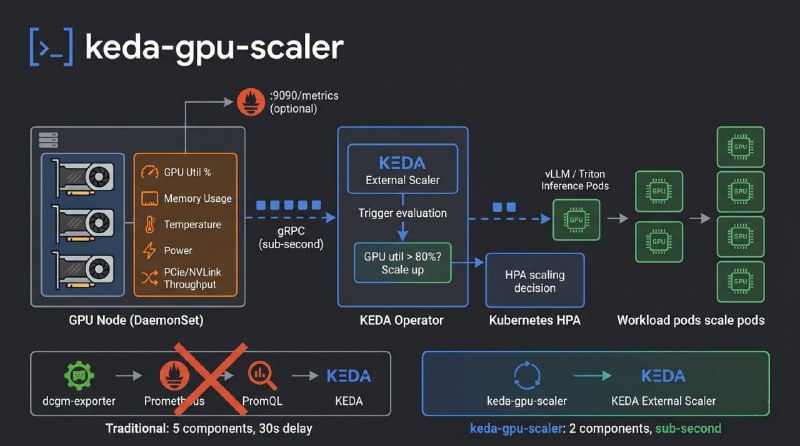
KEDA GPU Scaler — это внешний scaler для KEDA, который получает метрики NVIDIA GPU через NVML и автоматически масштабирует vLLM, Triton, training jobs и кастомные inference-нагрузки без необходимости использовать Prometheus.

https://github.com/pmady/keda-gpu-scaler

👉 DevOps Portal
  • ❤ 3
  • 👍 3
  • 🔥 3
  • 👀 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →