TGViewer
Channel Public Channel
DevOps Portal | Linux

DevOps Portal | Linux

@loose_code

Присоединяйтесь к нашему каналу и погрузитесь в мир DevOps

Сотрудничество, реклама: @devmangx

Работаем с @Spiral_Yuri

РКН: https://clck.ru/3P8kFH
Subscribers
13.1K
Photos
1.1K
Videos
134
Links
1.1K

Showing posts older than #1471 · Back to latest

Older Posts 19 shown
Post #1469 4.24K
Если вы хотите избавиться от сотен уязвимостей (CVE) в своих контейнерных образах, первым шагом будет понять, откуда они берутся

Типичные источники:

- «Толстый» базовый образ

- Забытые инструменты сборки

- Устаревшие зависимости

Простое решение? Многоэтапная сборка с более свежим и лёгким базовым образом.

Пример анализа базового образа: Более глубокий взгляд на Docker-образы Node.js: «Помогите, в моём Node-образе есть Python!»

👉 DevOps Portal
  • 👍 5
Post #1468 4.4K
Как HTTP(S)-порты пробрасываются из VM, у которых есть только приватные IP-адреса

- У каждого bare-metal хоста есть только один публичный IP-адрес

- DNS-запись *.node-xyz.iximiuz.com и wildcard-сертификат Let’s Encrypt указывают на этот IP

- Каждый раз, когда наружу пробрасывается порт VM, генерируется новый случайный поддомен

- Этот рандомный поддомен не существует за пределами конкретного хоста, он известен только соответствующему bare-metal серверу

- Все запросы к этому поддомену приходят на единственный публичный IP хоста, где слушает ingress-прокси (Envoy)

-Интерфейс VM виден только внутри её «обёртки» — Docker-контейнера (для дополнительной изоляции), поэтому Envoy не может достучаться до VM напрямую

- Вместо этого Envoy прокидывает запросы к поддомену в локальный UNIX-сокет, смонтированный в контейнер-обёртку VM

- Этот UNIX-сокет открыт специальным процессом-forwarder’ом (крошечный Go-сервис), который работает внутри контейнера-обёртки

- Forwarder делает io.Copy(UNIX socket, VM's private IP:port)

Профит! Десятки полностью изолированных VM на одном bare-metal хосте, и у каждой свой публичный URL

👉 DevOps Portal
  • ❤ 10
  • 👍 4
Post #1467 4.63K
Основы сетей - Проброс портов

Древний трюк, который может помочь сделать сервис доступным на другом порту без рестарта, либо подключиться к базе данных внутри приватного VPC.

Практика:

🔸socat: https://labs.iximiuz.com/challenges/port-forwarding-using-socat
🔸netcat: https://labs.iximiuz.com/challenges/port-forwarding-using-netcat
🔸без прокси: https://labs.iximiuz.com/challenges/port-forwarding-without-proxy

👉 DevOps Portal
  • 👍 13
  • ❤ 4
  • 🔥 4
Post #1465 4.07K
В чём разница между этими двумя DNS-запросами?

На вид они похожи, но на самом деле показывают совершенно разные вещи.

В первом случае:

— nslookup http://academy.networkchuck.com

Ты обращаешься к своему дефолтному DNS-резолверу (роутер или DNS от провайдера).
✅ Рекурсивный lookup — он пройдёт по всей цепочке CNAME до финального IP.
❌ Non-authoritative — ответ может быть из кэша и потенциально устаревшим.

Во втором случае:

— nslookup http://academy.networkchuck.com http://ns.cloudflare.com

Ты напрямую спрашиваешь авторитативный DNS-сервер.
✅ Ответ приходит прямо из первоисточника.
❌ Он покажет только то, что знает сам сервер — lookup остановится на первом CNAME.

И что же лучше? Зависит от задачи.

- Используй дефолтный резолвер, если тебе просто нужен конечный IP как можно быстрее.
- Обращайся к авторитативному серверу, если нужно проверить, кто чем реально управляет.

👉 DevOps Portal
  • 👍 15
  • ❤ 6
  • 🔥 5
Post #1464 4.43K
Быстрый совет по Linux

Логи упакованы в .gz? Их не нужно распаковывать, чтобы читать или искать по содержимому.

Используй инструменты с префиксом z прямо по месту:

zcat — просмотреть файл

zless — пролистывать содержимое

zgrep — искать внутри файла

zegrep — искать с расширенными регулярками (ERE)

zfgrep — искать по фиксированным строкам

zcmp/zdiff — сравнивать файлы

Эти команды позволяют анализировать сжатые логи без предварительной распаковки, идеально для быстрых сеансов устранения неполадок ✌️

👉 DevOps Portal
  • 👍 25
  • ❤ 4
Post #1462 4.53K
Cовременная, легковесная дашборда для Kubernetes, которая предоставляет метрики в реальном времени, поддержку мультикластерных окружений, редактирование YAML и управление ресурсами через интуитивно понятный UI

GitHub: kite

👉 DevOps Portal
  • 🔥 5
  • ❤ 2
Post #1461 4.4K
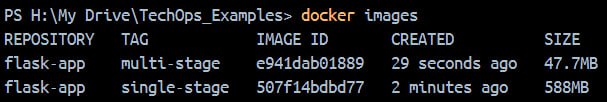
Уменьшили размер Docker-образа с 588 MB до 47,7 MB

Исходная сборка:

🔹Полноценный базовый образ Python 3.9
🔹Множество инструкций RUN, создающих лишние слои
🔹Отсутствие .dockerignore
🔹Одностадийная сборка со всеми зависимостями

Применённые оптимизации:

1. Более лёгкий базовый образ
- Перешли на Python 3.9-alpine
- Образ стал легче на ~95% и быстрее скачивается

2. Оптимизация слоёв
- Объединили связанные команды
- Убрали избыточные инструкции RUN

3. .dockerignore
- Исключили venv, кэши и временные файлы
- Сократили контекст сборки

4. Multi-stage build
- Отдельный stage для сборки зависимостей
- Production-stage с минимальным runtime-набором

Результат:

🔹Размер образа: 47,7 MB (с 588 MB)
🔹Снижение размера: −91,89%
🔹Более быстрый старт контейнера
🔹Меньше времени деплоя и меньше места в registry

Маленькие оптимизации дают большой эффект. Каждый сэкономленный мегабайт ускоряет каждый билд.

👉 DevOps Portal
  • ❤ 22
  • 👍 7
  • 😁 3
  • 🌚 3
Post #1459 4.12K
Свежий сбой в AWS (US-EAST-1)

Самое время пересмотреть стратегии аварийного восстановления в облаке (объяснённые простым языком)

Любая стратегия Disaster Recovery начинается с определения:

🔹RTO (Recovery Time Objective) —
сколько простоя вы можете себе позволить?

🔹RPO (Recovery Point Objective) —
какую потерю данных вы готовы терпеть?

Стратегии Disaster Recovery:

1. Backup and Restore → регулярные бэкапы и восстановление после инцидента
RTO: от нескольких часов до нескольких дней, RPO: момент последнего бэкапа

2. Pilot Light → ядро системы находится в standby и разворачивается при необходимости
RTO: от минут до часов, RPO: зависит от частоты репликации

3. Warm Standby → укороченная «живая» копия среды, которую можно быстро расшscaleить
RTO: минуты, RPO: от нескольких минут до часов

4. Hot / Multi-Site → оба сайта работают активно с мгновенным фейловером
RTO: близок к нулю, RPO: секунды

👉 DevOps Portal
  • ❤ 7
  • 👍 4
Post #1458 3.92K
Kubernetes позволяет добавлять собственные API

В Kubernetes есть мощный механизм под названием API Aggregation Layer.

Он помогает добавлять кастомные API в кластер.

Это означает, что вы можете создавать собственные типы ресурсов и заставлять Kubernetes делать больше, чем он умеет из коробки.

Классический пример использования Aggregation Layer в Kubernetes - это реализация Metrics Server.

Metrics Server реализует Metrics API как дополнительный API-сервер, используя Aggregation Layer.

Это означает, что хоть Metrics Server и является отдельным сервисом, к его API можно обращаться так, как будто он - нативная часть Kubernetes API.

В целом, поток запросов выглядит так:

- Когда вы запускаете kubectl get pods, запрос уходит на /api/v1/pods и маршрутизируется в Core API Server.

- Когда вы запускаете kubectl top pods, запрос уходит на /apis/metrics.k8s.io/v1beta1/ и маршрутизируется в Metrics Server.

Prometheus Adapter также использует этот механизм, чтобы отдавать кастомные метрики по адресу /apis/custom.metrics.k8s.io/

👉 DevOps Portal
  • ❤ 6
Post #1455 4.54K
Мы все знаем, что у AWS недавно случился даунтайм. Давайте разберём, что именно произошло.

Регион US-EAST-1 — один из крупнейших и наиболее критичных дата-центров AWS, где размещена инфраструктура тысяч крупных сайтов и приложений. Когда у DynamoDB, ключевого сервисa баз данных, начали расти ошибки, это вызвало эффект домино по взаимосвязанным системам AWS. Сбои стали массовыми, потому что многие приложения полагаются на DynamoDB для операций хранения и выборки данных.

DynamoDB глубоко интегрирован в архитектуру control plane AWS. Многие сервисы AWS используют его внутри для хранения метаданных, информации о состоянии и конфигураций сервисов. Поэтому, когда API-эндпоинт DynamoDB стал недоступен через DNS, зависящие от него сервисы потеряли доступ к критически важным операционным данным. Сбой одновременно затронул более 36 сервисов AWS.

Когда упала DNS-резолюция, клиенты просто перестали находить нужные эндпоинты DynamoDB. Это запустило фидбек-луп, похожий на тот, что произошёл во время даунтайма DynamoDB в сентябре 2015 года: каждый повторный запрос потреблял больше ресурсов, вызывал новые таймауты, которые, в свою очередь, генерировали ещё больше ретраев - и так по кругу, пока система не ушла в штопор.

AWS, вместо того чтобы ждать, пока найдут и устранят одну конкретную корневую причину, сразу пошёл по нескольким параллельным сценариям восстановления.

Основное исправление заключалось в стабилизации инфраструктуры DNS-резолвинга для эндпоинта DynamoDB. Команды инженеров AWS, вероятно:

🔹переконфигурировали или перезапустили DNS-резолверы, обслуживающие DynamoDB

🔹временно перевели трафик на альтернативные пути DNS-резолвинга

🔹применили аварийные настройки DNS-кэширования

Этот инцидент отражает взаимозависимость и хрупкость крупномасштабных облачных экосистем, где даже единственная точка отказа в базовом сервисе способна за минуты вызвать каскад проблем в десятках систем.

P.S. Это лишь часть деталей и предположений, которые я нашёл в интернете и сформировал на основе собственного понимания. Точные и подробные данные AWS ещё не раскрыл.

👉 DevOps Portal
  • 👍 23
  • ❤ 11
Post #1454 4.44K
Совет дня по Linux

В Linux оператор конвейера (|) полезен, когда нужно направить вывод одной команды на вход другой для дальнейшей обработки:

$ cat data.txt | grep "No such file"


Однако это не перенаправляет ошибки. Если файл не существует, команда grep не даст результата.

Что если нужно перенаправить и обработать как ошибки, так и обычный вывод?

Здесь на помощь приходит оператор перенаправления |&.

Этот оператор направляет как стандартный вывод (stdout), так и стандартные ошибки (stderr) первой команды через конвейер на стандартный ввод (stdin) второй команды. Посмотрите на следующий пример:

$ cat data.txt |& grep "No such file"


Обратите внимание на разницу: команда grep смогла найти совпадение.

Оператор |& в bash является сокращением для оператора перенаправления 2>&1 |:

$ cmd-1  2>&1  |  cmd-2


👉 DevOps Portal
  • 👍 17
  • ❤ 2
Post #1452 4.4K
Упрощённое визуальное руководство по CI/CD

Непрерывная интеграция (CI) — практика частого слияния изменений кода в общий репозиторий с автоматической проверкой их целостности

Непрерывное развёртывание (CD) — автоматизирует релиз и деплой изменений кода в продакшен, обеспечивая отлаженный и надёжный процесс

Этот визуальный гайд поможет быстро разобраться, как это работает

👉 DevOps Portal
  • 🔥 8
Post #1451 4.49K
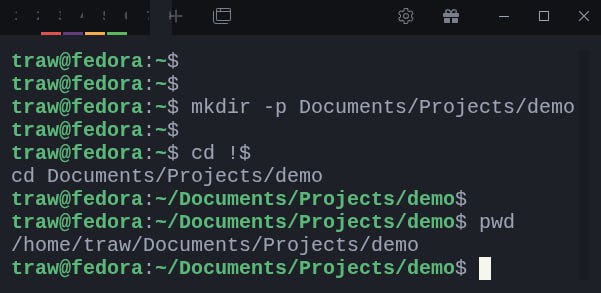
Быстрый совет по Linux

Хочешь повторно использовать последний аргумент из предыдущей команды? Используй !$

Сбережёшь своё драгоценное время ✌️

👉 DevOps Portal
  • 👍 19
  • ❤ 8
  • 🔥 1
Post #1449 4.58K
Знали ли вы, что поды могут становиться «невидимыми»?

Проверьте свои знания Kubernetes, попробуйте найти невидимый pod в этом челлендже: https://labs.iximiuz.com/challenges/kubernetes-invisible-pod-0bf2109b

Никаких подсказок и решений. Готовьтесь к жёсткой задаче 😈

👉 DevOps Portal
  • ❤ 6
  • 💊 2
Post #1448 5.24K
Знал, что в IP-адресах можно опускать нули - и всё равно будет работать?

Например:
10.20.0.2 → 10.20.2
10.0.0.68 → 10.68

Оба варианта указывают на один и тот же хост.

Маленький, но прикольный трюк, который реально экономит пару нажатий в лабах.

👉 DevOps Portal
  • 🤯 25
  • 👍 10
  • ❤ 5
  • 💊 4
  • 😁 1
Post #1446 4.85K
В этой статье экспериментируют с запуском кластера MariaDB Galera в Kubernetes-лаборатории за $150, собранной на платах Orange Pi.

Подробно разбираются установка K3s, деплой MariaDB Kubernetes Operator и настройка resource limits для малых SBC

Читайте здесь

👉 DevOps Portal
  • 👍 12
  • 😁 3
  • ❤ 1
Post #1445 5.18K
Маленькая шпаргалка для начинающих линуксоидов

Сохраняем и пользуемся ✌️

👉 DevOps Portal
  • 👍 9
  • ❤ 6
Post #1443 4.92K
10 ошибок Kubernetes, которые нужно знать (и как их исправить)

Ошибки в K8s - одна из самых распространённых проблем, с которыми разработчики сталкиваются при запуске ворклоадов в продакшене, что приводит к неудачным деплоям, даунтайму и пустой трате времени на траблшутинг.

Читайте здесь

👉 DevOps Portal
  • 👍 5
  • ❤ 2
Post #1442 5.02K
Официальным языком DevOps должен быть YAML

- Helm использует YAML
- GitHub использует YAML
- Ansible использует YAML
- Argo CD использует YAML
- Kubernetes использует YAML
- Azure DevOps использует YAML
- Docker Compose использует YAML
и многие другие…

Все продвинутые инструменты, которые ты стремишься изучить и применять, работают на YAML.

Так что сначала разберись с ним, вот тебе шпаргалка

👉 DevOps Portal
  • 🔥 31
  • ❤ 7
  • 👍 5
  • 🏆 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →