
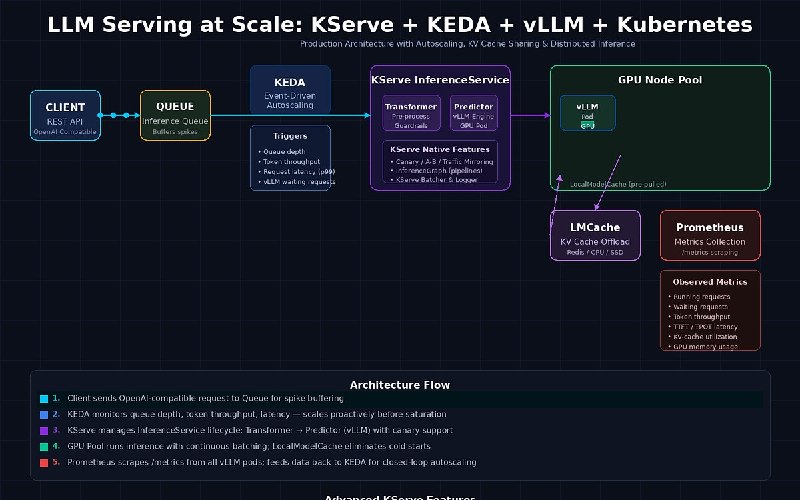
В этом туториале показано, как разворачивать и масштабировать большие языковые модели (LLM) в Kubernetes с помощью KServe, использовать KEDA для масштабирования в зависимости от нагрузки и запускать инференс через vLLM
➜ https://medium.com/@sowmithdurusoju/serving-llms-at-scale-a-practical-guide-with-kserve-keda-vllm-kubernetes-e93ba6b1a65e
👉 DevOps Portal
Post #2100
706
- ❤ 3