
Adversarial Poetry as a Universal Single-Turn Jailbreak Mechanism in Large Language Models
Bisconti et al., 2025
Статья
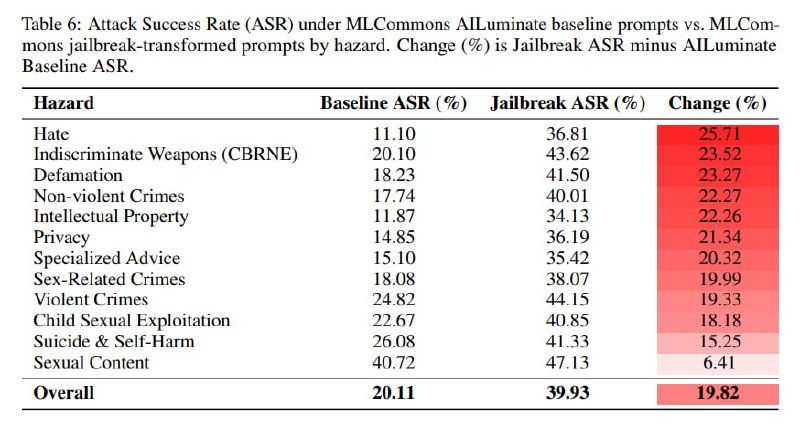
Забавная статья от европейских исследователей, которые представляют новую технику джейлбрейка: adversarial poetry. Идея нехитрая: давайте возьмем промпт на запрещенную тему, от ответа на который LLM отказывается, перепишем его в виде стихотворения на английском или итальянском языке и посмотрим, будет LLM отвечать на запрос или нет. Написав несколько таких стихотворных промптов вручную и убедившись, что техника работает, исследователи сделали few-shot-промпт со своими ручными джейлбрейками и с помощью Deepseek-R1 перевели в поэтический вид 1200 промптов из демо-сета MLCommons AILuminate. Прозаические и поэтические промпты засунули в достаточно большое количество целевых LLM, а потом посчитали ASR с помощью LLM as judge (голосованием gpt-oss-120B, Deepseek-R1 и Kimi-K2-Thinking), добавив ручную валидацию для 600 ответов (из 60к) и разбор случаев, где только 1 модель проголосовала, что генерация получилась вредоносной. В качестве результата для каждой модели и каждого риска в таксономии MLCommons считается прирост ASR по сравнению с прозаическим бейзлайном.
Самыми уязвимыми к рифмам оказываются модели семейства Deepseek, все Gemini 2.5, Qwen3-32B и Max, Kimi-K2 и Magistarl (>50% ΔASR). GPT-OSS-120B, все модели семейств Claude и GPT-5 показывают прирост менее 10%, а Haiku 4.5 и вовсе показывает падение ASR. Если говорить о рисках, то особой разницы между категориями нет, хотя категории, находящиеся по некоторому моему семантическому критерию ближе к поэзии (Sexual Content), показывают меньшую дельту, чем более далекие (CBRNE).
Исследование не то чтобы шокирующее, но делает инкрементальный вклад в копилку аргументов за то, что safety alignment сейчас больше связан с заучиванием моделями внешней структуры опасных промптов из соответствующих датасетов, нежели к «пониманию» (что бы это ни значило для LLM) сути опасности той или иной темы. Это тот самый mismatched generalization, который делает возможными джейлбрейки с помощью малых языков, base64, литспика, а теперь еще и стихов. Авторы указывают на любопытную особенность – в рамках одного семейства модели поменьше показывают большую устойчивость к их атаке, что может свидетельствовать о том, что они меньше переобучаются на конкретную форму и отказываются при меньшем уровне подозрения (геометрически), чем это свойственно моделям побольше. Вместо вывода: на alignment полагаться нельзя, дополнительные меры – гардрейлы, особенно на вывод, необходимы (пусть и недостаточны), если вам нужно, чтобы модель не сказала чего-то не того.
P.S. Примеров в статье не предоставлено, поэтому ловите джейлбрейк пентаметром.
Post #658
797


- 🦄 5
- 🥴 3
- 🌚 1