
CyberSOCEval: Benchmarking LLMs Capabilities for Malware Analysis and Threat Intelligence Reasoning
Deason et al., 2025
Статья, код, данные (спасибо pwn ai за ссылку)
С большой помпой вышел давно обещанный CyberSOCEval – бенчмарк по оценке способностей моделей к выполнению defensive-задач кибербезопасности от Meta и Crowdstrike.
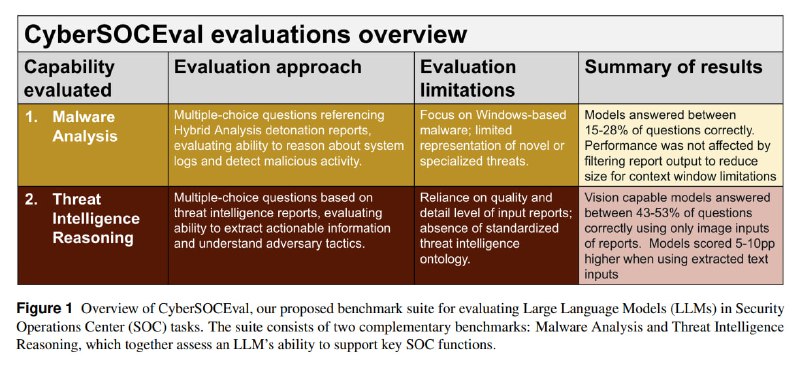
Бенчмарк состоит из двух частей, обе представляют собой синтетически сгенерированные наборы тестовых вопросов по артефактам. Первая задача состоит в динамическом анализе вредоносного ПО. Исследователи собирают датасет из неназванного числа вредоносных сэмплов разных категорий (вымогатели, инфостилеры, RAT и так далее), закидывают их в краудстрайковский сэндбокс (Hybrid Analysis) и получают отчеты в формате JSON. Затем с помощью Llama 3.2 90B на их основе генерируются тестовые в количестве 609 штук с множественным выбором, которые затем проверяются вручную. Вторая часть в целом аналогична, но вместо отчетов сэндбокса используются TI-отчеты, по которым для части вопросов из отчета извлекается граф связей типа [актор X -> использует -> вредоносное ПО Y -> атакует -> индустрию Z] – аж повеяло RDF – а потом строятся вопросы, для части – вопросы генерируются на базе заранее заданных категорий вопросов (сделай вопрос про то, куда действия маппятся в MITRE ATT&CK). Отчеты, правда, подаются интересным образом – PDF-файлы превращаются постранично в PNG-картинки. Всего через пайплайн генерации отчетов проходит 45 документов из разных источников – большинство от Crowdstrike, но есть и от АНБ. Получается 588 проверенных вручную вопросов, из которых небольшая часть вопросов, на которые нельзя ответить без анализа изображений, составлены вручную.
На этих задачах оцениваются передовые на момент исследования LLM, которые набирают 15-28% правильных ответов на задаче анализа ВПО и 43-53% на задаче анализа TI. В первой задаче на первом месте Claude-3.7-Sonnet, во второй – gpt-o3, на втором месте в обеих задачах llama-4-maverick, обгоняющая на всех задачах и gpt-4o, и gemini-2.5-pro. Даже малыш llama-4-scout отличился, обогнав на TI-задаче gpt-4o. Deepseek-R1 занял 4 место на анализе ВПО, а почитать TI ему почему-то не дали. Кроме этих цифр и наблюдения, что бенчмарк далек от насыщения, исследователи делятся следующими захватывающими фактами. Во-первых, если оставить в отчетах только важное, а неважное убрать, то качество почти не меняется (а иногда даже растет). Во-вторых, если дать LLM текст вместо сканов страниц, то качество растет сразу на 10 п.п 🤯., то же касается и их комбинации. Наконец, ответы на multiple-choice-вопросы не становятся сильно точнее, если добавить reasoning (вероятно, если бы у Meta был ризонер…🤔).
Если честно, от статьи очень смешанные впечатления. Во-первых, это немного забавная попытка предложить создателям моделей соревноваться, чья модель лучше парсит результаты работы CrowdStrike Falcon® Sandbox. Во-вторых, особенно в случае с TI, есть все же большая разница между практическим бенчмарком (те же бенчи на реверс функций) и выбором наиболее вероятного ответа на синтетический вопрос. В-третьих, модельки семейства Llama 4 хороши, но не уверен, что настолько, чтобы обходить Claude 3.7 Sonnet или gemini-2.5-pro на задачах анализа текста. Наконец, несколько удивляют мелкие детали типа неуказанного числа сэмлов или непроверенного на одной из задач Deepseek-R1 в статье от 20+ именитых исследователей из многомиллиардных корпораций. Кроме того, хотя для TI это и очень непросто, было бы круто иметь датасет свободный от геополитических импликаций (без вопросов про СВР и иранских хакеров). Остается надеяться, что это не последняя версия, и следующая будет поинтереснее.
Post #621
4.07K


- 👍 1