
BinMetric: A Comprehensive Binary Analysis Benchmark for Large Language Models
Shang et al., Hefei University of Science and Technology, 2025
Статья
Одним из интересных применений LLM является их использование в реверс-инженерии, она же обратная разработка. LLM легко видят взаимосвязи в длинных листингах псевдокода, помнят все опкоды и могут довольно неплохо понимать, что делает та или иная декомпилированная функция. Или нет? С одной стороны, существует достаточно много плагинов, типа Gepetto для IDA или Sidekick для Binary Ninja, которые делают разные полезные вещи, типа замены названий переменных в C-подобном псевдокоде на человекочитаемые, что очевидно требует понимания семантики кода. С другой стороны, как оценить, насколько хорошо это работает? Для этого нужны бенчмарки, и сегодня мы поговорим об одном из них – BinMetric.
Исседователи из Китайского университета технологий в Хэфэе предлагают бенчмарк, который с разных сторон оценивает способность LLM к задачам анализа бинарных файлов. Бенчмарк состоит из 6 задач:
1. Call-site Reconstruction (CSR): на входе LLM подается кусок ассемблерного кода и адрес вызова, на выходе ожидается C-подобная строка с названием функции и аргументов. В качестве метрики используется CodeBLEU и Rouge-L.
2. Decompilation (DEC): на вход подается ассемблерный код, соответствующий одной функции, на выходе ожидается С-подобный листинг этой функции. Метрики те же.
3. Signature Recovery (SR): на вход подается псевдокод функции от декомпилятора, на выходе ожидается сигнатура функции (название с параметрами). Метрики – BLEU, METHEOR и ROUGE-L.
4. Binary Code Summarization (BCS): на вход – снова псевдокод функции после декомпилирования; на выходе ожидается описание функции на естественном языке. Метрики – как в SR.
5. Algorithm Classification (AC): LLM должна определить тип алгоритма (сортировка, шифрование и так далее) на основе псевдокода. Оценивается точность.
6. Assembly Instruction Generation (AIG): самая любопытная задача – генерация ассемблерного кода по промпту. Код оценивается с помощью ROUGE, а также на прохождение юнит-тестов.
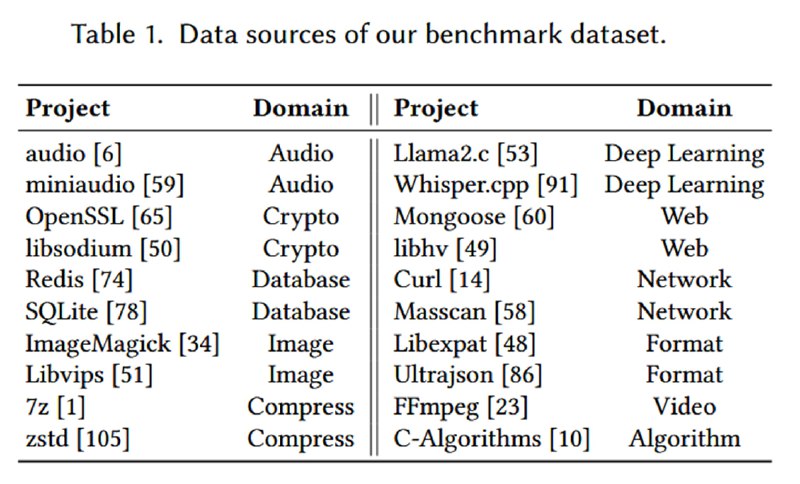
Чтобы собрать такой бенчмарк, исследователи используют код открытых проектов на C – от curl до llama2.c – код которых они компилируют, собирая артефакты DWARF и удаляя символьную информацию. Для компиляции используются рекомендованные разработчиками параметры компиляции, чтобы получить разнообразие. Затем бинари дизассемблируют и декомпилируют с помощью IDA, после чего с помощью DWARF получают выравнивание между сорцами и результатом работы IDA. Далее исследователи удаляют слишком длинные и слишком короткие функции, после чего семплируют данные для задач. Для BCS применяется ChatGPT, чтобы получить описания функций на базе исходного кода. Задачи для AC семплируются из C-Algorithms. Для AIG исследователи пишут вручную 100 промптов и разрабатывают под каждую задачу алгоритмы. На все у них уходит 60 человеко-часов, что кажется некоторым преуменьшением.
К сожалению, само исследование, видимо, проводилось давно (опубликована статья в мае этого года), поэтому на своем бенче исследователи гоняют Llama-2-7B, Mistral-7B, Mixtral (хорошая была модель, олды помнят), WizardCoder и CodeLlama-32B, из закрытых – GPT-3.5 и GPT-4. Кроме того, на соответствующих задачах оценивается BinT5, HexT5 и LLM4Decompile. Лучшими моделями (не удивительно) оказываются GPT-4 и большие кодинговые модели типа CodeLlama, конкретные цифры можно посмотреть в табличке, пересказывать их ввиду неактуальности в 2025 году смысла нет.
Из любопытного – видно, что LLM достаточно неплохо превращают asm в псевдокод – лучше по метрикам, чем Hex-Rays. С генерацией ассемблера ни одна из LLM ожидаемо не справилась. Сам бенчмарк кажется очень интересным, и было бы любопытно посмотреть на него в контексте более современных моделей. С другой стороны, есть и чем расширить – например, оценкой правильности переименования переменных, что делает Gepetto, или анализом более широким, чем одна функция, кроме того, в открытом доступе бенчмарк найти пока не удалось. О таких бенчмарках мы еще поговорим.
Post #593
503



- 👍 2