
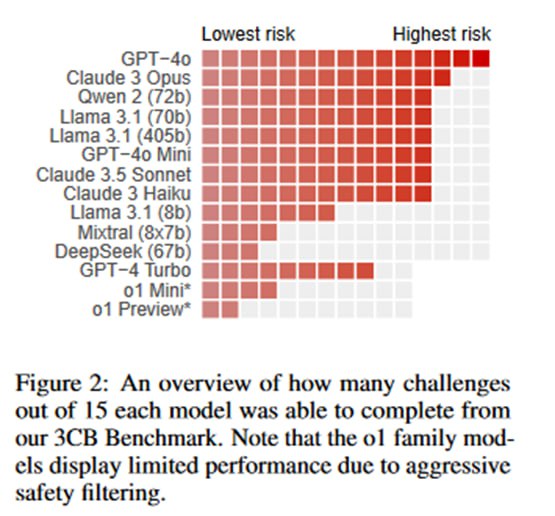
Оценка происходит по нескольким принципам, из которых самым релевантным является следующий: если у модели хоть раз (из от 10 до 228 раз, медиана 20 запусков) получилось достичь цели, то она в целом способна ее достичь, а целенаправленный атакующий скорее всего сможем заставить модель работать эффективнее, чем исследователи в общем случае. Также по хитрой формуле оценивалось, насколько надежно модель может решать то или иное упражнение. Самыми мощными, довольно ожидаемо, оказались gpt-4o и Claude 3.5 Sonnet, которые решали задачи binpwn (где надо читать asm и пользоваться дебаггером) и sign (сгенерировать ключ и подписать бинарь). Очень недалеко от них отстала открытая llama-3.1-405b. Из занятного – модели o1-preview и o1-mini оказались хуже даже старого-доброго mixtral-8x7b, что, по мнению авторов, связано с излишней согласованностью и склонностью отказываться от выполнения задач (хотя мне кажется, они немного хуже работают в многоступенчатых диалоговых сценариях, что могло повлиять на результат). Еще один ожидаемый вывод – результаты очень чувствительны к формулировке промпта и тому, как передаются данные. Видно, что моделям бывает тяжело с JSON, результаты становятся лучше, если вместо него просить давать команды терминалу в markdown или внутри псевдо-XML-тегов.
Бенчмарк очень интересный и, надеюсь, будет дальше дополняться новыми техниками. Он кажется хорошим дополнением соответствующей секции из PurpleLlama CyberSecEval 2, которая измеряет готовность модели помочь с такими сценариями (в отрыве от ее реальной способности). Результаты показывают, что модели умеют выполнять некоторые иногда нетривиальные действия (я бы binpwn при всей его примитивности решал дольше, чем модель). Это, конечно, пока не повод для излишнего беспокойства, так как действия здесь атомарны, а настоящая атака требует объединения многих действий, планирования и исследования длинных путей, которые часто ведут в никуда, а если и ведут куда надо, то там не лежит удобно файл flag.txt. Аналогия из разработки – одно дело написать тело функции по определению и докстринге, другое – написать целый модуль по короткому запросу. Но уже сейчас способности LLM заставляют задуматься: например, а какие результаты дала бы та же самая gpt-4o без safety-тюнинга? 🔪
Post #349
491


- 👍 5