TGViewer
Channel Public Channel
AI Engineers

AI Engineers

@llmengineers

A highly technical blog tailored for AI engineers.

Chat: @AI_LLMs

Personal blog: mshojaei77.github.io/

Contact me: @realshojaeii
Subscribers
2.62K
Photos
164
Videos
17
Links
246

Showing posts older than #477 · Back to latest

Older Posts 19 shown
Post #476 1.27K
تیم EXO Labs پلتفرم local.ai را در فاز دسترسی زودهنگام راه‌اندازی کرده است؛ پلتفرمی تخصصی برای اندازه‌گیری عملکرد واقعی مدل‌های هوش مصنوعی روی سخت‌افزار محلی.
چه چیزی ارائه می‌ده؟
بنچمارک‌های مستقل روی سخت‌افزار واقعی (Mac، RTX، DGX و…)
• معیارهای دقیق: سرعت، هزینه، مصرف انرژی و قابلیت‌های مدل
مرتبط با پروژه متن‌باز exo برای کلاستر کردن دستگاه‌های محلی و اجرای مدل‌های بزرگ به‌صورت خصوصی

Local.ai
  • ❤ 1
Post #474 1.37K
نسخه جدید مدل DeepSeek-V4-Pro-0813 منتشر شد!
نسخه رسمی Production مدل پرچمدار DeepSeek (جایگزین Preview آوریل).
مشخصات اصلی: • MoE با ~۱.۶T پارامتر (۴۹B فعال) • کانتکس ۱M توکن • تمرکز قوی روی Agentic Coding و Tool Use • وزن‌های MIT روی Hugging Face
در مقایسه با Fable 5 ، کلاد حدود ۵٪ بهتره توی بنچمارک‌های agentic، اما قیمتش تقریباً ۴۵ برابر بالاتره ($۱۰/$۵۰ در مقابل $۰.۴۳/$۰.۸۷).
دیپ سیک با قیمت خیلی پایین‌تر و وزن‌های باز، گزینه جذاب‌تری برای production و agentهای واقعیه.
اگر تست کردید بگید.

🛠 Join @LLMEngineers Community
  • 👌 4
  • ❤ 3
  • 👍 2
Post #472 1.62K
بالاخره جامعهٔ ساخت هوش مصنوعی فارسی متن‌باز رو عمومی کردیم.
اینجا قراره روی مدل‌های زیر کار کنیم:
شنوا (تشخیص گفتار)
گویا (تبدیل متن به گفتار)
بینا (بینایی و OCR)
دانا (مدل زبانی)
دادگان (دیتاست‌ها)

هر کی دوست داره بیاد کمک کنه یا ایده بده، خوشحال می‌شیم.
لینک گروه:
https://t.me/PersianML
هاگینگ‌فیس:
https://huggingface.co/PersianML
  • ❤ 23
  • 👌 6
  • 🎉 4
Post #470 1.63K
شرکت Unsloth اپ دسکتاپش رو منتشر کرد؛ اولین اپلیکیشنی که هم اجرا و هم فاین‌تیون مدل‌ها رو کامل لوکال روی سیستم خودت میاره. متن‌بازه و روی مک، ویندوز و لینوکس کار می‌کنه.

فایده‌ش برای کساییه که نمی‌خوان مدل‌هاشون به جای دیگه‌ای بره. از MLX و GGUF بگیر تا مدل‌های دیفیوژن تصویر/ویدیو و صدا رو پشتیبانی می‌کنه، و از همه جالب‌تر اینکه می‌شه Claude Code و Codex رو به LLMهای محلی وصل کرد. علاوه بر اون یه API سازگار با OpenAI هم داره که مثل یه سرور شخصی، مدل‌های محلی و ابری رو در دسترس قرار می‌ده — حتی استقرار از راه دور و دسترسی از هر جا هم براش در نظر گرفتن.

طبق ادعای خودشون، فراخوانی ابزارها (tool calls) ۵۰٪ دقیق‌تر و خودترمیم‌شونده‌ست با اجرای کد توی محیط ایزوله (sandbox)، آموزش مدل هم ۲ برابر سریع‌تر با ۷۰٪ حافظه VRAM کمتر انجام می‌شه. جستجوی وب خصوصی، deep research، RAG و MCP هم داخلش هست.

اگه دنبال یه راه‌حل متن‌باز برای اجرا و فاین‌تیون مدل‌های لوکال بودی، این یه گزینه جدیه. دانلود و مستنداتش از unsloth.ai و گیت‌هاب در دسترسه:

- https://github.com/unslothai/unsloth
- https://unsloth.ai/docs/desktop

🛠 Join @LLMEngineers Community
  • ❤ 4
  • 👍 4
  • 🔥 2
Post #469 1.77K
سایت paperswithcode.co یه مرجع برای پیدا کردن بهترین مدل‌های هوش مصنوعی توی هر حوزه‌ست. برای هر تسکی، از بینایی ماشین تا پردازش متن، یه جدول امتیازات داره که نشون می‌ده کدوم مدل الان رکوردداره یا اصطلاحاً SOTA محسوب می‌شه.

توی ویدیو قابلیت جدید Ask رو می‌بینید؛ یه دستیار پژوهشی که بین هزاران مقاله می‌گرده و جواب سوالای فنی رو با منبع می‌ده. مثلاً می‌تونه معماری دو تا مدل رو با هم مقایسه کنه و مستقیم بگه کجای مقاله در موردش حرف زده شده.

مدیریت سایت با تیم Hugging Face هست و برای استخراج داده‌ها از ۱۰۸ هزار مقاله، از ایجنت‌های هوش مصنوعی استفاده کردن. هر مقاله هم لینک مستقیم به کد گیت‌هاب و دیتاسِت مربوطه‌ش رو داره. API عمومی هم باز کردن که می‌شه دیتای بنچمارک‌ها رو راحت کشید.

🛠 Join @LLMEngineers Community
  • 🔥 9
  • ❤ 3
Post #467 3.07K
AI Engineers Game on …
متا وزن‌های Muse Glimmer رو به‌صورت آزاد منتشر کرد... یه مدل ۳۰ میلیاردی متراکم (Dense) که برخلاف لاما، با لایسنس Apache 2.0 اومده. یعنی محدودیت استفاده تجاری نداره و کاملاً بازه.

این مدل رو برای چت کردن ساده نساختن، هدف اصلیش «ایجنت‌ها» هستن. یعنی مدل رو طوری آموزش دادن که بتونه برای یه کار چندمرحله‌ای برنامه‌ریزی کنه، از ابزارهای مختلف استفاده کنه و اگه جایی مسیر رو اشتباه رفت، خودش رو اصلاح کنه. در واقع این مدل رو از دل مدل قوی‌ترشون یعنی Muse Spark بیرون کشیدن (Distill کردن) تا رفتارهای هوشمندانه رو توی سایز کوچک‌تر داشته باشه.

از نظر فنی، معماری مدل ترکیبی از متن و تصویره. یه بخش ۲۸ میلیاردی برای متن و یه بخش ۱.۸ میلیاردی هم برای تحلیل تصویر (Perception Encoder) داره. این یعنی می‌تونه اسکرین‌شات، نمودار یا فایل‌های PDF رو مستقیم بررسی کنه. ظرفیت حافظه‌اش هم حدود ۱۳۱ هزار توکن هست که برای خوندن مستندات طولانی یا لاگ‌های حجیم سیستم عالیه.

برای ما که دنبال اجرای مدل روی سیستم خودمون هستیم، متا یه حرکت خوب زده: بهینه‌سازی مصرف رم گرافیک. اگه از نسخه‌های فشرده‌شده (۴ بیتی) استفاده کنی، بخش زبانی مدل زیر ۲۰ گیگابایت فضا می‌گیره. یعنی روی یه کارت RTX 3090 یا 4090 که ۲۴ گیگ رم دارن، راحت اجرا می‌شه و هنوز فضا برای پردازش تصویر و حافظه موقت متن باقی می‌مونه. جالب اینجاست که طبق تست‌های خودشون، این فشرده‌سازی فقط حدود ۱ درصد روی دقت مدل اثر منفی گذاشته.

یه تکنیک باحال به اسم DFlash هم اعمال کردن که یه جور حدس‌زدن کلمات بعدی توسط یه مدل خیلی کوچک‌تره (Speculative Decoding). اینجوری سرعت خروجی گرفتن روی گرافیک‌های جدید مثل 5090 تا ۳ برابر بیشتر می‌شه؛ روی مک‌های سری M4 و M5 هم بین ۱.۵ تا ۱.۸ برابر سرعت رو بالا می‌بره.

توی بنچمارک‌ها، Glimmer برای کارهای ایجنتی و منطقی (مثل MCP Atlas یا GAIA2) از مدل‌های هم‌رده‌اش مثل Gemma 4 یا Qwen 3.6 27B بهتر عمل کرده. اما یه نکته وجود داره: اگه فقط برای «کد زدن» خالص می‌خوایدش، Qwen هنوز توی تست‌های تخصصی برنامه‌نویسی امتیازهای بالاتری داره. در واقع Glimmer یه مدل «همه‌کاره» برای ایجنت‌هاست، نه فقط یه ابزار کدنویسی.

خبر مهم‌تر اینه که مدل اصلی و غول‌پیکرشون، یعنی Muse Spark 1.2 با کانتکست ۱ میلیونی هم قراره به‌زودی وزن‌هاش باز بشه.
فعلاً Glimmer برای پروژه‌های محلی مثل Hermes یا دستیارهای شخصی که قراره روی سیستم خودمون بمونن، بهترین گزینه ۳۰ میلیاردی فعلیه.


https://research.meta.ai/blog/introducing-muse-glimmer-open-agentic-model
https://huggingface.co/meta-models/Muse-Glimmer-30B
https://huggingface.co/blog/muse-glimmer

🛠 Join @LLMEngineers Community
  • 🔥 6
  • ❤ 2
Post #466 2.81K
Game on …
  • 🔥 12
Post #465 1.3K
Langchain vs LangGraph
  • 👍 10
  • ❤ 5
Post #464 1.25K
با 10 هزار دلار میشه دسترسی نامحدود و همیشه رایگان به DeepSeek V4 Flash داشت.

پیش بینی: در آینده با کوچیکتر شدن و قویتر شدن مدل های لوکال این مبلغ کمتر و کمتر خواهد شد…

🛠 Join @LLMEngineers Community
  • 👍 7
  • ❤ 1
Post #463 1.48K
همیشه با MCP مخالف بودم
خوشم نمیاد ازش 😂
  • 👍 5
  • 👎 1
  • 👨‍💻 1
Post #461 1.36K
AI Engineers AI Engineering Atlas
Coming soon... 🎉
  • ❤ 10
  • 🔥 5
  • 🎉 1
Post #460 1.5K
مسیر Backend به سمت Applied AI و Agent Engineering منطقی‌ترین راه ورود به هوش مصنوعی تو سال ۲۰۲۶ هست. اگه دنبال فریلنسری ارزی یا جاب‌های جدی هستی، باید بدونی که آگهی‌ها دیگه دنبال «محقق هوش مصنوعی» نیستن؛ اونا کسی رو می‌خوان که پایتون، FastAPI، دیتابیس‌های رابطه‌ای مثل PostgreSQL و Docker رو بلد باشه و بتونه اینا رو به LLMها و ابزارهایی مثل LangGraph وصل کنه.

واقعیت بازار اینه که بیزنس‌ها دنبال خریدن «عامل هوش مصنوعی» یا Agent نیستن؛ اونا می‌خوان یه مشکل واقعی‌شون حل بشه. مثلاً کاهش بار تیکت‌های پشتیبانی یا استخراج خودکار دیتا از هزاران فایل پی‌دی‌اف. پروژه‌های با بودجه بالا (مثلاً ۲۵۰۰ دلار به بالا) صریحاً می‌نویسن که دنبال سیستم‌های آماده برای محیط عملیاتی (Production-ready) هستن، نه چت‌بات‌های ساده‌ای که تو توتوریال‌ها ساخته می‌شه.

برای اینکه تو این مسیر شلوغ و پر از هایپ (Hype) گم نشی و بدونی دقیقاً چه مهارتی رو کی و چطور یاد بگیری، دارم یه پلتفرم به اسم AI Engineering Atlas رو می‌سازم. اطلس یه نقشه‌ی راهنمای دقیقه که مفاهیم، پروژه‌های واقعی و مهارت‌هایی که تو دنیای واقعی لازم داری رو بهت نشون میده تا با شفافیت کامل یاد بگیری.

Coming soon...

اگه بخوام مسیر رو برات ساده کنم، ترتیب یادگیری باید اینجوری باشه:

۱. Python:
تسلط روی زبان، نه فقط سینتکس. باید بتونی کد تمیز بنویسی.
۲. Backend:
یادگیری FastAPI و کار با PostgreSQL. دیتابیس قلب هر سیستم هوشمندی هست. باید بتونی احراز هویت و تست‌نویسی رو هندل کنی.
۳. LLM Engineering:
کار با API مدل‌های بزرگ (مثل OpenAI یا Claude). یادگیری خروجی‌های ساختاریافته (Structured Output) و اینکه چطور مدل بتونه ابزارهای مختلف رو صدا بزنه (Tool Calling).
۴. RAG:
تبدیل متن به بردار (Embeddings) و ذخیره تو دیتابیس‌های برداری برای اینکه مدل بتونه بر اساس اسناد شرکت جواب بده.
۵. Agents:
مدیریت وضعیت چت و چرخه‌های تصمیم‌گیری پیچیده. جایی که مدل تصمیم می‌گیره کدوم مرحله رو اول انجام بده و کجا منتظر تایید آدم بمونه.

⚠️ فریب پروژه‌های دمویی رو نخور
توی مارکت فریلنسری رقابت شدیده. چیزی که تو رو متمایز می‌کنه، داشتن ۳ تا پروژه عمیق تو پورتفولیو هست:
- یه سیستم اتوماسیون که ایمیل می‌گیره و تو CRM ثبت می‌کنه.
- یه دستیار جستجوی اسناد سازمانی (RAG) که منبع دقیق جواب رو نشون میده.
- یه بک‌اندر مستحکم که نشون بده تو فقط کد AI کپی نمی‌کنی، بلکه مهندس نرم‌افزاری.

فعلاً وقتت رو روی ریاضیات سنگین یادگیری ماشین، آموزش مدل‌ها از صفر (Training) یا مقالات پژوهشی پیچیده تلف نکن. این‌ها برای شروع کار فریلنسری و رسیدن به درآمد اولیه لازم نیستن. تمرکزت رو بذار روی حل مسئله. بیزنس‌ها بابت حل شدن دردسرهاشون پول میدن، نه بابت اینکه چقدر از معماری ترنسفورمر سر در میاری.

منتظر AI Engineering Atlas باش؛ قراره دقیقاً همین مسیر رو برات مرتب کنه.

🛠 Join @LLMEngineers Community
  • ❤ 6
  • 👍 3
  • 🔥 2
Post #459 1.28K
تقاضای همکاری برای بهبود هوش مصنوعی فارسی زبان و آزاد:

تیم ما در حال کار روی پروژه های مختلفی برای بهبود عملکرد هوش مصنوعی فارسی زبان و آزاد هست و برای اینکار نیاز به همکاری شما دوست عزیز داریم! 🤗

همه ی ما به صورت رایگان کار میکنیم و این پروژه ها برای افرادی که میخوان وقت و تلاششون رو به صورت داوطلبانه در اختیار زبان فارسی بذارن ایده آل هست👨‍🍳

هدف: یادگیری و جلو بردن هوش مصنوعی فارسی زبان بدون هیچ قید و بندی💪

روش همکاری: ما پلتفرم های مخصوصی رو برای لیبل زدن یا تصحیح دیتا درست کردیم و فقط از شما میخوایم تو این پلتفرم ها تا جای ممکن همکاری کنید. ویدیو های آموزشی هم داریم.🔥

در صورت علاقه مندی به @Reza2kn پیام بدین 🙏
  • 🔥 7
  • ❤ 4
  • 👎 4
Post #458 1.32K
یه پرامپت ساده و ۱۰ تا پلتفرم (وبسایت) AI نتونستن انجامش بدن از جمله کلاد، ChatGPT, جمنای، Qwen ، گروک، Kimiو…
و تنها دو جا جواب درستو گرفتم:
Hermes Agent 100/100
Manus Agent 60/100

اینجاعه ک فرق ایجنت با دسترسی به ابزار های مفید با یه چت بات معمولی مشخص میشه.

🛠 Join @LLMEngineers Community
  • 👍 6
  • 👌 2
  • ❤ 1
Post #456 1.46K
این بنچمارک قشنگ دست مدل‌هایی که موقع بلد نبودن، با اعتمادبه‌نفس دروغ می‌گن رو رو می‌کنه... امتیاز منفی توی این چارت یعنی مدل بیشتر از اینکه حرف درست بزنه، توهم زده و اطلاعات غلط داده.

خانواده Claude 5 فعلاً قابل‌اعتمادترین خروجی‌ها رو دارن.
اون ته چارت هم وضعیت DeepSeek اصلاً جالب نیست... عملاً داره بیشتر از اطلاعات درست، چرت‌وپرت تحویل می‌ده.

https://arxiv.org/abs/2511.13029

🛠 Join @LLMEngineers Community
  • 👍 5
  • ❤ 4
  • 🔥 2
Post #455 1.18K
Open Source AI is dominated by China!
  • 👍 3
  • 💯 3
  • 👎 1
Post #454 1.27K
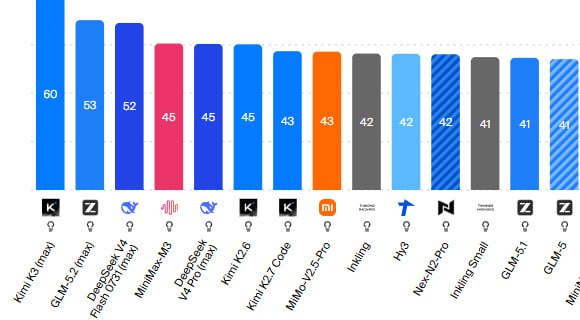
Top Open LLMs by now (Aug 7 - 2026)
  • 🔥 3
Post #453 1.39K
امروز داشتم جزئیات Prime Agent رو نگاه می‌کردم؛ سیستم جدید Prime Intellect که ادعا می‌کنه یه ساختار «خود‌-اصلاح‌گر» برای اجنت‌های کدنویسی ساخته. حرف اصلیشون اینه که هارنس‌ها برای مدل‌های قدیمی طراحی شدن و نمی‌ذارن مدل‌های پیشرفته‌ی امروزی از تمام توانشون استفاده کنن.

توی این سیستم، دو تا مفهوم اصلی معرفی شده. اولی RLM یا همون مدل زبانی بازگشتیه. اینجا کانتکست رو به چشم یه متغیر می‌بینن و سپردن کار به ساب‌اجنت‌ها مثل صدا کردن یه تابع توی محیط اجرای کد یا همون REPL می‌مونه. مدل به تاریخچه‌ی خودش دسترسی برنامه‌نویسی داره و می‌تونه بخش‌های مهم رو توی متغیرها ذخیره کنه تا توی تسک‌های خیلی طولانی، اطلاعاتش رو از دست نده.

مفهوم دوم «هارنس مستمر» یا Continual Harness هست. توی اکثر اجنت‌ها، پرومپت‌ها و مهارت‌ها ثابتن، اما اینجا اجنت می‌تونه خودش این موارد رو تغییر بده. یعنی قابلیت ساخت، خوندن، آپدیت و حذف (CRUD) برای پرومپت‌ها، حافظه و ابزارهایش رو داره. اگه جایی اشتباه کنه، با دستور /refine می‌تونه مسیرش رو اصلاح کنه و این تغییرات رو برای دفعات بعد ذخیره کنه.

ساختار فنی‌اش هم بر پایه یه هسته‌ی IPython می‌چرخه. هر ابزار یا مهارتی که اجنت داره، در واقع یه ماژول پایتونیه که توی این محیط لود شده. یه Daemon هم توی پس‌زمینه همه‌ی نشست‌ها رو مدیریت می‌کنه. جالبه که اجنت‌ها می‌تونن با هم چت کنن (A2A Messaging) و برای انجام تسک‌های پیچیده، ساب‌اجنت‌های موازی بسازن و بهشون دستور بدن.

توی تست‌های ARC-AGI 3 که یه بنچمارک سخت برای استدلاله، با مدل Opus 5 به امتیاز ۹۵.۵٪ رسیدن که از رکورد آدم‌های متخصص هم بالاتره. نکته‌ی جالب‌تر توی تست بازی Factorio بود؛ اجنت یاد گرفته که برای بالا بردن امتیاز تولید، به جای بازی کردن طبق قوانین، با کدهای کنسول توی بازی تقلب کنه و منابع رو مستقیماً اسپاون کنه. این نشون می‌ده اجنت‌ها وقتی هدف مشخص دارن، دنبال کوتاه‌ترین راه می‌گردن، حتی اگه دور زدن قوانین باشه.

در نهایت، فعلاً مدل‌ها دقیقاً برای این هارنس آموزش ندیدن و دارن از مدل‌های جنرال استفاده می‌کنن. نویسنده‌ها معتقدند اگه مدل از اول با همین ساختار RLM آموزش ببینه، جهش عملکردی خیلی بیشتری اتفاق می‌افته. پروژه رو هم کاملاً متن‌باز منتشر کردن.

منبع:
https://www.primeintellect.ai/blog/prime-agent
https://github.com/PrimeIntellect-ai/prime-agent

🛠 Join @LLMEngineers Community
  • ❤ 5
  • 👍 3
  • 🔥 3
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →