
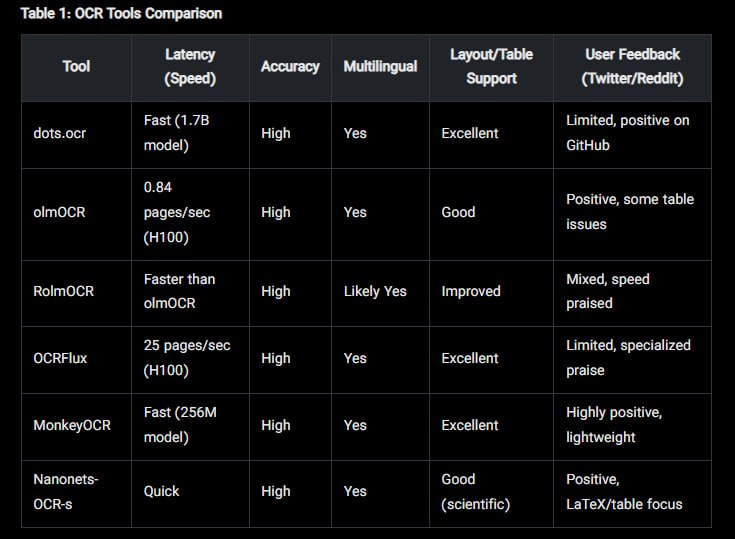
مقایسه ابزارهای OCR و PDF parsing بر اساس سرعت، دقت و بازخورد کامیونیتی
ابزار Smoldocling با حجم خیلی کم (زیر ۵۰۰ مگابایت VRAM) میتونه هر صفحه رو روی یه GPU معمولی توی فقط ۰.۳۵ ثانیه پردازش کنه. نکتهی جالبش اینه که توی بنچمارکها مدلهای ۲۷ برابر بزرگتر از خودشو شکست داده.
مدلهایی مثل dots.ocr و MonkeyOCR برای پردازش اسناد چندزبانه جداول پیچیده و حفظ ساختار کلی داکیومنت عملکرد فوقالعادهای دارن. MonkeyOCR با اینکه فقط ۲۵۶ میلیون پارامتر داره، روی اسناد انگلیسی حتی از مدلهای بزرگ مثل Gemini 2.5 Pro هم بهتر عمل کرده. ابزار olmOCR هم دقت بالایی داره ولی بعضی کاربرها توی ردیت گزارش کردن که با جداول پیچیده کمی مشکل داره و گاهی دچار hallucination میشه.
اگر با اسناد علمی، فرمولهای LaTeX و جداول پیچیده سروکار دارید، Nanonets-OCR-s (که بخشی از Mathpix هست) بهترین عملکرد رو داره. برای استخراج از PDF ایزار llamaparse گزینهی خیلی خوبیه. این ابزار برای استخراج جداول و عناصر بصری از دل PDF های پیچیده بهینه شده و مستقیماً برای این کار ساخته شده.
🛠 Join @LLMEngineers Community
Post #116
751

- ❤ 9