TGViewer
Channel Public Channel
Linux Ready | DevOps

Linux Ready | DevOps

@linux_ready

Авторский канал по разработке на Linux.
Ресурсы, обучения, задачи, шпаргалки.
Ежедневно информация пополняется!

Cотрудничество: @energy_c
Subscribers
11.2K
Photos
1K
Videos
73
Links
540

Showing posts older than #1477 · Back to latest

Older Posts 20 shown
Post #1475 2.06K
👍 Полезная статья на Хабре: «Как я искал себе читалку и придумал новый формат электронных книг для изучающих язык»!

В этой статье:
• Автор рассказывает, почему обычные EPUB/FB2 и существующие приложения оказались неудобны для чтения книг на иностранном языке;
• Показывает идею собственного открытого формата двуязычных книг, где перевод нужного фрагмента можно получить прямо во время чтения;
• Разбирает, как с помощью LLM создавать переводы для книг и превратить обычное чтение в инструмент постоянной языковой практики.

🔊 Продолжайте читать на Habr!

🚪 Linux Ready | #статья
  • 🔥 11
  • ❤ 8
  • 🤝 6
Post #1474 2.34K
📂 Напоминалка по работе почтовых серверов!

Например, SMTP отвечает за передачу писем между серверами, а IMAP позволяет почтовым клиентам получать доступ к сообщениям через сервер.

На картинке — полный путь электронного письма: от поиска MX-записи в DNS, обработки сообщения на почтовом сервере, постановки в очередь до доставки получателю.

Сохрани, чтобы не потерять!

🚪 Linux Ready | #ресурс
  • 🔥 12
  • ❤ 10
  • 👍 7
Post #1473 2.83K
✍️ linuxfullroadmap — пошаговый roadmap по изучению Linux!

В репозитории собран структурированный путь изучения Linux: от базовых команд и работы с терминалом до администрирования системы, управления процессами, файловой системой, пользователями, сетью и серверными инструментами. Материал поможет получить практическую базу для работы с Linux в разработке, DevOps и системном администрировании.

Оставляю ссылочку: GitHub 📱

🚪 Linux Ready | #репозиторий
  • 👍 16
  • ❤ 11
  • 🔥 6
Post #1472 3.45K
📂 Напоминалка для работы с MAC-адресами в Linux!

Например, MAC-адрес 6C:54:63:E2:31:76 состоит из 48 бит (6 байт): первые 3 байта (OUI) определяют производителя устройства, а последние 3 байта (NIC) — уникальный идентификатор сетевого интерфейса.

На картинке — структура MAC-адреса, формат записи, а также служебные биты U/L и I/G, которые определяют тип адреса и способ его назначения.

Сохрани, чтобы не потерять!

🚪 Linux Ready | #ресурс
  • 👍 18
  • 🔥 9
  • 🤝 6
  • ❤ 3
Post #1471 3.26K
Отслеживаем действия пользователей в Linux через auditd!

Обычная история команд в Linux не всегда помогает понять, что произошло на сервере. Файл history можно очистить, команды могут выполняться через скрипты, а некоторые действия вообще выполняются не через shell.

Для контроля изменений файлов и действий пользователей используется auditd. Он работает на уровне системного аудита и позволяет увидеть, какой процесс выполнил операцию и какой пользователь был связан с этим действием.

Проверяем состояние службы аудита:
systemctl status auditd


Добавим правило для отслеживания изменений файла конфигурации SSH:
sudo auditctl -w /etc/ssh/sshd_config -p wa -k ssh_config


Параметр -w указывает файл или каталог, за которым нужно следить. Опция -p wa означает отслеживание записи в файл (w) и изменения его атрибутов (a). Ключ -k добавляет идентификатор правила, по которому потом удобно искать связанные события.

Теперь изменим файл:
vim /etc/ssh/sshd_config


И найдём связанные события аудита:
sudo ausearch -k ssh_config -i


В выводе можно увидеть информацию о процессе и пользователе:
type=SYSCALL
comm="vim"
exe="/usr/bin/vim"
uid=1000
auid=1000
success=yes


Поле exe показывает, какой процесс выполнял действие. uid показывает пользователя, от имени которого выполнялся процесс, а auid — пользователя, который изначально вошёл в систему. Это важно, потому что при использовании sudo процесс может выполняться от имени root, но исходный пользователь будет сохранён в auid.

Например:
ivan -> sudo vim /etc/ssh/sshd_config

uid=0
auid=1000


Теперь видно, что действие выполнялось с правами root, но инициировал его пользователь ivan.

Например, нужно понять, кто изменил или удалил файл приложения:
sudo auditctl -w /opt/app/config.yml -p wa -k app_config


После удаления файла:
rm /opt/app/config.yml


Проверяем событие:
sudo ausearch -k app_config -i


В результате можно увидеть процесс, который выполнил операцию, и пользователя, от которого она была выполнена:
uid=deploy
auid=deploy
exe=/usr/bin/rm
success=yes


Важно понимать, что auditd записывает не историю введённых команд, а системные действия. Например, файл может удалить не только rm, но и скрипт или приложение. В журнале будет информация о фактическом процессе, который выполнил операцию.

Также можно отслеживать изменения целых каталогов. Например, контроль изменений файлов systemd:
sudo auditctl -w /etc/systemd/system -p wa -k systemd_changes


После изменения unit-файлов ищем события:
sudo ausearch -k systemd_changes -i


Для постоянного хранения правил их добавляют в конфигурацию audit:
/etc/audit/rules.d/custom.rules


Например:
-w /etc/nginx/nginx.conf -p wa -k nginx_change


После изменения правил необходимо загрузить новую конфигурацию:
sudo augenrules --load


Правила, созданные через auditctl, являются временными и исчезнут после перезагрузки. Файлы в /etc/audit/rules.d/ позволяют сохранить настройки постоянно.

Для современных систем также стоит учитывать, что правила через -w являются старым форматом. Более гибкий вариант — использовать syscall-based правила, например:
-a always,exit -F path=/etc/nginx/nginx.conf -F perm=wa -k nginx_change


При создании правил для больших каталогов нужно учитывать нагрузку на систему. Например, аудит всего / может привести к большому количеству событий и дополнительной нагрузке на сервер.

🔥 auditd помогает разобраться, что произошло в Linux: какой пользователь изменил файл, какой процесс выполнил действие и было ли оно успешным.

🚪 Linux Ready | #практика
  • ❤ 10
  • 👍 9
  • 🔥 7
Post #1469 2.26K
📂 Напоминалка для работы с Logical Volume Manager!

Например, lsblk помогает посмотреть структуру дисков, pvs, vgs и lvs показывают информацию о физических, групповых и логических томах, а lvextend позволяет расширить хранилище без переразметки диска.

На картинке — основные компоненты LVM: Physical Volume, Volume Group и Logical Volume, а также команды для создания, просмотра, изменения и управления дисковым пространством.

Сохрани, чтобы не потерять!

🚪 Linux Ready | #ресурс
  • 👍 11
  • ❤ 8
  • 🔥 8
  • 🤝 2
Post #1468 2.3K
🐱 Вышла интересная статья на Хабре: «Что такое LiteLLM и для чего его едят»!

В этой статье:
• Разбирается, как с помощью LiteLLM объединить работу со 100+ LLM-провайдерами через единый OpenAI-совместимый API;
• Показывается настройка LiteLLM в Docker, подключение разных моделей, fallback-механизмы, кэширование запросов и встроенный веб-интерфейс;
• Объясняется, как упростить интеграцию ИИ в проекты, избежать привязки к одному провайдеру и снизить расходы на использование моделей.

🔊 Продолжайте читать на Habr!

🚪 Linux Ready | #статья
  • 👍 11
  • ❤ 5
  • 🔥 5
Post #1467 2.1K
Что происходит при вызове sync и зачем используются drop_caches?

Во время диагностики производительности или тестирования файловой системы нередко встречаются рекомендации выполнить:
sync
echo 3 | sudo tee /proc/sys/vm/drop_caches >/dev/null


Эти команды часто используют вместе, однако они решают разные задачи. Чтобы понимать, когда их действительно стоит применять, важно разобраться, что происходит внутри ядра Linux.

Когда приложение записывает данные в файл, они обычно не сразу попадают на устройство хранения. Ядро сначала размещает их в page cache, помечая соответствующие страницы как dirty. Это позволяет объединять множество небольших операций записи в более крупные и снижать количество обращений к диску.

Проверить объём таких страниц можно командой:
grep -E "Dirty|Writeback" /proc/meminfo


Пример:
Dirty:             18432 kB
Writeback: 0 kB


Значение Dirty показывает объём данных, ожидающих записи, а Writeback — объём страниц, которые в данный момент уже записываются фоновыми потоками ядра.

Команда:
sync


не очищает page cache и не освобождает память. Она инициирует запись всех изменённых страниц и метаданных файловой системы в нижележащее хранилище и завершается после окончания этих операций. Итоговые гарантии сохранности данных зависят от файловой системы, устройства хранения и его политики кэширования.

Если в системе в этот момент нет новых операций записи, после выполнения sync значение Dirty обычно становится близким к нулю.

Команда:
echo 3 | sudo tee /proc/sys/vm/drop_caches >/dev/null


работает иначе. Она освобождает объекты, которые ядро может безопасно восстановить при необходимости. Значение 1 очищает page cache, 2 — кэш dentry и inode, а 3 очищает оба типа кэша одновременно.

Поэтому на практике сначала выполняют:
sync


а затем:
echo 3 | sudo tee /proc/sys/vm/drop_caches >/dev/null


Без предварительного sync часть страниц может оставаться изменённой (dirty), и ядро не сможет освободить их до завершения записи.

Проверить эффект можно с помощью:
grep -E "Cached|Buffers|SReclaimable|MemAvailable" /proc/meminfo


или:
free -h


При этом важно понимать, что уменьшение значения Cached не означает сопоставимого увеличения MemAvailable. Page cache и без принудительной очистки автоматически освобождается ядром при возникновении нехватки памяти и является частью нормальной работы Linux.

На практике drop_caches используют в основном перед сравнительным тестированием производительности файловой системы, чтобы исключить влияние уже закэшированных данных. Для «очистки памяти» на рабочих серверах эта команда обычно не применяется, поскольку после удаления кэша системе потребуется заново считывать данные с устройства хранения, что зачастую приводит к временному снижению производительности.

🔥 sync обеспечивает синхронизацию накопленных изменений с устройством хранения, а drop_caches освобождает восстанавливаемые структуры памяти. Эти механизмы предназначены для диагностики и тестирования, а не для регулярной оптимизации работы системы.

🚪 Linux Ready | #практика
  • 👍 12
  • 🔥 9
  • ❤ 5
Post #1465 2.06K
😎 Awesome tmux — большая подборка ресурсов по tmux!

Здесь собраны полезные плагины, готовые конфигурации, статьи, руководства и инструменты, которые упрощают работу с несколькими терминальными сессиями и делают повседневную разработку значительно удобнее.

Оставляю ссылочку: GitHub 📱

🚪 Linux Ready | #репозиторий
  • ❤ 10
  • 👍 7
  • 🔥 5
  • 🤝 2
Post #1464 2.17K
📂 Напоминалка по регулярным выражениям (Regex)!

Например, \d позволяет найти любые цифры, ^ и $ — проверить начало и конец строки, а (?=...) и (?<=...) помогают искать совпадения с учетом контекста без включения его в результат.

На картинке — основные возможности регулярных выражений: классы символов, квантификаторы, группы, диапазоны, якоря, экранирование спецсимволов, флаги, Unicode-свойства и lookaround-утверждения.

Сохрани, чтобы не потерять!

🚪 Linux Ready | #ресурс
  • 🔥 14
  • 🤝 9
  • ❤ 6
  • 👍 2
Post #1463 1.9K
Знали, что lsof уже не единственный и далеко не самый удобный способ искать открытые файловые дескрипторы?

В util-linux 2.40+ утилита lsfd поддерживает встроенный механизм фильтрации, поэтому не нужно строить длинные цепочки из grep и awk.

Например, найти процессы, которые всё ещё держат удалённые файлы:
lsfd -Q 'DELETED'


Или посмотреть только UNIX-сокеты:
lsfd -Q '(TYPE == "UNIX" || TYPE == "UNIX-STREAM")'


А если интересует конкретный процесс:
lsfd --pid 12345


Фильтрация выполняется самой утилитой, поэтому она сразу выводит только нужные записи без лишней обработки.

🔥 lsfd удобен при расследовании утечек файловых дескрипторов, зависших логов, проблем с размонтированием файловых систем и поиске процессов, удерживающих файлы после удаления.

🚪 Linux Ready | #совет
  • 👍 17
  • ❤ 6
  • 🔥 6
  • 👎 1
Post #1461 1.92K
📂 MySQL JOIN: шпаргалка по объединению таблиц!

Разобраны способы объединения таблиц, получение связанных данных, поиск совпадающих и отсутствующих записей, а также использование EXISTS и NOT EXISTS для проверки связей между таблицами.

На картинке — основные типы JOIN в MySQL с примерами SQL-запросов и визуальным объяснением.

Сохрани, чтобы не потерять!

➡️ SQL Ready | #ресурс
  • ❤ 15
  • 👍 10
  • 🔥 8
Post #1460 2.11K
Диагностика производительности дисковой подсистемы с помощью iostat!

При анализе проблем производительности обычно проверяют загрузку CPU и использование памяти, однако причиной задержек нередко становится дисковая подсистема.

Например, сервис начинает отвечать значительно медленнее:
curl http://localhost:8080/api


При этом загрузка процессора остаётся на уровне 20–30%, память не испытывает дефицита, а процессы работают без ошибок. В такой ситуации стоит проверить состояние устройств хранения.

Для этого используется iostat из пакета sysstat. Утилита отображает статистику работы блочных устройств и помогает определить, связаны ли задержки с вводом-выводом. Запуск:
iostat -yxz 1


Ключ -y пропускает первый отчёт, содержащий статистику с момента загрузки системы, -x включает расширенную статистику, -z скрывает устройства без активности, а 1 задаёт интервал обновления в одну секунду. Пример:
Device      r/s    w/s   await   %util
sda 120 80 45.2 98.7


Наиболее полезные показатели: r/s и w/s — количество завершённых запросов чтения и записи в секунду, await — среднее время выполнения операций ввода-вывода, включая ожидание в очереди, %util — доля времени, в течение которого устройство было занято обработкой запросов.

Высокий await указывает на рост задержек ввода-вывода. Значение %util, близкое к 100%, говорит о высокой загрузке устройства, однако для современных SSD и NVMe эту метрику следует оценивать вместе с await, поскольку сама по себе она не всегда означает насыщение устройства.

Если наблюдается высокая нагрузка, следующий шаг — определить процесс, создающий её:
iotop


Для общей оценки состояния системы полезно также выполнить:
vmstat 1


Если одновременно растут значения await в iostat и wa в vmstat, это является сильным признаком того, что снижение производительности связано с ожиданием операций ввода-вывода. Однако для окончательных выводов результаты следует анализировать в контексте всей системы. Для анализа конкретного устройства:
iostat -yxz nvme0n1 1


Важно учитывать, что iostat показывает состояние устройств, но не источник нагрузки. На практике его обычно используют вместе с iotop, pidstat -d и vmstat.

🔥 iostat позволяет понять, имеются ли признаки проблем на уровне дисковой подсистемы и выбрать дальнейшее направление диагностики.

🚪 Linux Ready | #практика
  • 🔥 13
  • 👍 9
  • ❤ 7
  • 🤝 2
Post #1458 1.91K
📂 Шпаргалка по команде less!

Например, less /var/log/syslog используется для постраничного просмотра больших файлов и системных журналов без загрузки всего содержимого в оперативную память.

На картинке основные возможности less: навигация (Space, b, g, G), поиск вперёд и назад (/, ?, n, N), просмотр обновляемых логов (F), переходы между файлами, отображение номеров строк и дополнительные параметры запуска.

Сохрани, чтобы использовать в работе!

🚪 Linux Ready | #ресурс
  • ❤ 10
  • 👍 7
  • 🔥 6
Post #1457 1.87K
Анализ времени загрузки через systemd-analyze!

При длительной загрузке сервера после перезагрузки не требуется вручную анализировать каждый сервис. systemd сохраняет информацию о процессе запуска и позволяет определить компоненты, которые влияют на время старта системы.

Первый этап анализа — общее время загрузки:
systemd-analyze


Пример вывода:
Startup finished in 4.2s (kernel) + 35.8s (userspace) = 40.0s


kernel показывает время загрузки ядра, а userspace — время запуска systemd, сервисов и пользовательского пространства. На некоторых системах дополнительно отображаются этапы firmware, loader и initrd.

Если основная задержка находится в userspace, дальнейший анализ выполняется через systemd юниты и их зависимости. Для поиска юнитов с длительной активацией используется:
systemd-analyze blame


Пример:
45.231s docker.service
32.814s NetworkManager-wait-online.service
18.502s nginx.service


Команда показывает время активации юнитов, но не является точным показателем их влияния на общую загрузку. systemd запускает множество компонентов параллельно, поэтому результат требует дополнительной проверки.

Для анализа реальной цепочки зависимостей используется:
systemd-analyze critical-chain


Пример:
multi-user.target @40.012s
└─docker.service @35.421s +4.580s
└─network-online.target @35.400s
└─NetworkManager-wait-online.service @2.561s +32.814s


Символ @ показывает момент активации юнита, а + — продолжительность его запуска. Такой вывод позволяет определить, какой компонент находится в критической цепочке и задерживает достижение target.

Один из частых случаев — NetworkManager-wait-online.service, который ожидает готовности сети перед продолжением загрузки. На серверах без необходимости ждать полного поднятия сети он может увеличивать время старта, однако отключение этого сервиса требует проверки зависимостей от network-online.target.

Для визуального анализа процесса загрузки:
systemd-analyze plot > boot.svg


Файл boot.svg содержит временную диаграмму запуска юнитов и позволяет увидеть параллельные процессы, последовательные зависимости и точки задержек.

Для проверки конкретного сервиса:
systemctl status docker.service


Время запуска основного процесса можно получить командой:
systemctl show docker.service -p ExecMainStartTimestamp


А причины ошибок и тайм-аутов анализируются через журнал systemd:
journalctl -b -u docker.service


Для предыдущей загрузки:
journalctl -b -1 -u docker.service


Отключать сервисы только на основании systemd-analyze blame некорректно. Перед изменением конфигурации необходимо проверить назначение юнита, наличие зависимостей и сообщения в журнале.

🔥 systemd-analyze позволяет определить проблемный этап загрузки, найти критические зависимости и локализовать причину задержки без ручного просмотра большого количества конфигурационных файлов.

🚪 Linux Ready | #практика
  • 🤝 12
  • 👍 9
  • 🔥 8
  • ❤ 2
Post #1455 1.61K
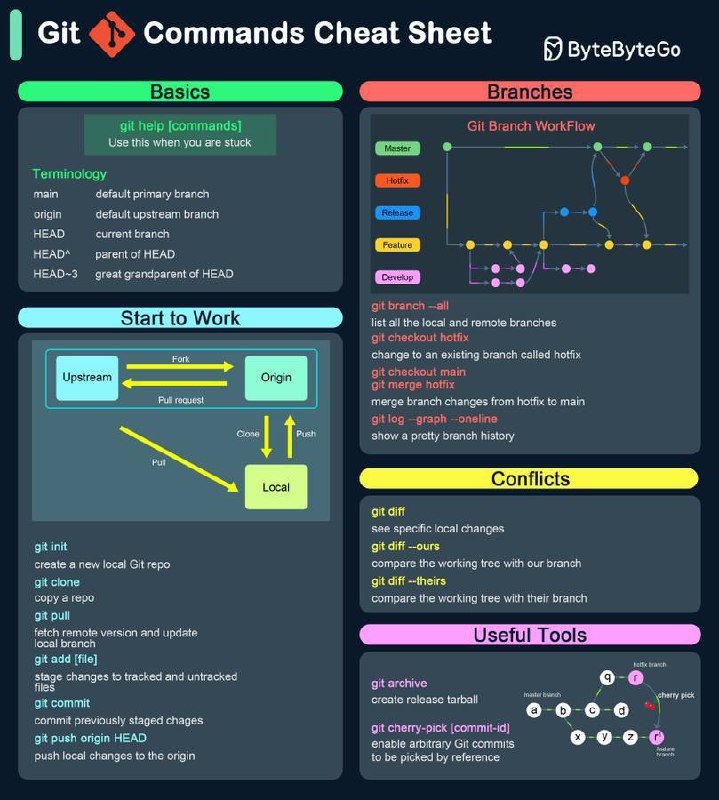
📂 Напоминалка по Git для разработчиков!

Например, git add подготавливает изменения к коммиту, git commit фиксирует состояние проекта в истории, а git branch и git merge позволяют управлять ветками разработки.

На картинке — базовый набор Git-команд, необходимых для ежедневной работы в команде.

Сохрани, чтобы не потерять!

🚪 Linux Ready | #ресурс
  • 👍 14
  • ❤ 8
  • 🔥 5
Post #1454 1.74K
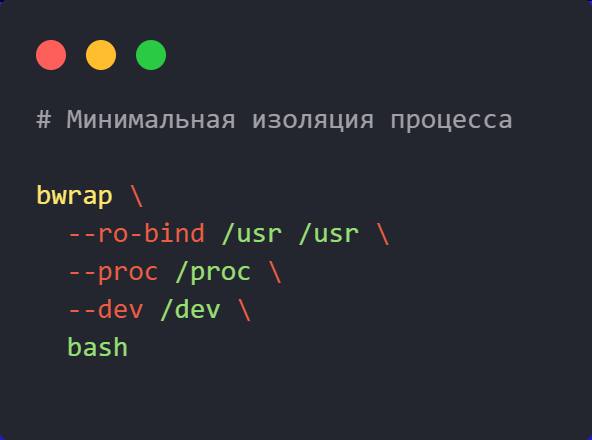
В Linux можно запустить программу в изолированной среде без Docker и виртуальной машины!

Для тестирования скриптов, сборки проектов или проверки поведения программ часто создают контейнеры. Но иногда полноценный контейнерный стек просто не нужен.

Bubblewrap (bwrap) использует Linux namespaces и позволяет создавать минимальное sandbox-окружение одной командой. Во многих системах это работает без root (если разрешены user namespaces):
$ bwrap \
--ro-bind /usr /usr \
--ro-bind /bin /bin \
--dev /dev \
--proc /proc \
--tmpfs /tmp \
bash


Внутри этой оболочки процесс видит только те файлы и ресурсы, которые вы явно ему предоставили.

Например, можно дать программе доступ только к конкретному каталогу:
$ bwrap \
--bind ./project /app \
--chdir /app \
bash


Теперь работа идёт внутри отдельного пространства, а изменения можно ограничить указанными каталогами.

Можно запускать тестовые скрипты или проверять сборку без изменения основной системы:
$ bwrap \
--ro-bind /usr /usr \
--bind ./test-env /tmp \
./test.sh


Например, Flatpak использует Bubblewrap для изоляции приложений.

🔥 bwrap — это минимальный контейнерный инструмент без Docker: быстрый способ проверить программу в отдельном окружении и не засорять основную систему.

🚪 Linux Ready | #совет
  • ❤ 12
  • 👍 10
  • 🔥 9
  • 🤝 2
Post #1452 1.8K
✍️ Крайне информативная статья вышла на Хабре: «Ваш docker-compose.yml сломается: 5 настроек, которые все забывают»!

В этой статье:
• Разбираются пять важных настроек Docker Compose, которые стоит использовать в продакшене;
• Показывается, как правильно настроить лимиты ресурсов, restart policy, ротацию логов и healthcheck;
• Объясняется, почему резервное копирование volumes помогает избежать потери данных при сбоях и ошибках.

🔊 Продолжайте читать на Habr!

🚪 Linux Ready | #статья
  • ❤ 10
  • 👍 8
  • 🔥 6
  • 🤝 1
Post #1451 1.62K
Управляем ресурсами процессов через cgroups v2!

При эксплуатации серверов снижение производительности нередко связано с постепенным ростом потребления ресурсов одним из сервисов. В результате уменьшается объём доступного процессорного времени и памяти для остальных процессов, что отрицательно влияет на стабильность всей системы.

Для управления ресурсами в Linux используется механизм control groups (cgroups). Он позволяет ядру учитывать и ограничивать потребление CPU, памяти, дискового ввода-вывода и количество задач, включая процессы и потоки.

В большинстве современных дистрибутивов по умолчанию используется cgroups v2. Проверить это можно командой:
findmnt -t cgroup2


или:
stat -fc %T /sys/fs/cgroup


Если используется cgroups v2, в последнем случае будет получен вывод:
cgroup2fs


В системах с systemd процессы сервисов автоматически размещаются в отдельных cgroups, поэтому ограничения ресурсов обычно задаются средствами systemd.

Например, ограничить объём памяти для сервиса можно следующим образом:
systemctl set-property nginx.service MemoryMax=1G


После применения параметра systemd устанавливает соответствующее ограничение для cgroup сервиса. При достижении лимита ядро сначала пытается освободить память, а если это невозможно, OOM-механизм memory cgroup может завершить один или несколько процессов.

Следует учитывать, что MemoryMax ограничивает не только анонимную память приложения, но и учитываемый page cache. Проверить текущие значения можно командой:
systemctl show nginx.service -p MemoryCurrent -p MemoryMax


Для анализа текущего потребления ресурсов удобно использовать:
systemd-cgtop


Утилита отображает активные cgroups, текущее использование CPU и памяти, объём ввода-вывода и количество задач, что позволяет быстро определить сервис, создающий основную нагрузку.

Ограничение использования процессора задаётся аналогичным образом:
systemctl set-property worker.service CPUQuota=50%


Значение CPUQuota=50% соответствует половине времени одного логического процессора, а CPUQuota=200% позволяет использовать до двух логических процессоров. Ограничение распространяется на суммарное использование CPU всеми процессами, входящими в cgroup сервиса.

Количество процессов и потоков можно ограничить следующим параметром:
systemctl set-property worker.service TasksMax=200


Это предотвращает неконтролируемое создание задач и снижает риск исчерпания системных ресурсов.

Постоянные ограничения удобно задавать через override-конфигурацию:
systemctl edit worker.service


Например:
[Service]
MemoryMax=2G
CPUQuota=200%
TasksMax=500


После изменения конфигурации сервис необходимо перезапустить:
systemctl restart worker.service


🔥 Механизм cgroups работает на уровне ядра и применяет ограничения к группе процессов независимо от языка программирования или способа запуска приложения. На основе cgroups v2 реализованы механизмы управления ресурсами в systemd и большинстве современных контейнерных платформ.

🚪 Linux Ready | #практика
  • 👍 15
  • 🔥 6
  • ❤ 5
  • 🤝 1
Post #1449 1.65K
📂 Напоминалка по типам IPv6-адресов!

Например, Global Unicast используется для глобальной маршрутизации, Link-Local — для связи внутри локального сегмента, а Multicast заменяет broadcast и позволяет отправлять данные группе устройств.

На картинке — основные типы IPv6-адресов, их префиксы, назначение и примеры использования.

Сохрани, чтобы не потерять!

🚪 Linux Ready | #ресурс
  • 👍 16
  • ❤ 8
  • 🔥 5
  • 🤝 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →