
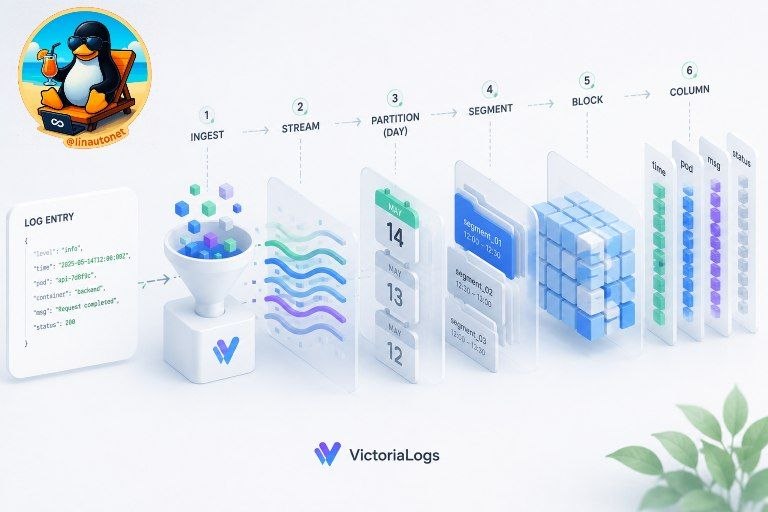
Хороший подробный разбор внутреннего устройства VictoriaLogs — от приёма записи до её хранения на диске.
Для тех, кто эксплуатирует VictoriaLogs или выбирает замену Loki/ELK. Разбирается весь путь лога: приём → поток → раздел → сегмент → блок → колонка.
Что внутри:
🟩Потоки (streams) — логи с одинаковыми stream fields (например,
pod, container) лежат на диске рядом. Отсюда правило: поля потока должны быть стабильными и низкокардинальными.🟩Суточные разделы — retention удаляет целые дни, а запрос с ограничением по времени трогает только нужные разделы.
🟩Колоночное хранение — каждое поле лежит в своей колонке. Поэтому
| fields time, host, msg в LogsQL — это не косметика, а реальное сокращение чтения с диска.🟩Фильтры Блума — дешёвая проверка «точно нет / возможно» перед чтением значений. Большинство блоков отбрасывается без чтения.
🟩Файлы сегмента — что такое
metaindex.bin, index.bin, values.binN, bloom.binN и почему на диске иногда «внезапно много файлов».Главная мысль: запросы быстрые не из-за магии, а потому что на каждом уровне отсекается лишнее — сегменты по времени, блоки по потоку, колонки по полям, блоки по фильтрам Блума.
Полезно не только для тюнинга, но и для troubleshooting: понимаешь, какие флаги и метрики смотреть, когда что-то тормозит.
Программировать и знать Go не нужно — статья рассчитана на админов и SRE.
#devops #sre #logging #victorialogs #victoria #observability #sysadmin #мониторинг