
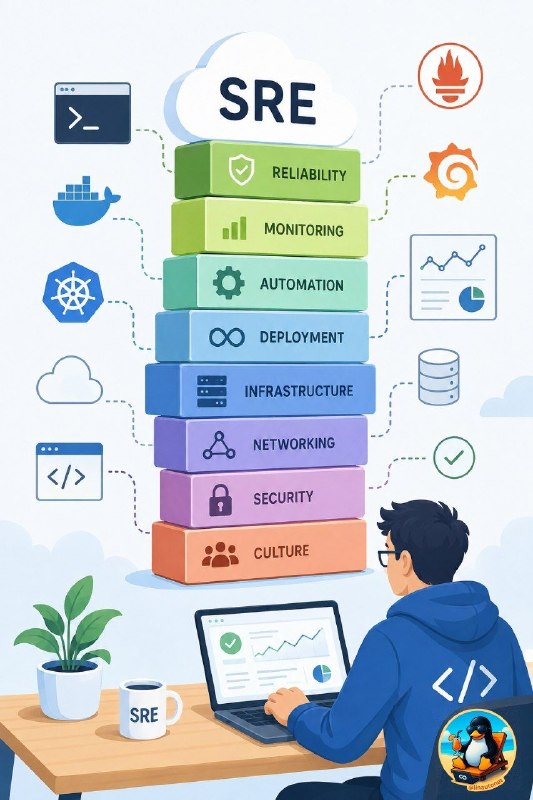
SRE — это не только Kubernetes, Prometheus и Grafana.
Хороший SRE должен разбираться сразу в нескольких областях: Linux, сетях, мониторинге, автоматизации, безопасности, CI/CD и работе с инцидентами.
В проекте The Way of SRE это собрано в одну большую карту навыков.
Например, в разделе Networking есть вполне практичные вещи:
🟢TCP/IP, DNS, HTTP, TLS
🟢
ping, traceroute, dig, curl🟢анализ трафика через
tcpdump🟢
ss, iptables, nftables🟢L4/L7 балансировка
🟢retries, timeouts, circuit breaker
И это хороший пример того, зачем SRE нужны крепкие сетевые знания.
Потому что
curl: timeout — это ещё не диагноз Нужно понять, где именно ломается путь запроса: DNS, TCP, TLS, балансировщик, приложение или сеть.
Кроме технических навыков, в карте есть Incident Response, On-Call, postmortem, безопасность, SLO и культура эксплуатации.
В итоге SRE — это не набор инструментов, а подход к тому, чтобы системы работали стабильнее, быстрее диагностировались и становились надёжнее после каждого сбоя.
Telegram😍
Tg чат🌐
YouTube🌐
VK🌐
Rutube📺
#devops #sre #linux