TGViewer
Channel Public Channel
LakoMoor

LakoMoor

@lakomoordev

Что-то на непонятном

Для связи: @lvlinfinite

Оущитпостинг: https://t.me/+fihOK0UNpSg3ZjIy
Subscribers
310
Photos
366
Videos
88
Links
185
Recent Posts 19 shown
Post #1504 83

Forwarded from Щитпостинг Круглого Тензора

Claude: не буду я тебе портировать движок GTA V на раст... это незаконно

OpenAI: А давай еще членов туда добавим и карту из спанч боба?
  • 🍌 8
Post #1503 150
Папищики, скиньте норм датасеты для обучения под кодинг. Rust и python в приоритете
  • 🤗 2
Post #1500 213
Сейчас с помощью Codex и Claude пишу с нуля переимплементацию движка X-Plane — OpenXplane.
Вдохновился проектом openOMSI.

У меня довольно большой налёт в X-Plane, в основном на популярных коммерческих самолётах. Раньше я сам работал в авиации, поэтому вся эта тема мне давно интересна.

В какой-то момент наткнулся на openOMSI. В своё время я очень любил проводить время в OMSI 2, а сейчас авторы openOMSI фактически заново реализуют движок игры: добавили нормальную поддержку x64, подтянули графическую часть и продолжают восстанавливать поведение оригинала.

Мне проект настолько понравился, что я даже портировал его на WebGPU:
https://lakomoor.github.io/WebOmsi

И в итоге решил попробовать сделать нечто подобное уже для X-Plane.
Сейчас OpenXplane постепенно собирается по кусочкам. На момент написания поста примерно 35% системы реализовано, а около 21% поведения подтверждено как идентичное оригинальному симулятору.
Проект не содержит исходного кода X-Plane. Вместо этого исследуется поведение оригинального симулятора, его форматы данных и отдельные алгоритмы, после чего совместимая реализация пишется с нуля — в том числе с активным использованием coding-агентов.

Основной стек — Rust + wgpu, как и в openOMSI.

Уже постепенно появляются парсинг самолётов и airfoil-файлов, OBJ8, flight model, физика, двигатели, DataRefs, аэропорты и собственный renderer. До полноценного симулятора ещё очень далеко, но фундамент уже есть.

OpenXplane:
https://openxplane.github.io/openXplane
  • 🦄 7
  • 🤗 4
  • 🐳 2
Post #1495 350
Стоит и смотрит
  • 🐳 5
  • 🤗 3
  • 🦄 1
Post #1494 374
Тимур П. Спасибо за донат 🫣
  • 🐳 3
  • 💯 1
Post #1492 5.4K
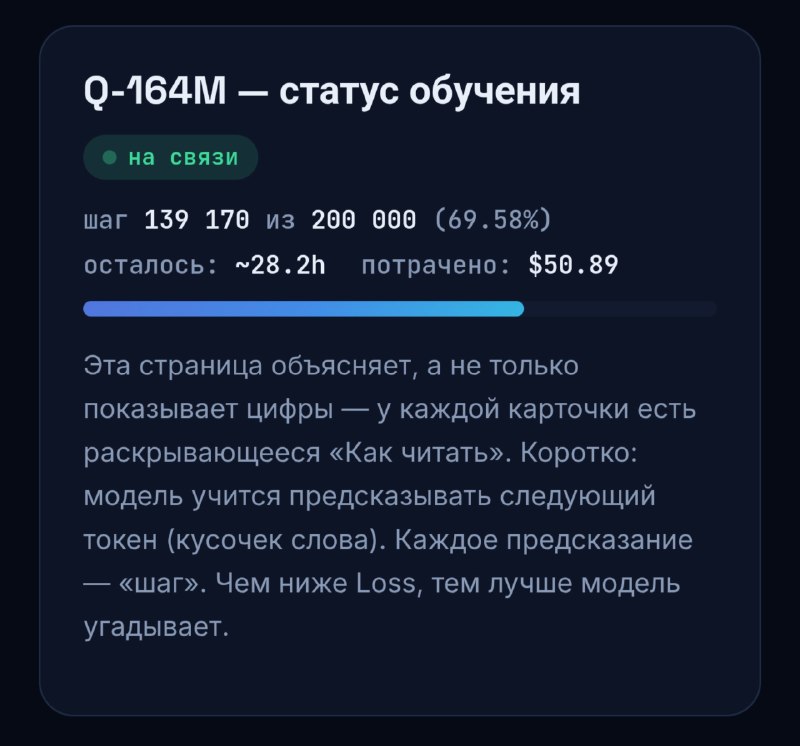
Q-164M и Q-U-164M — новые модели от Q-Project, обучены с нуля на одной GPU.

Q-164M — 164.6M параметров, претрейн на 13.1 млрд токенов (FineWeb-Edu). Тернарные веса {-1, 0, +1}, без обучаемой embedding-таблицы, и механизм точных вызовов инструментов: модель решает, когда посчитать, а сам расчёт делает детерминированный исполнитель — арифметика всегда точная.

Q-U-164M — тот же чекпоинт, дообученный для диалога (chat-SFT + RL). Ушло 5 итераций, чтобы починить потери вызова инструментов в живом многоходовом диалоге.

модель только английская, русский не понимает. Общие знания слабые, вне задач с инструментами часто ошибается.

Сравнили с другими маленькими моделями через свой бенчмарк QBench (без подсказок инструментам): заметно уступает Qwen2.5-0.5B (втрое крупнее) почти везде — кроме TruthfulQA, там чуть впереди. Но модель обучалась на одной V100, а не на кластере.

🔗 Ссылка на веса: https://huggingface.co/collections/q-project/q-164m
💻 Код: https://github.com/Q-Project-LM/Q-164M
💬 Чат в браузере: https://q-project-lm.github.io/chat/
📊 QBench: https://huggingface.co/spaces/q-project/QBench
📝 Разбор: https://q-project-lm.github.io/blog-q164m.html
⚖️ Лицензия: apache-2.0

Если хотите поддержать эксперименты и обучение более крупных моделей — буду благодарен за помощь со сбором на GPU 🙄

❤️ Поддержать проект: https://t.tb.ru/pm_short/4v90jPi6NPZ

💘U💘
  • 🦄 10
  • 🤗 3
Post #1488 372

Forwarded from Щитпостинг Круглого Тензора

У.
  • 🍌 4
Post #1487 411
LakoMoor https://q-project-lm.github.io/blog-q164m.html Прозрачность обучения новой архитектуры
Скоро
  • 🐳 9
Post #1483 407
NLP Wanderer Halo: почти год моей работы в White Circle теперь в опенсорсе Почти год я веду в White Circle разработку Halo - фреймворка для тренировки LLM, на котором мы учим все свои модели. Внутри он работал давно как замена Мегатрона, но до публичного релиза пришлось…
https://huggingface.co/LakoMoor/GLM-4.7-Flash-Coder-GGUF

Выложил GGUF. Пользуйтесь
huggingface.co LakoMoor/GLM-4.7-Flash-Coder-GGUF · Hugging Face We’re on a journey to advance and democratize artificial intelligence through open source and open science.
  • 💯 5
  • 🤗 1
Post #1482 350
LakoMoor Короче, гпу даже в lspci перестала отображаться. https://www.tbank.ru/cf/3WetELIxMhK Сбор на новую-старую видюху. Сейчас у меня осталась одна v100 на 16гб. И даже для реализации grpo ее не хватит.
Возможно если получится собрать всю сумму, то dgx spark

Забудьте. Там цена в 500к руб
  • 👨‍💻 6
  • 🐳 2
Post #1481 350
Короче, гпу даже в lspci перестала отображаться.

https://www.tbank.ru/cf/3WetELIxMhK
Сбор на новую-старую видюху.

Сейчас у меня осталась одна v100 на 16гб. И даже для реализации grpo ее не хватит.
  • 🤗 5
  • 🐳 1
Post #1480 271

Forwarded from NLP Wanderer

Halo: почти год моей работы в White Circle теперь в опенсорсе

Почти год я веду в White Circle разработку Halo - фреймворка для тренировки LLM, на котором мы учим все свои модели. Внутри он работал давно как замена Мегатрона, но до публичного релиза пришлось догнать transformers, TRL и vLLM, добавить модели и упростить адопшен - образы, CLI, документация. Подробный блогпост - на сайте White Circle.

Если вы файнтюните открытые модели, то наверняка упирались в: модель уже не лезет в TRL и обычный FSDP, но связываться с Megatron и конвертацией чекпоинтов еще рано или просто не хочется. С MoE все еще хуже, без Expert Parallelism их по большому счету не потренировать. Halo добавляет EP, Context, Tensor и Expert-Tensor Parallelism прямо поверх обычных классов HuggingFace: на вход HF модель, на выходе HF модель. Новое MoE семейство подключается оберткой меньше 140 строк (у Megatron-Bridge на то же самое уходит 600-1900), сейчас их 15.

Немного цифр, все на B300, воспроизводимы из репо:
- 2.3-2.8x throughput относительно стокового TRL на gpt-oss-20b при тех же кернелах, loss совпадает в пределах ~1%.
- Gemma 4 26B-A4B на 2 GPU: 7.2k tok/s против 3.2-5.0k у NeMo AutoModel, Axolotl, Megatron Bridge, MS-SWIFT и Unsloth.
- Оптимизатор целиком в bf16 со стохастическим округлением: 120 GB состояния вместо 240 для 20B.

Все это првоерялось на реальных кластерах B300/B200/H200/H100 а топология заложена вплоть до NVL72: невалидные раскладки отбрасываются еще на этапе конфига. Запускается через torchrun, accelerate или halo CLI, в репо есть рецепты под SLURM, SkyPilot, RunPod и Nomad. Большая часть года ушла на то, чтобы все это не разваливалось на всех комбинациях моделей и параллелизмов - тестов в репозитории больше, чем кода. При этом работать будет также и на современных консьюмерских GPU.

Отдельная моя гордость - Async RL. vLLM или SGLang живут в отдельном контейнере, роллауты идут асинхронно через Ray, веса уезжают по NCCL (по EFA 53-80 GB/s, gpt-oss-120b обновляется за 3-4 секунды), а генерации во время синка не обрываются. Внутри routing replay, importance sampling с масками, обучение на токенах, которые насэмплил движок, и 11 встроенных сред - от code contests и SWE до тулов через MCP. По механикам это сопоставимо с verl и Miles, только на HF-моделях и без Megatron.

Для студентов и тех, кто только начинает, Halo, мне кажется, хорошая точка входа. Все запускается из одного docker-образа: halo launch sft config.yaml, а QLoRA Qwen3-4B занимает 7.9 GB и должна работать на 3090/4090. Документации больше 170 страниц, отдельно советую прочитать лекцию GPU Training Theory: база того как работают такие фреймворки, почему эксперты в MoE упираются в память, а не в compute, и почему в EP-шаге 88% времени - это all-to-all. Там же честно написано, что не помогает и что тихо ломает, например TF32 по умолчанию в NGC-образе, портящий RoPE после 2048 токенов.

Выложили и модель - GLM-4.7-Flash-Coder, 30B MoE под агентские скаффолды: SFT на 7.8k успешных траекторий GLM-5.1, на SWE-rebench-V2 pass@1 вырос с 33.2% до 41.7%, а модель сама научилась вызывать тулы параллельно. Она уже слегка устарела, но как гайд по агентскому SFT актуальна.

Код мы пишем с агентными скаффолдами и сильными моделями вроде Claude Fable и Opus, репозиторий под это спроектирован. Контрибьт приветствуется, но через фильтр: сначала issue и approve мейнтейнера, потом PR. Главное правило - понимать свой код: с AI писать можно, но это нужно раскрыть, а тесты должны падать, когда ломается поведение.

Дальше больше: Pipeline Parallelism (все уже в коде, но докатим после полных тестов) и серия блогов про тренировку, например про async RL для code contests. Лицензия Apache 2.0.

P.S. Если помните такую вещь как SMPO из времен Vikhr, то он теперь тоже живет там, но уже с EP и CP и улучшениями.
  • 🐳 6
Older posts →

About this channel

How can I read @lakomoordev without a Telegram account?
TGViewer shows the public web preview Telegram publishes for LakoMoor: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does LakoMoor have?
LakoMoor (@lakomoordev) has 310 subscribers on Telegram, refreshed roughly every 30 minutes.
Does LakoMoor know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →