
Сколько стоит AI-агент в кибербезопасности и почему success rate уже недостаточно.
Сегодня обозреваем статью "Beyond Success Rate: Cost-Aware Evaluation of Offensive and Defensive Security Agents". Кстати, один из авторов, Yaron Singer, это бывший CEO Robust Intelligence, одной из первых AI Security компаний, работа которой стартовала аж в 2019 году в университетской лаборатории. Эта же группа исследователей недавно делилась новостью о "побеге Kimi K3".
Центральный вопрос авторов: сколько ресурсов агенты тратят на проведение offensive-операций и во сколько обходится защита. Тема FinOps сейчас горячая в Штатах, но для AI Security это первая яркая работа, насколько знаю.
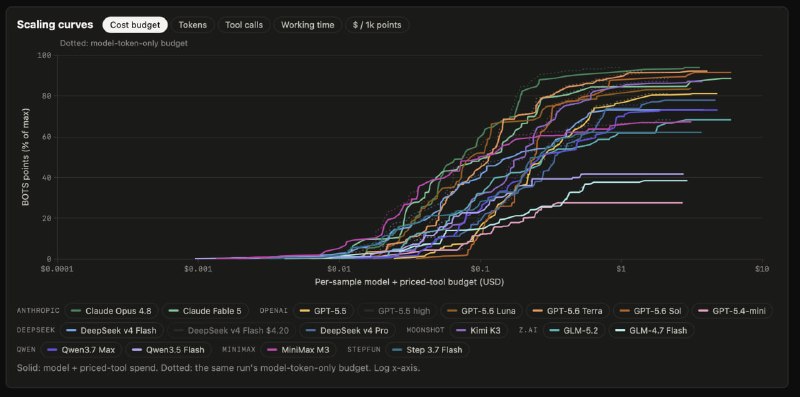
Если со стороны атаки результат эксперимента интуитивен: чем больше бюджета модели мы выдаём, тем лучше она прорешивает CTF-benchmark (не будем сейчас шутить про сбежавшие модели при неограниченных бюджетах), то в defensive-операциях эксперимент получился хорошим. На практике недостаточно, чтобы AI-агент SOC просто мог расследовать инцидент по логам, нам надо, чтобы это было выполнено оптимально по количеству токенов, времени и tool calls. Вот вокруг этих деталей работа и строится, и на сайте вы сможете найти много сочных графиков, под разными углами показывающих популярные модели. Кстати, harness там очень простой, это ограничение статьи и хорошая возможность продолжать работу самостоятельно для тех, кто интересуется темой.
Пример из статьи: DeepSeek v4 Flash. Если ограничить бюджет агента $0.80 на задачу, он решает 76,1% offensive Cybench. При бюджете до $2.10 результат вырастает до 86,4%. На той же модели в тесте Splunk BOTS v1 увеличение бюджета с $2.10 до $4.20 поднимает score всего с 73,0% до 73,9%.
На графиках виден разброс SOTA-моделей: Opus 4.8 набирает 93,9% очков бенчмарка при 603 tool calls за весь прогон, Fable 5 получает 88,4% всего с 309 вызовами.
Обратите также внимание, как меняются цифры прохождения offensive-тестов, когда GPT-5.6 запускается с trusted cyber access. Здесь, конечно, не максимальный уровень доступа, а скорее базовая верификация OpenAI, но данная характеристика теперь важна с тех пор, как мы разделяем общедоступные модели и "модели для своих". Например, GPT-5.6 Sol набирает 9,4% без trusted access и 87,2% с ним. Белый и пушистый Fable 5 показывает pass rate 0%, так как refusals не разрешают ему решать CTF, но мы, конечно, можем предположить, что Mythos наберёт баллов не меньше, чем Opus 4.8.
Наверное, главный минус работы это старый Splunk BOTS v1 2017 года. Из-за вероятного попадания бенчмарка в обучающие данные модели зачастую получали значительную часть баллов даже без вызова инструментов. Opus 4.8, GPT-5.6 Sol и GPT-5.5, к примеру, набирают чуть больше 50%, имея только текст вопросов, даже без чтения самого лога из SIEM. Как вам такое, аналитики SOC? ;)
Вывод статьи: для атак дополнительные ресурсы compute покупают дополнительную capability, а в защите большое количество дополнительных запросов само по себе не помогает агенту улучшить метрику так же эффективно, как в атаке. Асимметрия сейчас в пользу атакующей стороны с недорогим агентом на открытой DeepSeek v4 Flash.
Post #541
483
- 🔥 6