
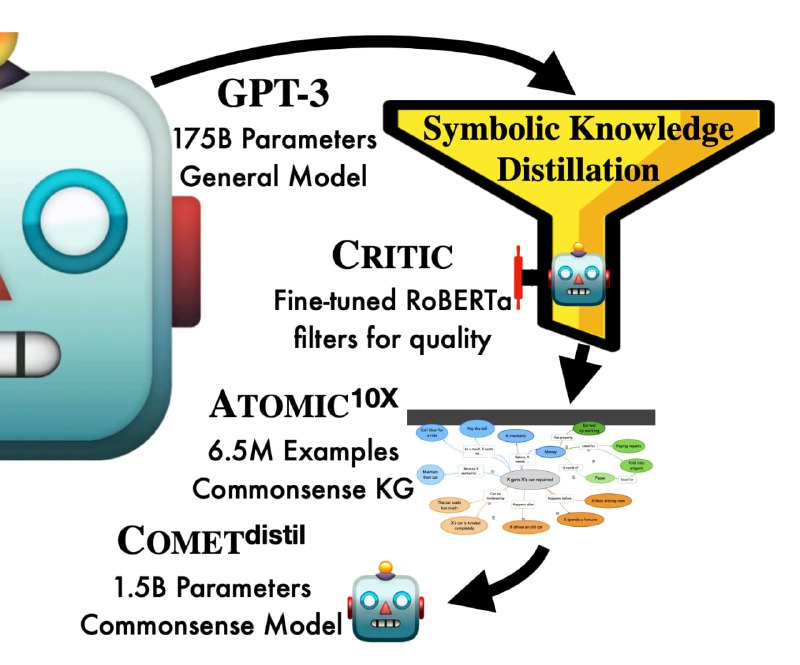
Это работа, на мой взгляд, более удачно пытается извлекать знания о мире из языковой модели.
В работе используется база знаний ATOMIC, состоящая из триплетов:
<событие, отношение, вывод>, где событие и вывод - это какие-то 2 текстовых утверждения, а отношение - это один из нескольких видов причинно-следственной связи между ними. Например, отношение xNeed - это когда вывод является условием для события.Авторы используют GPT-3, чтобы расширить эту базу знаний:
1) Сначала генерируются
события, подавая в качестве промпта отобранный сет из хороших существующих событий из ATOMIC.2) Для каждого
отношения подбираются примеры пар <событие, вывод> из ATOMIC, и составляется промпт следующего вида:— Вопрос. Например, для xNeed: "что должно произойти, чтобы произошло
событие?"— Примеры пар из базы atomic
— Сгенерированные
события из пункта 1Таким образом генерируются соответствующие
выводы для событий.3) Обучают дополнительную RoBERTa, которая отличает ложные триплеты от истинных, и фильтруют сгенерированные триплеты по ней
4) Дистиллируют маленькую языковую модель (GPT-2 😁) на этих триплетах
Качество триплетов оценивается людьми - просят поставить Accept/Reject/NA. Исходный ATOMIC это полмиллиона триплетов с рейтингом 87%, дополнительно генерируется 6 миллионов триплетов с рейтингом 78%, но после отсечения RoBERTa остаётся 2.5 миллиона с рейтингом 96%. Авторы исследуют датасет и делают вывод, что с качеством данных и их разнообразием всё в порядке. А дистиллированная GPT-2 показывает лучший результат на commonsense-вопросах, чем исходная модель - вероятно, засчёт увеличения качества датасета.
Мне эта история нравится, я думаю, что это шаг в правильную сторону. Кроме того, сама идея триплетов с причинно-следственными отношениями это, на мой взгляд, круто, я думаю, что поверх подобных данных можно учить нейросетевую картину мира, и в комбинации с логическим выводом мы получим протооракула.
@knowledge_accumulator