
Language Models are Open Knowledge Graphs [2020] - строим графы знаний с помощью языковой модели
Уже многие десятилетия в сфере ИИ существует понятие графов знаний - в них вершины это сущности (то, что описывается существительными), а рёбра это "отношения" между ними. Например, могут быть вершины "Альберт Эйнштейн" и "Нобелевская премия", и между ними может быть ребро "получить награду".
На заре ИИ, когда оптимизм лился из ушей, люди решили, что они сейчас построят граф всех знаний человечества и получат сверхумную машину, но оказалось, что сделать это вручную нереально. В нынешние времена возникают попытки строить такие графы знаний автоматически. Об одном из вариантов поговорим сегодня.
В рассматриваемой работе применяется LLM для извлечения фактов, записанных в тексте:
1) С помощью утилиты spaCy находим в предложениях пары сущностей head и tail, между которыми потом будем извлекать отношение.
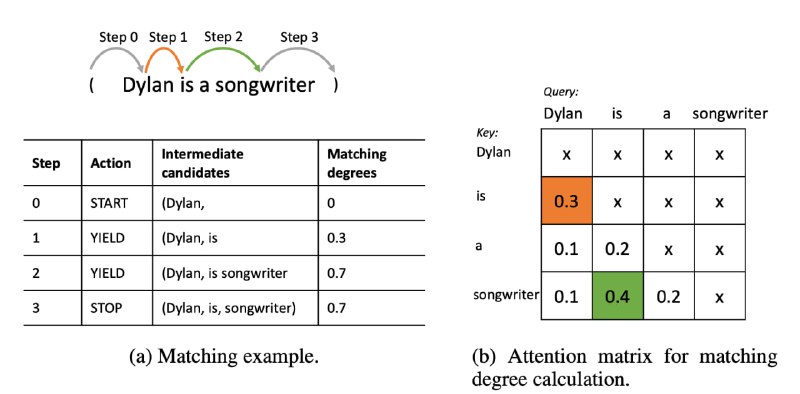
2) См. картинку. Применяем любую LLM к куску текста от head до tail включительно. Берём матрицу attention. Теперь начинаем набирать по 1 токену в текст их отношения.
- Изначально у нас только токен [head].
- Смотрим на attention между последним добавленным токен и остальными токенами, которые ещё не добавляли. Добавляем тот, у которого наибольший attention. Если это токен tail, то поиск завершается.
3) Получившихся "кандидатов" [head, some text, tail] мы дополнительно фильтруем различными эвристиками и пытаемся их соотносить (с помощью сторонних NLP-утилит) с сущностями из существующих графов знаний для валидации фактов.
Я здесь упростил много деталей, но не нахожу их важными. Тут часовой обзор статьи от Янника.
Результаты не представляют особого интереса - обилие костылей и алгоритм, который использует матрицу внимания, которая учится совсем для другого, не позволяют совершить прорыв - результат немного превышает SOTA 2015-го года. Видимо, картину мира нам нужно строить совсем другим образом.
@knowledge_accumulator
Post #52
1.82K
- 👍 7
- ❤ 3
- 🔥 3
- 😁 2
- 😢 1