
Tree Transformer [2019] - учим грамматику языка без размеченных данных.
Инженеры много думают о способах ограничения мощности трансформера, так как оригинальная схема Self-Attention считается избыточной и потому излишне затратной.
Продажа качества за скорость это хорошо, но ещё интересна продажа качества за интерпретируемость - это интересно и с точки зрения исследования, и с точки зрения приложений. Один из вариантов купить интерпретируемость предлагается в данной работе.
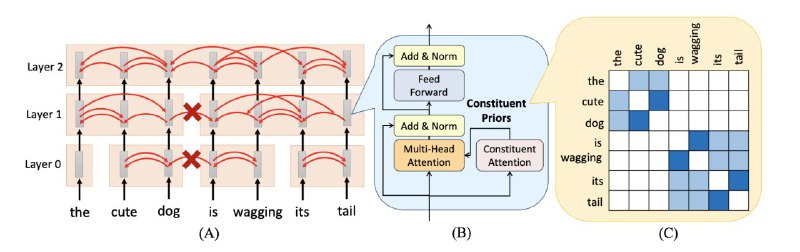
Авторы предлагают слой под названием Constituent Attention, который заставляет модель разбивать токены на группы, которые составляют иерархию и обеспечивают многоэтажное разбиение предложения на смысловые части.
Как это работает?
1) Слой выдаёт query и key (другие) для каждого токена.
2) Между каждой парой соседних токенов считается score на основе этих query и key.
3) Эти скоры нормируются (чтобы как раз ограничить модель от полного attention), и далее из них считается альтернативная матрица attention - например, между 3 и 5 токеном attention равен произведению скоров между 3 и 4 и между 4 и 5. Интуитивный смысл этих чисел - вероятности того, что 2 токена принадлежат к 1 группе.
4) Чтобы получилась иерархия, с каждым слоем трансформера мы добавляем эти скоры к предыдущим.
5) Этот альтернативный attention домножается поэлементно на обычный attention.
А причём тут грамматика?
Применяя эту модель к тексту и считая эти скоры принадлежности к одной группе, мы можем простой эвристикой получить дерево токенов, отражающее грамматическую структуру текста. Бэйзлайны в задаче парсинга грамматики алгоритм бьёт, но я в этом не специалист.
Может быть, у подобной идеи есть потенциал и в других сферах ML. Кто его знает?
@knowledge_accumulator
Post #48
1.78K
- 👍 12