
Одному человеку, как и мне, не понравилась статья про Hierarchical Reasoning Model. Он тоже хотел написать о том, какая она отстойная, и чтобы все поржали. Но у него созрел хитрый план. Чтобы привлечь хайп, он придумал свою статью с новой моделью, и оформил обсёр HRM как аж 2 главы в ней.
Мой пост про HRM был уже написан после прочтения этой, так что самое интересное про HRM я уже рассказал. А теперь пришло время посмотреть, что же предлагает критик в качестве альтернативы. Встречайте, Tiny Recursive Model.
Иерархичность, биологические аналогии, хитровыведенные градиентные аппроксимации - всё это на помойку.
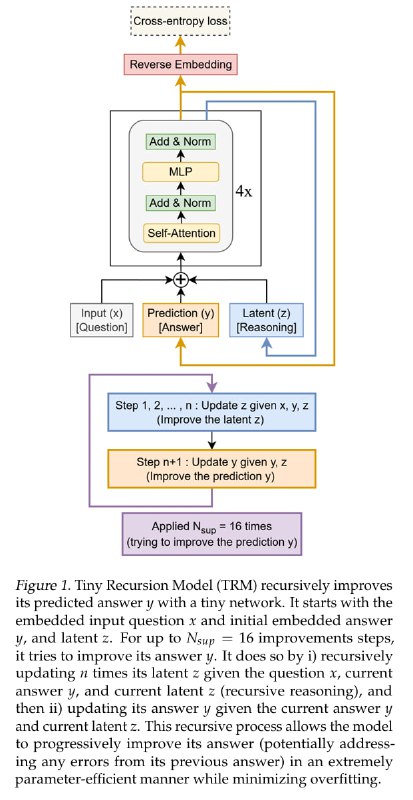
Просто, твёрдо и чётко, заводим 2 скрытых состояния - y и z. Из первого мы в конце строим финальный ответ, а второе это пространство для latent reasoning. Будем использовать одну и ту же сетку для обновления обоих. Если мы подаём в неё входные данные, y и z, то выходом будет новый z. А если подаём в неё только y и z, то выход используем, как новый y.
Один цикл применения TRM это
n обновлений состояния z и 1 обновление скрытого состояния y, и потом из y отдельной головой получается ответ. Вместо кринжовых отмазок про Fixed Point Theorem, как в HRM, здесь автор говорит - да я просто не хочу пропускать градиенты через несколько циклов применения TRM, и буду пропускать его только через последний. Как оправдывается автор этой работы?
Он интерпретирует свой подход как многошаговый процесс приближения
y ко всё более и более хорошему вектору-кандидату y, типа как в диффузионных моделях. Модель обучается в парадигме "сделай эти скрытые состояния ближе к правде", и много этих применений подряд дают хорошее решение.Давайте ещё раз поймём разницу между подходами, потому что на первый взгляд, это 2 вида одного и того же скама. Оба подхода применяют к скрытому состоянию T * n раз какую-то модель. В HRM градиенты пропускаются внутри каждого n-ного шага в течение всего процесса, А в TRM градиенты пропускаются внутри последних n шагов.
Вообще-то, на второй взгляд, это всё ещё 2 вида одного и того же скама. Можно сказать, что в TRM градиенты текут сквозь цельное применение модели, и поэтому оценка градиента по всему процессу получается более честной. Хз.
Спор может разрешить столкновение лоб в лоб. Согласно Ablation, если в TRM начать использовать эту самую 1-step gradient, как в HRM, то точность падает с 87% до 56.5%. Из текста я не понял, начинает ли он пропускать градиенты в предыдущих итерациях применения, как это делается в HRM. Если нет, то автор героически победил соломенное чучело.
В TRM тоже есть early stopping и голова, предсказывающая, что пора остановиться. Но вместо использования RL, который, как все знают, terrible, автор отменяет delayed reward и учит голову на то, правильный ли ответ получился на текущем шаге.
Автор провёл небольшой ресёрч по скейлингу качества HRM и TRM с увеличением количества применений и глубины рекурсии. Кажется, что ни тот, ни тот, особо не улучшаются после n=3, T=3, а TRM вообще быстро начинает дохнуть по памяти. Оба на пересдачу.
Дочитав эту статью, я попытался подумать - а в чём вообще смысл обеих работ? Мы что, до этого не знали, что можно применять базовую модель поменьше, но применять её побольше циклов, и жить станет веселее? Так вроде и так на это есть тренд в LLM. Причём, выглядит так, что даже текущие LLM скейлятся лучше, чем вот это семейство. Прорыв в чём пытаются сделать данные работы? Если прорыв в области жопы от того, на что ресёрчеры тратят время, то он достигнут.
@knowledge_accumulator