
В позапрошлом посте я выразил скептицизм по поводу offline RL, но в комментариях добрый человек посоветовал изучить более качественные работы на эту тему, за что ему спасибо. Берите пример!
Вкратце, суть предложенного алгоритма (
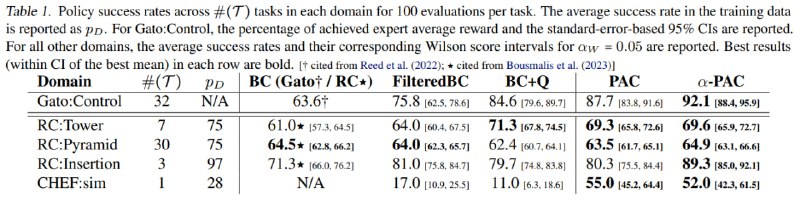
PAC) - мы обучаем стратегию, которая должна сходиться к оптимальной при наличии онлайн-данных, но, так как наши данные не меняются, мы добавляем регуляризацию на то, чтобы сильно не уходить от простого копирования стратегии в данных. Простите, RL-щики, за такое пошлое упрощение.Авторы сравнивают свой подход с обучением копированию стратегии из данных (тут это называется
BC + Q). Обучают серию моделей от 32M до 988M параметров и смотрят на то, как скейлятся оба алгоритма. По графикам из статьи видно, что в таком сравнении offline-RL выигрывает.Интересные детали видны при более детальном рассмотрении - на тех задачах, в которых данные собирались хорошей экспертной стратегией, ни
BC+Q, ни PAC, ни даже подтюненный a-PAC не догоняют эксперта. Тем не менее, если стратегия для сбора данных плохого качества, PAC умеет не копировать плохое поведение, за что ему похвала.Кроме этого, авторы попробовали добавить онлайн-составляющую в алгоритм. Выученный PAC выпускали погулять и собрать ещё немного данных. Далее запирали его вместе со старым и собранным датасетом и дообучали. На нескольких задачах авторы репортят довольно быстрый рост производительности за несколько итераций.
У такого полуонлайн-подхода есть проблема - от того, что мы запрещаем модели обновляться во время сбора нового датасета, получать данные дешевле не становится.
Я согласен с комментарием о том, что в таких работах очень многое завязано на реализацию конкретных алгоритмов, и поэтому сравнение с бейзлайнами может страдать. Именно поэтому я бы хотел, чтобы авторы алгоритмов сабмитили код в какой-нибудь сервис с лидербордом, в этом случае автор каждого алгоритма выжал бы из него максимум. Статьи - плохой формат.
@knowledge_accumulator