TGViewer
Channel Public Channel
Тру.Маркетинг | Первухин

Тру.Маркетинг | Первухин

@kineticaagency

Я, Артем Первухин, продакшн-директор KINETICA, и моя команда пишем в канале о digital-маркетинге: разбираем тренды, новые технологии и кейсы.

Сайт — https://kinetica.su
Подкаст — https://clck.ru/36HRoz

Для личных сообщений @kinetica

Рекламы нет!
Subscribers
7.42K
Photos
1.5K
Videos
24
Links
1K
Recent Posts 6 shown
Post #2565 3.04K
Привет! Сегодня релиз подкаста — у меня в гостях Евгения Григорьева, директор по маркетингу hh.ru 🚀

Разбираемся, как в этом живёт главная площадка рынка труда. Говорим о маркетинге компании, которая одновременно работает на миллионы соискателей и продаёт услуги работодателям, и о том, как балансировать между этими сторонами:

👉 Почему синие воротнички сейчас в дефиците, а белые - в профиците?
👉 Что будет с наймом, когда резюме пишет нейронка и читает тоже нейронка?
👉 Почему почти 20% пользователей заходят на hh.ru не за работой, а просто поскроллить вакансии и успокоиться?
👉 Как юмор и стендаперы привели на платформу молодёжь?
👉 Почему лидеру рынка больше нет смысла вкладываться в top of mind и куда идут деньги вместо этого?
👉 Какие компетенции маркетолога станут критичными через 3-5 лет?

И бонус в конце: история о том, как AI-агент «выгорел» 😁 🤖

✅ Выпуск будет полезен CMO и руководителям, которые строят бренд сразу для нескольких аудиторий, и всем, кто нанимает людей в 2026 году.

🎧 Слушать на Яндекс Музыке
🚀 Слушать в Telegram

Всем лидов и классных кандидатов, а кандидатам хороших предложений 🫡❤️
  • 🔥 13
  • 👍 10
  • 👏 5
  • ❤‍🔥 4
  • ⚡ 3
  • 🐳 3
Post #2557 2.78K
⚡️llms.txt: можно ли управлять и блокировать ИИ при обходе сайта?

Продолжаем #seoразбор. Сегодня про llms.txt: помогает ли этот файл попадать в ответы ИИ или просто добавляет галочку в аудите..

Короче, сделали тест у себя в GEO-LAB.

✔️ Состояние 1. Файла нет

Ozon: /llms.txt возвращает 404. При этом robots.txt на месте и живёт полноценной жизнью.

✔️ Состояние 2. Файл есть, сделан всерьёз

DNS: помимо robots.txt, на сайте есть подробный llms.txt в формате Markdown.

Внутри: структура каталога, точки входа, паттерн URL товарных карточек, разделы поддержки и возвратов, ссылки на конфигураторы, отдельный блок Notes for AI systems.

Тут две важные детали:

✔Файл на английском - у российского ритейлера с русскоязычной аудиторией.

✔И его содержимое дублирует то, что уже есть в sitemap.xml и в навигации сайта.

Сам файл о себе пишет честно: это описательный документ, а не набор правил.

✔️ Состояние 3. Файл «есть»

М.Видео: /llms.txt отдаёт 200 OK. Мы проверили отдельно, потому что не поверили.

Внутри - HTML главной страницы. Это SPA на Angular: приложение возвращает index.html на любой неизвестный адрес. В теле подключение Google Tag Manager, preload шрифтов Roboto, тег <mvid-root>. Markdown отсутствует.

И там же, в этом самом HTML: html <meta name=""keywords"" content=""null"">

Мёртвый мета-тег со значением null - на странице, которую сайт отдаёт вместо файла для ИИ.

🤓 Почему третий случай важнее двух первых? Код 200 означает, что любой автоматический чекер зачтёт этот сайт как «llms.txt внедрён». Галочка в аудите стоит. Файла нет.

И это никого не побеспокоило. Если бы кто-то читал llms.txt и от этого зависел результат, подмену бы заметили — по логам, по отчётам, по эффекту. Не заметили, потому что эффекта, за которым следят, нет.

🕵️ Что говорит Google. Тред в r/TechSEO: автор положил llms.txt в корень блога и через месяц не увидел в логах обхода никакой реакции. Спросил, у кого есть система отслеживания и заметил ли кто-нибудь эффект.

В комментарии ответил Джон Мюллер из Google:

Насколько мне известно, ни один из ИИ-сервисов не заявлял, что использует LLMs.TXT (и по серверным логам видно, что они даже не проверяют его наличие). По-моему, это сопоставимо с мета-тегом keywords — это то, чем владелец сайта объявляет свой сайт… (А сайт действительно такой? Ну, это можно проверить. И раз так — почему бы просто не проверить сам сайт напрямую?)

Первая часть по сути то про факт: заявлений о поддержке нет, обращений в логах нет. Вторая уже поинтереснее. Мюллер сравнивает llms.txt с keywords не по бесполезности, а по устройству: это так сказать декларация владельца о содержимом собственного сайта. А сам сайт при этом доступен для прямой проверки.

Здесь суть - краулер может открыть страницы и посмотреть, что там. Зачем ему верить пересказу, когда есть оригинал.

Ровно по этой причине умер keywords. И ровно по этой причине не работает llms.txt. Вопрос не закрыт, споры идут. Но у нас нет ни одного кейса, где внедрение llms.txt или llms-full.txt дало измеримый результат — ни в цитируемости, ни в позициях, ни в лидах.

Настораживает сама конструкция: появляется новая среда, правил никто не знает, и тут же возникает артефакт, который якобы всё решает. Один файл в корне - и вы в ответах ИИ. В диджитале такой палочки не было ни разу.

✍️ Итак, что делаем вместо:

✔ контент, отвечающий на конкретные вопросы
✔ семантичный HTML
✔ корректная Schema.org
✔ живой sitemap
✔ работающие коды ответа
✔ вменяемая скорость
✔ регулярная проверка того, что боты видят на самом деле - по логам

Это двигает позиции, цитируемость и лиды одновременно. Проблема одна: этого нельзя достичь, положив в корень один файл.

Появятся кейсы с воспроизводимым эффектом - пересмотрим позицию и напишу об этом.

Всем лидов ❤️ 🚀
  • 🐳 14
  • 🔥 7
  • 👏 7
  • 🕊 6
  • 💯 5
  • ✍ 3
  • ⚡ 2
Post #2556 3.06K
Друзья, продолжаем рубрику #что_происходит, где я собираю интересные цифры, новости, исследования по рынку и делюсь мыслями, которые они у меня вызывают.

Моя любимая "тёмная сторона" формулирует разницу между хорошим продуктом и прорывным на примерах Shopify, Uber, Airbnb: прорывной не тот, что делает существующее быстрее, а тот, что делает недоступное раньше доступным условно 1000 людям вместо одного. И предлагает применить эту рамку к ИИ-продуктам.


Сейчас почти все ИИ-стартапы, которые я вижу, делают ровно то, от чего автор (надеюсь, что посты пишет все еще Морейнис) предостерегает: они берут существующий процесс и ускоряют его. Быстрее написать письмо, быстрее собрать отчёт, быстрее сделать креатив. Это полезно, это продаётся, но это не прорыв в смысле Shopify или Uber, потому что Shopify не ускорил открытие магазина для тех, кто и так умел его открывать, он сделал предпринимателем того, кто раньше им физически не мог стать.

Что мешает фаундерам думать в категориях новой аудитории, а не старого процесса? Подозреваю, что дело в измеримости. "Ускорили в 3 раза" считается легко, это понятная метрика для питча инвестору (или своему руководителю). "Сделали доступным для людей, которых раньше в рынке вообще не было" считать почти нечем, пока эти люди не появились и не заплатили.

Дальше это упирается прямо в меня и чем я занимаюсь. Если продукт создаёт аудиторию, которой раньше не было, как её вообще продвигать? У неё нет привычного языка запроса, она не ищет то, чего для неё не существовало, соответственно рекламу на такую аудиторию не настроишь стандартными методами, там нет истории поведения, на которую можно опереться. Это рынок, который классическая воронка видит как шум, или вовсе невиден.

И еще - Uber и Airbnb стали прорывом не из-за технологий, там не было великого изобретения, было снятие барьера "неудобно, дорого, страшно". Такси и раньше можно было вызвать, комнату и раньше можно было снять. Интересно, применимо ли это мышление к нашим нишевым рынкам, где барьер часто не технологический, а просто "я не знаю, к кому обратиться" или "мне страшно доверить это незнакомой компании". Может, прорыв там ищут не там, где нужно.

Пока без вывода. Смотрю, кто из ИИ-продуктов в следующем году сделает ставку на новую аудиторию и сбудется ли предсказания Маска, что скоро будет первая миллиардная компания, которая состоит из одного человека и тысяч ИИ-агентов.

Всем лидов ❤️
На этой неделе новый подкаст
  • 👍 12
  • 🕊 5
  • 💯 5
  • ✍ 4
  • 🤔 4
  • 👌 1
Post #2548 3.13K
💜 Как понравиться Алисе. Пару слов про ИИ-поиск

Почему один текст поддерживает топ-10 в поиске, но не появляется в ответах Алисы, тогда как другой - с более скромной позицией - раз за разом туда попадает?

Алиса не индексирует интернет самостоятельно. Она работает поверх поисковой выдачи: сначала поисковик формирует индекс, потом выдачу, потом ИИ выбирает из нее источники для генерации ответа.

Топ-10 - не гарантия того, что Алиса вас полюбит. Мы сравнили, как цитируются вопросные запросы ("как выбрать", "какой лучше", "сколько стоит") и обычные информационные - разница в 6,8 процентных пункта на масштабе 12 000+ запросов не в пользу вторых. Это сотни дополнительных цитирований.

Что еще важно: 92,5% всех ИИ-цитирований - статьи блога, и только 7,5% - карточки товаров с теми же позициями в топе. Карточка с ценой и артикулом может стоять даже на первом месте, Алисе там особо то нечего процитировать..

😎 Что ещё, кроме позиции, определяет цитирование:

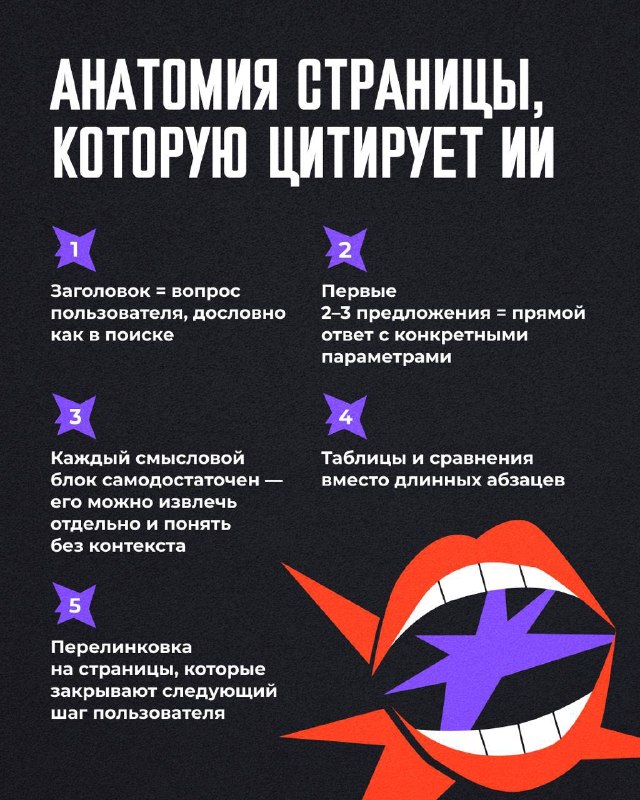
✔заголовок - это конкретный запрос пользователя, который совпадает с реальными поисковыми запросами
✔прямой ответ уже в первом-втором абзаце, без долгих подводок
✔каждый смысловой блок самодостаточен - его можно вырвать из контекста, и он всё равно будет понятен
✔материал перелинкован с каталогом, иначе это просто трафик без продолжения

У нас вот недавно - у одного из клиентов переехал на новые адреса, позиции просели, и упоминания в нейроответах повторили эту просадку день в день, просто с задержкой в пару недель на переиндексацию. Вернулись позиции - вернулись и цитирования.

И это скорее вопрос к логике контент-стратегии в целом: инфоблок в e-commerce - перехват человека на этапе, когда он ещё выбирает между инвертором и обычным мотором, не между вашим сайтом и сайтом конкурента. И этот перехват теперь работает сразу в двух каналах - органика и нейроответы.

🔗 Тут чуть подробнее.

Если позиции не растут и нейросети вас не цитируют - пишите мне

Всем лидов и чтобы Алиса рекомендовала вас ❤️
  • ⚡ 14
  • ❤‍🔥 9
  • 🔥 7
  • 🐳 6
  • 👏 5
  • 💯 5
  • 🤓 4
Post #2547 2.84K
Друзья, продолжаем рубрику - #что_происходит, где я собираю интересные новости, цифры и исследования по рынку, а еще записываю мысли, которые они у меня вызывают.

✔️ Автор делится промптом, который заставляет ИИ-агента не подтверждать план, а фальсифицировать его, искать риски и слепые зоны вместо доказательств того, что всё сделано правильно


Бесит же, что ИИ со всем соглашается? И тут ребята воспроизвели в агентах ровно это - условно спроси агента "подтверди, что план хороший" и он его подтвердит, спроси "найди, почему план провалится», и он найдёт. Я даже готовлю материал, где наш специалист по настройке Директа будет настраивать РК строго по совету ИИ и посмотрим что из этого выйдет))

Но вернемся к новости. В чем тут прикол: агента переучить проще и быстрее, чем человека. Человека, который годами защищает свои решения, так просто не переформулируешь в "а подумай, в чем ты неправ" - это стресс. Зато промпт можно поменять.. И вот вопрос: если ИИ настроить на самокритику по отношению к компании, кто-то ведь реально начнёт следовать тому, что он скажет в своей области. Или все будут писать промпты, которые молча подтверждают уже принятое решение? Подозреваю, что вторых будет больше.

Инструмент самоуспокоения продать себе проще, чем инструмент самокритики, даже если оба стоят одинаково. Мы просим подтвердить свое решение не в явном же виде (а когда даем задачу, нам уже кажется что задача решается наилучшим способом именно так). Осталось перекинуть на ИИ рутину, но как будто важнее кто-то (скилл) кто будет за нас делать шаг назад и рефлексировать. Сам путь-то верный? Или мы просто сжигаем на это время и токены?

Попробовали бы на своих текущих задачах спросить агента не "всё ли я учёл", или еще лучше "где я вру себе". Разница в ответе будет показательной. И для меня болезненной, скрывать не буду.

Всем лидов и хорошей недели❤️
  • 🕊 12
  • 🤔 9
  • 👏 7
  • ✍ 5
  • ❤‍🔥 4
  • 🔥 4
  • ⚡ 3
Post #2541 2.68K
💸 Экономят даже те, у кого деньги есть: что McKinsey узнали о покупателе 2026

В этот раз State of the Consumer 2026 дочитали до последней сноски, и не зря: там нашлось много практичного для рекламы.

📌 В новом отчёте McKinsey 4 заметных сдвига

✔️Выбор у молодой аудитории происходит в соцсетях. 34% Gen Z называют соцсети каналом, который сильнее всего повлиял на решение о покупке, у бумеров таких 16%. Ответами нейросетей поколение Z пользуется активнее старших, при этом доверяет им заметно меньше. Если решение созрело в ленте, конверсия потом запишется на поиск или маркетплейс, и отчёт по последнему клику этот вклад, скорее всего, недооценит.

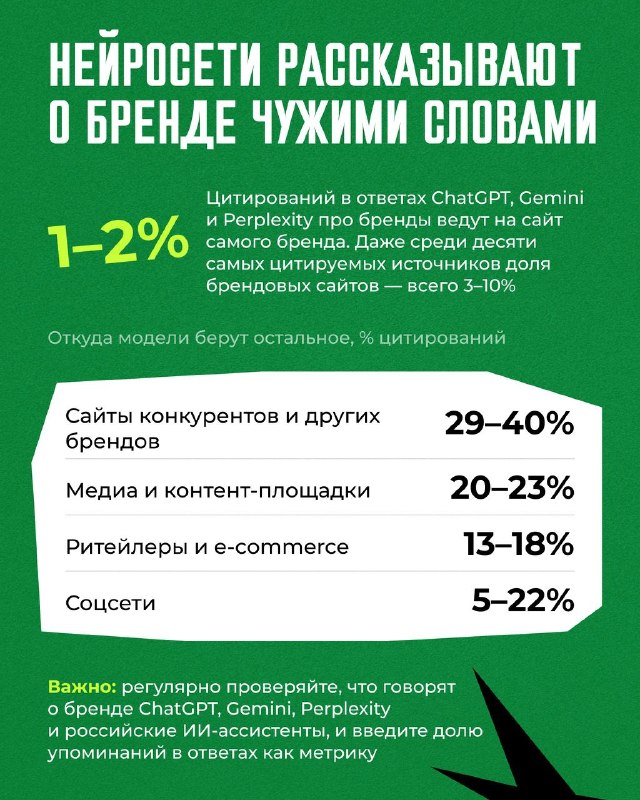
✔️Нейросети рассказывают о бренде чужими словами. На сайт самого бренда приходится 1-2% цитирований в ответах ChatGPT, Gemini и Perplexity. Остальное модели берут у конкурентов, медиа, ритейлеров и в соцсетях. Если цены и характеристики на разных площадках расходятся, модель реже включает бренд в ответ. McKinsey называет это «сигнальным диссонансом», и для GEO это, пожалуй, самый практичный вывод отчёта.

✔️Возраста и дохода для сегментации уже мало. 25% wellness-аудитории обеспечивают более 40% трат рынка. Услуги своими руками и бюджетные приложения чаще осваивают люди с высоким доходом, чем с низким. Получается, экономного покупателя по доходу не найти, и аудитории под офферы о выгоде точнее собирать по поведению.

✔Ценность шире цены.
82% респондентов дольше пользуются вещами перед заменой, 69% ремонтируют вместо того, чтобы выбросить. При этом рынок впечатлений за 2023-2025 годы вырос на 2,6%, необязательные товары на 0,8%. В рекламе появляются новые аргументы: долговечность, ремонтопригодность, цена перепродажи, эмоция от опыта.

✍️ Прежде чем вкладываться в новый контент под нейросети, проверьте, что они уже говорят о бренде. Составьте вопросы, которые покупатель задаёт перед покупкой, прогоните их через ChatGPT, Gemini, Perplexity или российские ИИ-ассистенты и выпишите, где бренда нет и где факты расходятся с реальностью.

Начните с цен, наличия и характеристик на маркетплейсах: их обычно проще выровнять, чем написать десяток новых статей. Повторяйте проверку раз в месяц, так будет видно, работают ли изменения.


Всем лидов ❤️
  • 👏 16
  • 🕊 7
  • 👍 5
  • 🤓 5
  • 🤔 4
  • 🐳 4
  • ⚡ 2
Older posts →

About this channel

How can I read @kineticaagency without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Тру.Маркетинг | Первухин: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Тру.Маркетинг | Первухин have?
Тру.Маркетинг | Первухин (@kineticaagency) has 7.42K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Тру.Маркетинг | Первухин know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →