TGViewer
Channel Public Channel
Библиотека джависта | Java, Spring, Maven, Hibernate

Библиотека джависта | Java, Spring, Maven, Hibernate

@javaproglib

Все самое полезное для Java-разработчика в одном канале.

Учиться у нас: clc.to/AATM8w

Для обратной связи: @proglibrary_feeedback_bot

По рекламе: @tproger_sales_bot

РКН: https://gosuslugi.ru/snet/67a5bbda1b17b35b6c1a55c4
Subscribers
22K
Photos
2.5K
Videos
57
Links
3.7K

Showing posts older than #7602 · Back to latest

Older Posts 20 shown
Post #7601 2.57K
☕️ Магия JVM Flags

Запустите своё приложение с -XX:+HeapDumpOnOutOfMemoryError, и когда (не «если») приложение упадёт с OOM, у вас будет дамп памяти.

🔹 Зачем это нужно

— При падении с OutOfMemoryError JVM автоматически сохраняет снапшот всей кучи в .hprof-файл.
— Без него вы знаете лишь факт смерти процесса. С ним — кто именно убил.
— Особенно ценно в контейнерах и CI/CD: процесс умер, лог ротировался, а дамп остался.
— Работает с любым анализатором: Eclipse MAT, IntelliJ Profiler, VisualVM, YourKit.

🔹 Как использовать

— Базовый запуск (дамп рядом с процессом):
java -XX:+HeapDumpOnOutOfMemoryError -jar app.jar

— Задать путь явно (обязательно в проде):
java -XX:+HeapDumpOnOutOfMemoryError \
-XX:HeapDumpPath=/var/dumps/app.hprof \
-jar app.jar

— В Docker нужно монтировать папку наружу, иначе дамп умрёт вместе с контейнером:
-v /host/dumps:/var/dumps

— Руками с живого процесса без рестарта:
jcmd <pid> GC.heap_dump /tmp/live.hprof


🔥 Пока разбираетесь в дебаге JVM — параллельно можно освоить ИИ-агентов. 4 места до 30 апреля.

══════ Навигация ══════
Вакансии • Задачи • Собесы

🐸 Библиотека джависта

#Enterprise
  • 👍 5
  • ❤ 3
  • 🔥 1
Post #7599 2.8K
💬 Обратная связь

Коллеги, предлагаю актуализировать базу годных ресурсов по Java помимо нашего канала.

✔️ Присылайте в комменты:

— Блоги и статьи
— Telegram-каналы
— YouTube-каналы и подкасты
— Репозитории
— Доклады

❌ Что НЕ ищем

Курсы "java с нуля за месяц", базовые туториалы и переводы официальной документации.

💬 Закидывайте в комменты ваши любимые источники. Для работы, для учёбы, для повседневного чтения.

🐸 Библиотека джависта

#DevLife
  • 🔥 6
  • 👍 1
  • 👏 1
  • 🤔 1
Post #7598 2.48K
🔥 База по ИИ-агентам от научного сотрудника Сколтеха и НИУ ВШЭ

Знакомьтесь, Екатерина Трофимова. Кандидат компьютерных наук, ресерчер в Центре ИИ Сколтеха и лаборатории LAMBDA. Она объединяет глубокую академическую экспертизу и практику: знает, как ИИ-системы устроены «под капотом» и как встроить их в реальные проекты (в т.ч. для Т-банка).

Мы попросили Екатерину собрать список мастхев материалов для тех, кто хочет проектировать агентов в проде. Сохраняйте список.

🛠 Стек и фреймворки:

DSPy — алгоритмическая оптимизация промптов (вместо ручного подбора слов).

Semantic Kernel и LangMem — инструменты для управления сессионной и долгосрочной памятью.

MCP (Model Context Protocol) — новый стандарт от Anthropic для подключения агентов к вашим БД и локальным файлам.

📖 Документация, которую нужно знать:

Anthropic Prompt Caching — как кэшировать контекст и радикально резать косты на API.

OpenAI Agents SDK / Cookbook — лучшие практики работы с памятью.

Augment — платформа для оптимизации работы ИИ-агентов и контроля токенов.

🔬 Хардкорные статьи и препринты (на выходные):

Lost in the Middle — почему LLM «слепнут» на длинных текстах и забывают середину контекста.

How Do Coding Agents Spend Your Money? — куда улетает бюджет при работе автономных кодинг-агентов.

MemGPT — архитектура операционной системы для LLM с иллюзией бесконечной памяти.

InjecAgent / AgentSentry — всё о безопасности и защите агентов от инъекций в промпты.

Екатерина Трофимова — один из ключевых экспертов нашего курса AgentOps. На своих лекциях она детально разбирает, как проектировать инструменты для агентов, как агент принимает решения о вызове инструментов и какие ограничения возникают в реальном проде

🎁 Акция в честь старта продаж!

Прямо сейчас при покупке Инженерного трека вы получаете полный доступ к материалам курса «Разработка ИИ-агентов» в подарок.

👉 Забрать 2 курса по цене 1 и начать обучение
  • ❤ 1
Post #7597 2.63K
🔧 @Async и ThreadLocal: ловушка, которую не видно в коде

При использовании @Async Spring создаёт новый поток из пула для выполнения метода. Если в основном потоке вы храните данные в ThreadLocal (например, контекст пользователя, tenant ID или trace-информацию) — в асинхронном методе они будут недоступны.

Классическая ловушка:
// Основной поток — кладём данные
UserContext.set(currentUser);

// Вызов @Async метода — данные уже не там
asyncService.processOrder(orderId);


🔹 Решение

▪️ Создать кастомный Executor с передачей контекста через TaskDecorator:
@Bean
public Executor asyncExecutor() {
ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor();
executor.setTaskDecorator(runnable -> {
User user = UserContext.get(); // захватываем из текущего потока
return () -> {
try {
UserContext.set(user); // передаём в новый поток
runnable.run();
} finally {
UserContext.clear(); // обязательно чистим
}
};
});
executor.setCorePoolSize(4);
executor.setMaxPoolSize(10);
executor.initialize();
return executor;
}


▪️ Использовать @Async("asyncExecutor") с явным указанием бина:
@Async("asyncExecutor")
public CompletableFuture<Void> processOrder(Long orderId) {
// UserContext.get() теперь вернёт правильного пользователя
}


Без finally { UserContext.clear() } — утечка контекста гарантирована: потоки из пула переиспользуются, и следующий запрос получит чужие данные.

══════ Навигация ══════
Вакансии • Задачи • Собесы

🐸 Библиотека джависта

#Enterprise
  • 👍 9
  • 🔥 2
  • 👏 1
Post #7594 2.57K
⚙️ Compressed OOPs

На 64-битной JVM каждая ссылка на объект — это 64-битный указатель. При большом количестве объектов это заметно увеличивает потребление памяти и снижает эффективность кеша: меньше ссылок помещается в cache line. Compressed OOPs (Ordinary Object Pointers) — механизм, который решает эту проблему, но с нетривиальными последствиями при масштабировании heap.

🔹 Механика


JVM выравнивает объекты по 8 байт. Значит, три младших бита любого указателя всегда равны нулю и их можно не хранить. Если сдвинуть 32-битное значение влево на 3 бита, получим 35 бит адресного пространства — 32GB. Именно поэтому compressed oops работают при heap до 32GB: 32-битная "сжатая" ссылка декодируется в реальный 64-битный адрес сдвигом.

реальный адрес = сжатая_ссылка << 3


При heap ≤ 4GB сдвиг не нужен — просто zero-based, ссылка используется напрямую как смещение от адреса 0.

🔹 Пороговые значения


До 4GB heap: нулевое смещение, нет сдвига. Самый быстрый вариант.
4GB — 32GB: сдвиг на 3 бита, смещение ненулевое.
Выше 32GB: compressed oops отключаются, все ссылки становятся 64-битными.

Здесь ловушка. Если поднять heap с 28GB до 33GB — потребление памяти может вырасти не на 5GB, а значительно больше. Все ссылки удваиваются в размере: с 4 до 8 байт. На приложении с десятками миллионов объектов это легко даёт +20-30% к реальному потреблению.

🔹 Как проверить что включено


java -XX:+PrintFlagsFinal -version | grep UseCompressedOops


Или в логах GC при старте с -Xlog:gc+heap=info:
Heap address: 0x00000006c0000000, size: 28672 MB, Compressed Oops mode: Non-zero based


"Zero based" — heap ≤ 4GB, оптимально.
"Non-zero based" — 4-32GB, compressed oops работают но со сдвигом.
Если строки нет и ссылки 8 байт — compressed oops выключены.

🔹 Compressed Class Pointers

Помимо ссылок на объекты, в заголовке каждого объекта есть ссылка на klass (метаданные класса). Она тоже сжимается отдельным механизмом — Compressed Class Pointers, отдельное 32-битное пространство (Metaspace). Управляется -XX:CompressedClassSpaceSize, по умолчанию 1GB.

🔹 Практический вывод

Граница в 32GB — критическая при планировании capacity. Стандартная рекомендация: если нужно чуть больше 32GB, рассмотреть heap в 26-30GB с compressed oops вместо 33GB без них. Реальная эффективная ёмкость может оказаться выше за счёт лучшей утилизации кеша процессора и меньшего давления на GC.

══════ Навигация ══════
Вакансии • Задачи • Собесы

🐸 Библиотека джависта

#CoreJava
  • ❤ 5
  • 👍 3
  • 🔥 1
Post #7593 2.24K
😮 Топ-вакансий для джавистов за неделю

Java-разработчик (GitFlic, гибрид) — от 200 000 ₽ — гибрид (Москва)

Java разработчик — 330 000 ₽ — гибрид/Удалёнка (Москве, Санкт-Петербург, Екатеринбург)

Senior Java Engineer (JavaSE, algorithms, optimization) — от 5 000 $ — удалёнка

➡️ Еще больше топовых вакансий — в нашем канале Java jobs
  • 👍 1
Post #7592 2.49K
🗓 В следующий вторник (28.04) в 19:00 встречаемся в онлайне.

Тема:
Как эффективно управлять контекстным окном LLM в мультиагентных системах и не сливать бюджет на токены


В кружке Кирилл рассказал, какие именно подходы будем разбирать.

👉 Занять место на вебинаре
Post #7589 2.62K
spring-cheatsheet.pdf97.7 KB
⌛ Сохраняйте шпаргалку по спрингу

Собрали шпаргалку по Spring для тех, кто только начинает.

Карта экосистемы, главные аннотации и стартеры, типичные ошибки новичков всего на двух страницах.

══════ Навигация ══════
Вакансии • Задачи • Собесы

🐸 Библиотека джависта

#Enterprise
  • 👍 8
  • ❤ 4
  • 🔥 3
Post #7588 2.32K
🗄 Как не «положить» базу данных?

В большинстве веб-приложений (например, Instagram или Twitter) соотношение чтения к записи составляет примерно 10 к 1. То есть люди в 10 раз чаще смотрят чужие посты, чем пишут свои. Эту особенность как раз можно использовать.

🔹 Репликация (Master-Slave / Leader-Follower)

Идея проста: давайте скопируем базу данных на несколько серверов и разделим обязанности.

— Master (Лидер): Это единственная база данных, в которую разрешено ПИСАТЬ (INSERT, UPDATE, DELETE).
— Slave (Ведомые/Реплики): Это точные копии Мастера. Из них можно ТОЛЬКО ЧИТАТЬ (SELECT).

Как это работает:

1. Пользователь публикует фото. Запрос идет на Master-базу.
2. Master сохраняет фото и мгновенно отправляет новые данные всем своим Slave-копиям (реплицирует).
3. 1000 других пользователей открывают ленту. Их запросы на чтение распределяются между тремя Slave-базами.

Итог: нагрузка на чтение размазана, Мастер спокойно занимается только записью.

🔹 Шардирование (Sharding / Горизонтальное партиционирование)

Репликация спасает, когда много читают. Но что делать, если пользователи слишком много пишут (например, это система сбора логов или мессенджер)? Мастер перестает справляться.

Приходит время рубить данные на части - Шардировать.

Мы берем нашу огромную таблицу Users и разбиваем её на несколько независимых баз данных (шардов).

— Шард 1: хранит пользователей с ID от 1 до 1,000,000.
— Шард 2: хранит пользователей с ID от 1,000,001 до 2,000,000.

Каждый шард - это отдельный сервер со своим процессором и диском.

Сложность:
теперь вашему приложению (или специальному роутеру) нужно понимать, в какую именно базу отправлять SQL-запрос. А сделать JOIN между таблицами, лежащими на разных серверах, становится практически невозможно.

🔹 Теорема CAP (закон распределенных систем)

Как только ваша база данных перестает жить на одном сервере и разъезжается на несколько (реплики или шарды), вступает в силу закон - теорема CAP.

Она гласит, что в распределенной системе вы можете выбрать только ДВА из ТРЕХ свойств:

1. C (Consistency / Консистентность): все клиенты видят одни и те же данные в один и тот же момент времени. Если я обновил аватарку на Мастере, следующий же запрос к любому Слейву должен вернуть новую аватарку.

2. A (Availability / Доступность): система всегда отвечает на запрос, даже если часть серверов сгорела.

3. P (Partition Tolerance / Устойчивость к разделению): система продолжает работать, даже если между серверами БД пропала сеть (они перестали видеть друг друга).

Суровая реальность: в интернете сеть пропадает всегда. Поэтому свойство P мы обязаны брать по умолчанию. Остается выбор между CP и AP.

🔵 Системы CP (Консистентные): банковские приложения. Если сеть между Мастером и Репликой упала, база откажется отдавать вам баланс, потому что боится отдать устаревшие данные. Лучше выдать ошибку, чем соврать.

🔵 Системы AP (Доступные): соцсети (Instagram, YouTube). Если вы поставили лайк, а сеть внутри дата-центра моргнула, ваш друг может еще пару минут не видеть этот лайк (данные не консистентны). Но сайт при этом не "лежит", лента листается.

══════ Навигация ══════
Вакансии • Задачи • Собесы

🐸 Библиотека джависта

#Enterprise
  • 👍 16
  • ❤ 3
  • 🔥 2
Post #7587 2.15K
🔧 Hibernate Batch Processing

@BatchSize и hibernate.jdbc.batch_size — две разные вещи, которые иногда путают. Разбираем обе.

🔹 Решение

▪️ JDBC batch insert/update

spring:
jpa:
properties:
hibernate:
jdbc:
batch_size: 50 # отправлять INSERT пачками по 50
order_inserts: true # группировать INSERT по типу сущности
order_updates: true # то же для UPDATE
cache:
use_second_level_cache: false


Без order_inserts: true батчинг часто не работает. Hibernate вперемешку отправляет INSERT для разных таблиц, JDBC driver не может их объединить.

@Transactional
public void saveAll(List<Order> orders) {
for (int i = 0; i < orders.size(); i++) {
entityManager.persist(orders.get(i));
if (i % 50 == 0) {
entityManager.flush();
entityManager.clear(); // освобождаем first-level cache
}
}
}


Без flush/clear каждые N записей first-level cache растёт до OOM при больших объёмах.

▪️ @BatchSize для загрузки коллекций

@Entity
public class Author {

@OneToMany(mappedBy = "author", fetch = FetchType.LAZY)
@BatchSize(size = 25)
private List<Book> books;
}


При загрузке 100 авторов и обращении к books — вместо 100 SELECT будет 4 (100/25). Hibernate собирает ID авторов в пачки и загружает WHERE author_id IN (?, ?, ..., ?).

Это не решение N+1, это смягчение его последствий. Правильное решение — JOIN FETCH или EntityGraph для конкретного запроса. @BatchSize — запасной вариант для случаев когда JOIN FETCH неприменим.

▪️ @BatchSize на уровне класса

@Entity
@BatchSize(size = 25)
public class Book { ... }


Работает для загрузки по ID: entityManager.find(Book.class, id) будет батчиться. Полезно при большом количестве lazy-загружаемых ссылок типа @ManyToOne.

▪️ Проверка что батчинг реально работает

spring:
jpa:
show-sql: true
datasource:
url: jdbc:postgresql://...?reWriteBatchedInserts=true # для PostgreSQL


Для PostgreSQL нужен флаг reWriteBatchedInserts=true в URL — иначе JDBC драйвер отправляет запросы по одному даже при включённом батчинге Hibernate.

⚠️ Сущности с @GeneratedValue(strategy = IDENTITY) (auto-increment) не батчируются при INSERT — Hibernate вынужден получать ID после каждой вставки. Для батчинга используйте SEQUENCE стратегию с allocationSize равным batch_size.

══════ Навигация ══════
Вакансии • Задачи • Собесы

🐸 Библиотека джависта

#Enterprise
  • 🔥 10
  • 👍 5
  • ⚡ 1
Post #7586 2.21K
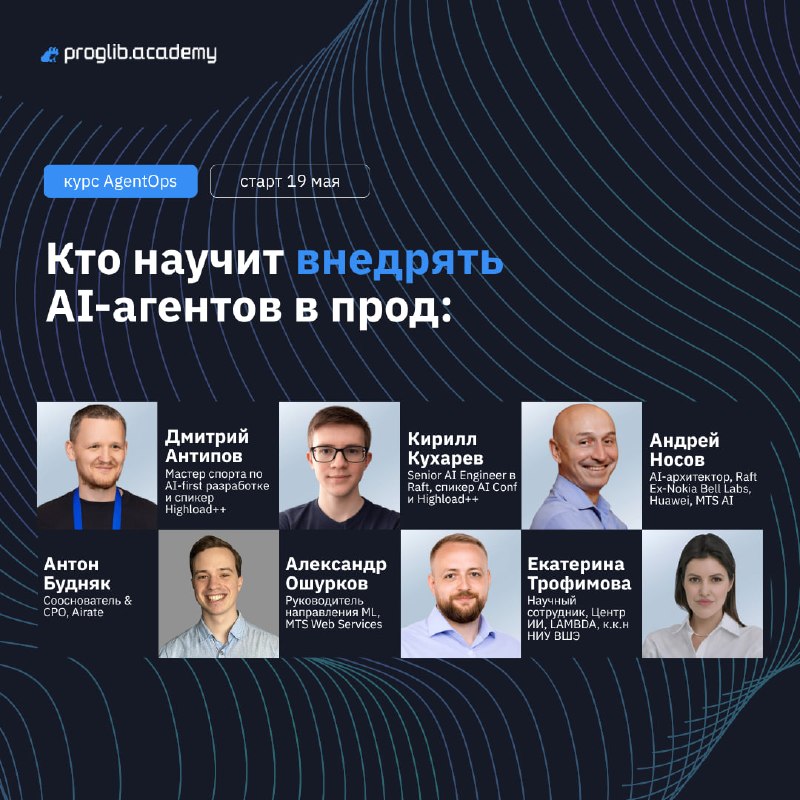
⚡️ Мы рады представить команду экспертов курса AgentOps!

— Дмитрий Антипов расскажет, как грамотно проверить работу AI-моделей
— Курилл Кухарев поделится, почему компаниям выгодно использовать локальные модели и как их развернуть
— Андрей Носов расскажет, как работать с данными и знаниями в AI-системах: построение RAG, выбор подходов к поиску и организация хранения данных
— Антон Будняк разберет, как обеспечить устойчивость сервиса, в котором используется ИИ
— Александр Ошурков расскажет, как оценивать качество работы LLM в backend-сервисах
— Екатерина Трофимов разберет, как проектировать инструменты для AI-агентов и выстраивать взаимодействие с внешними сервисами

Курс для backend-разработчиков, тимлидов и LLM инженеров о том, как внедрять AI-логику в бэкенд IT-продуктов и сохранять стабильность сервиса.

К концу обучения вы получите:

• Структурированный подход к архитектуре и деплою AI-агентов
• Навыки настройки мониторинга, тестирования и контроля расходов на токены
• Разбор сложных инженерных кейсов из реальной практики

🎁 Доступ к материалам курса
«Разработка ИИ-агентов» в подарок при покупке Инженерного трека

👉 Все подробности и программа обучения.
  • 👍 1
Post #7584 2.48K
☕️ Магия JVM Flags

Запустите своё приложение с -XX:+PrintFlagsFinal, и вы увидите все настройки JVM.

🔹 Зачем это нужно

— Показывает финальные значения всех JVM-флагов после применения эргономики, дефолтов и ваших переопределений.
— Полезно для Java-сервисов в контейнерах: вы думаете, что выставили -Xmx512m, а JVM видит 4GB хоста и живёт своей жизнью.
— Мгновенно отвечает на вопрос «а почему heap такой большой?».
— Работает на любом JDK без агентов, плагинов и прав суперпользователя.

🔹 Как использовать

— Дамп всех флагов при старте:
java -XX:+PrintFlagsFinal -version

— Только интересующее фильтруем через grep:
java -XX:+PrintFlagsFinal -version 2>&1 | grep -i heapsize

— Посмотреть, какой GC выбрала эргономика:
java -XX:+PrintFlagsFinal -version 2>&1 | grep -i "use.*gc"

— На живом процессе без рестарта:
jcmd <pid> VM.flags


jcmd <pid> VM.flags — особенно удобен в проде: не надо убивать процесс, видите текущее состояние прямо сейчас.

⚠️ Флаги делятся на три типа в выводе: product — обычный флаг, manageable — можно менять на лету через jcmd, diagnostic — требует -XX:+UnlockDiagnosticVMOptions. Если видите флаг, который хотите поменять, сначала смотрите его тип — сэкономит кучу времени на отладке.

══════ Навигация ══════
Вакансии • Задачи • Собесы

🐸 Библиотека джависта

#Enterprise
  • 👍 9
  • ❤ 7
  • 🔥 1
Post #7583 2.36K
🏃‍♀️ Уже завтра стартует курс по разработке AI-агентов.

Про AI-агентов часто думают, что это просто модная обертка над джпт для пет-проектов. Кажется, прикрутил API к скрипту и типа готово. А вот и нет! Когда дело доходит до прода, начинаются настоящие проблемы.

Зачем глубоко копать мультиагентные системы, если можно обойтись старым добрым кодом? Как контролировать расходы на токены, чтобы новая фича не разорила бизнес? Как заставить агента работать стабильно и предсказуемо, а не галлюцинировать?


Эту инженерную часть мы и будем разбирать на курсе. Будем учиться интегрировать внешние API, работать с RAG, LangGraph, CrewAI и деплоить всё это так, чтобы работало как часы.

Стартуем завтра. Для участия и доступа к программе переходите по ссылке.
Post #7582 2.21K
💬 Обратная связь

Какая рубрика нравится больше? Если забыли, о чём рубрика, можно освежить в памяти тут.

🔥 → #CoreJava
👍🏼 → #Enterprise
👾 → #DevLife
🤔 → #News
❤️ → Всё нравится :))

🐸 Библиотека джависта

#DevLife
  • ❤ 23
  • 🔥 10
  • 👍 8
  • 🤔 1
  • 👾 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →