Kubernetes, ведущая платформа для оркестровки контейнеров, обладает обширной экосистемой инструментов и компонентов, которые в совокупности позволяют организациям эффективно развертывать, управлять и масштабировать контейнерные приложения.
Специалисты по Kubernetes должны хорошо разбираться в этих инструментах, чтобы обеспечить надежность, безопасность и производительность контейнерных приложений в кластерах Kubernetes.
Чтобы представить целостную картину экосистемы Kubernetes, мы создали иллюстрацию, охватывающую следующие аспекты:
1. Безопасность 2. Сетевое взаимодействие 3. Время выполнения контейнера 4. Управление кластерами 5. Мониторинг и наблюдаемость 6. Оркестровка инфраструктуры
Хранение паролей в базе данных открытым текстом - не самая лучшая идея.
Любой человек, имеющий внутренний доступ к базе данных, может их увидеть и получить.
Кроме того, хэширование паролей и хранение хэш-значений недостаточно, поскольку они могут быть взломаны.
Стандартным решением для защиты от таких атак является использование соли.
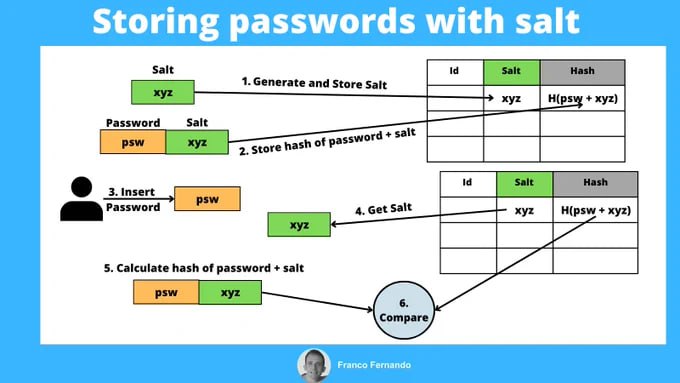
Соль - это случайно сгенерированная уникальная строка, которая добавляется к каждому паролю в процессе хэширования. Выше приведен процесс хранения и проверки пароля с использованием соли:
1. Соль хранится в базе данных в виде обычного текста, что обеспечивает уникальность результата хэширования для каждого пароля.
2. Пароли хранятся в базе данных, хэшируются с помощью соли.
3. Клиент вводит свой пароль.
4. Система считывает соль из базы данных
5. Система комбинирует соль с паролем и хэширует его
6. Система сравнивает вычисленные значения хэша с теми, что хранятся в базе данных. Если они равны, то пароль действителен.
На схеме показано, как происходит компиляция и выполнение.
Компилируемые языки компилируются в машинный код компилятором. В дальнейшем машинный код может быть исполнен непосредственно процессором. Примеры: C, C++, Go.
В байткодовых языках, таких как Java, сначала компилируется исходный код в байткод, а затем JVM выполняет программу. Иногда компилятор JIT (Just-In-Time) компилирует исходный код в машинный код, чтобы ускорить его выполнение. Примеры: Java, C#
Интерпретируемые языки не компилируются. Они интерпретируются интерпретатором во время выполнения программы. Примеры: Python, Javascript, Ruby.
Компилируемые языки в целом работают быстрее интерпретируемых.
Верите ли вы, что Google, Meta, Uber, Twitter и Airbnb размещают почти весь свой код в одном репозитории?
Такая практика называется монорепо.
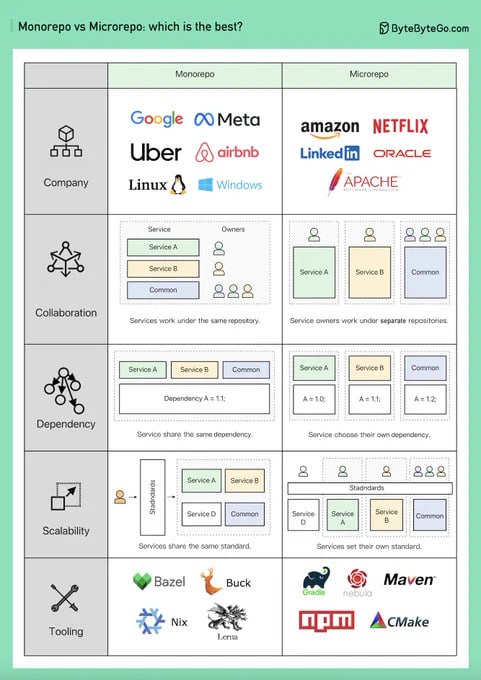
Монорепо против микрорепо. Что лучше? Почему разные компании выбирают разные варианты?
Монорепо - не новинка; и Linux, и Windows были созданы с использованием монорепо. Для повышения масштабируемости и скорости сборки компания Google разработала свой внутренний специализированный инструментарий для более быстрого масштабирования и строгие стандарты качества кодирования для обеспечения единообразия.
Amazon и Netflix являются основными распространителями философии микросервисов. Такой подход естественным образом разделяет код сервисов на отдельные репозитории. Он быстрее масштабируется, но впоследствии может привести к возникновению болевых точек в управлении.
В Monorepo каждый сервис - это папка, а каждая папка имеет конфигурацию BUILD и контроль прав OWNERS. Каждый член службы отвечает за свою папку.
С другой стороны, в Microrepo каждый сервис отвечает за свой репозиторий, при этом конфигурация сборки и права доступа обычно устанавливаются для всего репозитория.
В Monorepo зависимости являются общими для всей кодовой базы, независимо от ее назначения, поэтому при обновлении версии каждая кодовая база обновляет свою версию.
В Microrepo зависимости контролируются внутри каждого репозитория. Предприятия сами выбирают, когда им обновлять свои версии, исходя из собственного расписания.
Microrepo может либо установить свой собственный стандарт, либо принять общий стандарт, включив в него лучшие практики.
Инженеры Google создали Bazel, а Meta - Buck. Существуют и другие инструменты с открытым исходным кодом, в том числе Nix, Lerna и другие.
С годами у Microrepo появилось больше поддерживаемых инструментов, в том числе Maven и Gradle для Java, NPM для NodeJS, CMake для C/C++ и другие.
Как разработать безопасный доступ к веб-интерфейсу API для вашего сайта?
Когда мы открываем доступ к веб-интерфейсу API для пользователей, нам необходимо убедиться в том, что каждый вызов API аутентифицирован. Это означает, что пользователь должен быть тем, за кого он себя выдает.
В этой статье мы рассмотрим два распространенных способа:
1. Аутентификация на основе токенов
2. Аутентификация на основе HMAC (Hash-based Message Authentication Code).
На приведенной ниже схеме показано, как они работают.
Аутентификация на основе токенов Шаг 1 - пользователь вводит свой пароль на клиенте, а тот отправляет его на сервер аутентификации.
Шаг 2 - сервер аутентификации проверяет подлинность учетных данных и генерирует маркер со сроком действия.
Шаги 3 и 4 - теперь клиент может отправлять запросы на доступ к ресурсам сервера с маркером в HTTP-заголовке. Такой доступ будет действителен до истечения срока действия маркера.
На основе HMAC Этот механизм генерирует код аутентификации сообщения (подпись) с помощью хэш-функции (SHA256 или MD5).
Шаги 1 и 2 - сервер генерирует два ключа, один из которых - Public APP ID (открытый ключ), а другой - API Key (закрытый ключ).
Шаг 3 - теперь мы генерируем HMAC-подпись на стороне клиента (hmac A). Эта подпись формируется с помощью набора атрибутов, перечисленных на схеме.
Шаг 4 - клиент отправляет запросы на доступ к ресурсам сервера с hmac A в HTTP-заголовке.
Шаг 5. Сервер получает запрос, содержащий данные запроса и заголовок аутентификации. Он извлекает из запроса необходимые атрибуты и использует ключ API, хранящийся на стороне сервера, для генерации подписи (hmac B).
Шаги 6 и 7 - сервер сравнивает hmac A (сгенерированный на стороне клиента) и hmac B (сгенерированный на стороне сервера). Если они совпадают, то запрашиваемый ресурс возвращается клиенту.
 ШП