Post #223
660
Channel Public Channel
 ИТ
ИТ-архитектура
@itarchitecture
Полезные ссылки и материалы по архитектуре предприятия, решений, данных, системной архитектуре, system design, archops. Администратор канала @itarchitect_kz https://www.linkedin.com/in/itarchitectkz www: https://itarchitect.kz
- Subscribers
- 558
- Photos
- 69
- Videos
- 10
- Links
- 208
Showing posts older than #224 · Back to latest
Older Posts 20 shown
Post #222
540

#пятничное
Сдача в промку
- Мы начали с прототипа
- И?!?!
- И улучшили его!
😅
Сдача в промку
- Мы начали с прототипа
- И?!?!
- И улучшили его!
😅
- 😁 7
- 👏 2
Post #221
464

Действительно ли “облако” позволяет экономить?
Чтобы увидеть, что на самом деле приносит нам облако, давайте посмотрим на этот вопрос в перспективе долгосрочного использования.
🔹 Когда создается компания или запускается новое бизнес-направление, соответствие продуктовому рынку (product-market fit) является ключевым. Облако позволяет быстро настроить систему с минимальным необходимым оборудованием. Стоимость также прозрачна.
Например, если мы запускаем базы данных локально, нам нужно позаботиться о настройке оборудования, установке операционной системы, обслуживании СУБД и т. д. Но если мы используем Amazon RDS (Relational Database Service), нам просто нужно позаботиться об оптимизации приложений. Это избавляет нас от проблем с наймом администраторов операционных систем и администраторов баз данных.
Позже, если бизнес-модель не сработает, мы можем просто прекратить использование услуг, чтобы сэкономить деньги, не думая о том, что делать с оборудованием.
🔹 В исследованиях, проведенных Кэмероном Фишером, использование облака начинается почти с нулевой стоимости. Со временем стоимость начинает накапливаться на подписках и консультациях по развертыванию. По иронии судьбы, поскольку так легко распределять услуги в облаке по соображениям масштабируемости или надежности, организация, как правило, злоупотребляет облаком после внедрения. Потому так важно использовать систему мониторинга прозрачности затрат.
Источники:
1. Alex Xu
2. AWS guide: Choosing between Amazon EC2 and Amazon RDS
3. Cloud versus On-Premise Computing by Cameron Fisher, MIT
https://t.me/itarchitecture
- 👍 4
Post #220
383

Post #219
506
Если вы когда-нибудь задумывались, в чем разница между OAuth, OIDC и SAML
Чтобы прояснить разницу, нам нужно сначала определиться, что такое аутентификация и авторизация. Аутентификация - это процесс проверки личности пользователя или устройства, в то время как авторизация - это процесс определения того, что пользователю или устройству разрешено делать после установления его личности.
Кратко:
OAuth предназначен для предоставления доступа к чужим ресурсам.
OIDC предназначен для проверки того, кто вы, и предоставления доступа к чужим ресурсам.
SAML предназначен для получения доступа к различным ресурсам из разных мест с помощью одной карты.
Развернуто:
- OAuth (Open Authorization)
OAuth (2.0) - это открытый стандарт для предоставления и реализации авторизации. Он обеспечивает безопасный делегированный доступ. Это означает, что приложение может выступать в качестве пользователя и получать доступ к endpoints (конечным точкам) или предпринимать действия на серверах в качестве этого пользователя, но не требуя от пользователя входа в систему или обмена своими учетными данными. Этот доступ является временным и используется, например, для доступа к списку контактов пользователей в Facebook.
- OIDC (OpenID Connect)
OpenID Connect - это решение с открытым стандартом / открытым исходным кодом для обеспечения и реализации процесса аутентификации. Большинство крупных технологических компаний, таких как Google, Microsoft или GitHub, поддерживают этот стандарт. Это позволяет пользователям выбирать стороннего поставщика OpenID, которого они хотят использовать для входа на любой веб-сайт, который принимает стандарт OpenID. Если вы ранее использовали свой аккаунт Google для входа в Spotify или любую другую платформу, вы видели OIDC в действии. OpenID полезен для разработчиков приложений и веб-сайтов, которые хотят аутентифицировать пользователей, но не хотят рисковать хранением записей пользователей самостоятельно из-за аспектов безопасности. Вы можете рассматривать его как SSO для пользовательских приложений.
- SAML (Security Assertion Markup Language)
SAML является открытым стандартом аутентификации и авторизации и используется в основном на предприятиях. Это фреймворк для единого входа (SSO), что означает, что если вы успешно вошли в приложение своей организации, вы также можете получить доступ к другим приложениям без необходимости повторного внесения своих учетных данных. SAML использует XML для обмена сообщениями аутентификации и авторизации между конкретными identity providers (поставщиками идентификации) для проверки личности пользователя и разрешений. Его можно рассматривать как SSO для корпоративных приложений.
Заключение:
- OAuth позволяет стороннему приложению получать доступ к ресурсам пользователя с его разрешения и без учетных данных.
- OIDC добавляет уровень аутентификации в OAuth, позволяя приложению проверять личность пользователя и получать основную информацию о профиле.
- SAML используется для единого входа на предприятие, позволяя пользователям проходить аутентификацию с помощью своих корпоративных учетных данных и получать доступ к корпоративным ресурсам.
https://t.me/itarchitecture
- 👏 4
- 👍 2
Post #218
359

Cценарий, при котором вредоносный посредник перехватывает пакеты
- 👍 1
Post #217
331
Надежен ли HTTPS?
Если HTTPS безопасен, как такие инструменты, как Fiddler, могут перехватывать сетевые пакеты, отправленные через HTTPS?
* Fiddler помогает отлаживать веб-приложения, захватывая сетевой трафик между Интернетом и тестовыми компьютерами. Инструмент позволяет проверять входящие и исходящие данные для мониторинга и изменения запросов и ответов до того, как браузер их получит.
На приведенной ниже диаграмме показан сценарий, при котором вредоносный посредник перехватывает пакеты.
Предварительное условие: корневой сертификат промежуточного сервера присутствует в хранилище доверия (trust store).
Шаг 1 - Клиент запрашивает установление TCP-соединения с сервером. Запрос злонамеренно направляется на промежуточный сервер, а не на реальный сервер. Затем устанавливается TCP-соединение между клиентом и промежуточным сервером.
Шаг 2 - Промежуточный сервер устанавливает TCP-соединение с фактическим сервером.
Шаг 3 - Промежуточный сервер отправляет SSL-сертификат клиенту. Сертификат содержит открытый ключ, имя хоста, даты истечения срока действия и т. д. Клиент проверяет сертификат.
Шаг 4 - Фактический сервер отправляет свой сертификат промежуточному серверу. Промежуточный сервер проверяет сертификат.
Шаг 5 - Клиент генерирует ключ сессии и шифрует его с помощью открытого ключа с промежуточного сервера. Промежуточный сервер получает зашифрованный ключ сессии и расшифровывает его с помощью закрытого ключа.
Шаг 6 - Промежуточный сервер шифрует ключ сессии с помощью открытого ключа с фактического сервера и затем отправляет этот ключ на фактический сервер. Фактический сервер расшифровывает ключ сессии с помощью закрытого ключа.
Шаги 7 и 8 - Теперь клиент и сервер могут взаимодействовать с помощью ключа сессии (симметричное шифрование). Зашифрованные данные передаются по безопасному двунаправленному каналу. Промежуточный сервер всегда может расшифровать данные.
Теперь давайте ответим на вопросы, с которых мы начали:
1. HTTPS надежен, но клиент не должен принимать вредоносный сертификат с ненадежного стороннего сервера.
2. Fiddler может расшифровать данные, потому что его сертификат принят и браузер доверяет ему.
Вопрос к вам:
Почему HTTPS использует симметричное шифрование для передачи данных? Это безопасно?
Ответ:
Симметричное шифрование может быть таким же безопасным, как и асимметричное. Самой слабой частью симметричного шифрования является обмен ключами, который хорошо защищен в HTTPS с асимметричным шифрованием. Симметричное шифрование означает, что вы используете один и тот же ключ для шифрования и расшифровки. Таким образом, оно еще и быстрое.
https://t.me/itarchitecture
- 👍 1
Post #216
327
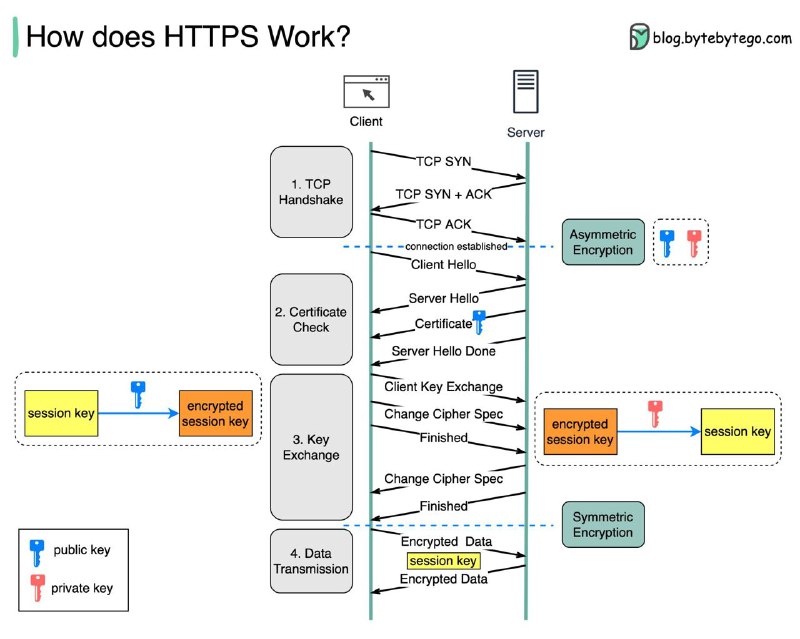
Как работает HTTPS?
Hypertext Transfer Protocol Secure (HTTPS) - это расширение протокола передачи гипертекста (HTTP). HTTPS передает зашифрованные данные с помощью Transport Layer Security (TLS). Если данные украдены онлайн, все, что получает перехватчик - это двоичный код.
Как данные шифруются и расшифровываются?
Шаг 1 - Клиент (браузер) и сервер устанавливают TCP-соединение.
Шаг 2 - Клиент отправляет "клиентское приветствие” на сервер. Сообщение содержит набор необходимых алгоритмов шифрования (пакеты шифров) и последнюю поддерживаемую версию TLS. Сервер отвечает "серверным приветствием", поэтому клиент знает, может ли сервер поддерживать алгоритмы и версию TLS.
Затем сервер отправляет SSL-сертификат клиенту. Сертификат содержит открытый ключ, имя хоста, даты истечения срока действия и т. д. Клиент проверяет сертификат.
Шаг 3 - После проверки SSL-сертификата клиент генерирует ключ сессии и шифрует его с помощью открытого ключа. Сервер получает зашифрованный ключ сессии и расшифровывает его с помощью закрытого ключа.
Шаг 4 - Теперь, когда и клиент, и сервер имеют один и тот же ключ сессии (симметричное шифрование), зашифрованные данные передаются по безопасному двунаправленному каналу.
Почему HTTPS переключается на симметричное шифрование во время передачи данных?
На это есть две основные причины:
1. Безопасность: асимметричное шифрование идет только в одну сторону. Это означает, что если сервер попытается отправить зашифрованные данные обратно клиенту, любой может расшифровать данные с помощью открытого ключа.
2. Ресурсы сервера: асимметричное шифрование добавляет довольно много математических накладных расходов. Оно не подходит для передачи данных в длительных сеансах.
https://t.me/itarchitecture
- 🔥 4
Post #215
319
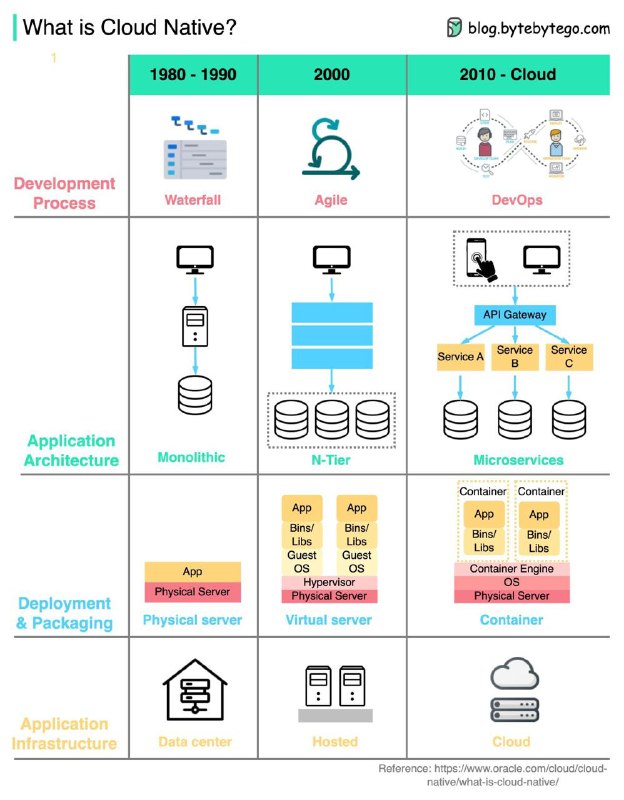
Что такое cloud native ("ориентированный на облако")?
#перевод_для_канала_itarchitecture
Выше приведена диаграмма, показывающая эволюцию архитектуры и процессов с 1980-х годов.
Организации могут создавать и запускать масштабируемые приложения в публичных, частных и гибридных облаках с использованием облачных технологий.
Cloud native означает, что приложения предназначены для использования облачных функций, поэтому они устойчивы к нагрузке и легко масштабируются.
Cloud native включает в себя 4 аспекта:
🔹 1. Процесс разработки:
Получил развитие от водопада, гибких методологий до DevOps.
🔹 2. Архитектура приложений:
Архитектура развилась от монолитов до микросервисов. Каждый сервис разрабатывается так, чтобы быть небольшим, адаптивным к ограниченным ресурсам в облачных контейнерах.
🔹 3. Развертывание и упаковка:
Раньше приложения развертывались на физических серверах. Затем в 2000-х гг. приложения, которые не были чувствительны к задержке, обычно развертывались на виртуальных серверах. В облачных приложениях они упакованы в образы docker и развернуты в контейнерах.
🔹 4. Инфраструктура приложений:
Приложения массово развертываются в облачной инфраструктуре, а не на автономных серверах.
https://t.me/itarchitecture
- 👍 2
Post #214
306
Годная статья с практическими примерами применения нотации Archimate в проектировании архитектуры программных продуктов
#archimate
https://www.hostco.ru/news/ispolzovanie-archimate-v-razrabotke-novogo-programmnogo-produkta/
ГК ХОСТ Использование ArchiMate в разработке нового программного продукта Наш коллега Александр Тетеркин, системный архитектор отела Сервиса и Консалтинга подготовил статью #archimate
https://www.hostco.ru/news/ispolzovanie-archimate-v-razrabotke-novogo-programmnogo-produkta/
- 👍 3
Post #213
297

Краткое сравнение SOAP, REST, GraphQL и RPC
#перевод_для_канала_itarchitecture
Со временем выпускаются различные архитектурные стили API.
У каждого из них есть свои шаблоны.
При этом на выбор стиля API обычно влияет:
- среда разработки
- используемый язык программирования
- человеческие и финансовые ресурсы.
Знание этих факторов помогает выбрать наиболее подходящий дизайн API для проекта.
В приведенной таблице представлено краткое сравнение.
- 👍 5
- 🔥 1
Post #212
305
Количество переездов в облака увеличилось вдвое. Как банки оказываются в облаках, как они там защищаются от шумных соседей и любителей украсть жесткий диск из гермозоны?
Когда же еще найти время узнать что-то новое архитектору? Конечно же послушать очередной интересный #podcast
https://pca.st/episode/d6259fc9-2532-42cb-a140-d24399113187
Pocket Casts Банки в облаках - Эпизод #24 - Сушите вёсла Астрологи объявили год отказоустойчивости. Количество переездов в облака увеличилось вдвое 🥳 В очередной новогодний выпуск мы в очередной раз позвали очередного архитектора - Максима Чернухина, и поговорили с ним про то как банки оказываются в облаках, как… Когда же еще найти время узнать что-то новое архитектору? Конечно же послушать очередной интересный #podcast
https://pca.st/episode/d6259fc9-2532-42cb-a140-d24399113187
- 👍 3
Post #211
593
ИТ-архитектура Оплата через сканирование QR-кода очень распространена, но знаете ли вы, что есть несколько видов такой оплаты? #перевод_для_канала_itarchitecture Есть 4 способа, независимо от того, используете ли вы PayPal, Stripe, Paytm, WeChat или Alipay. Чтобы разобрать…

- 👍 4
Post #210
568
Оплата через сканирование QR-кода очень распространена, но знаете ли вы, что есть несколько видов такой оплаты?
#перевод_для_канала_itarchitecture
Есть 4 способа, независимо от того, используете ли вы PayPal, Stripe, Paytm, WeChat или Alipay. Чтобы разобрать это, мы ответим на вопросы.
Первый вопрос заключается в том, кто предъявляет QR-код:
1. Вы можете предъявить QR-код, и продавец отсканирует код для оплаты. Это называется режимом, представленным потребителем, и продавец напрямую дебетует ваш счет.
2. Очевидно, что другой способ заключается в том, что продавец предъявляет QR-код для сканирования, чтобы оплатить причитающуюся сумму. Это называется "режимом, представленным торговцем", и вы предоставляете прямой кредит со своего счета.
Второй вопрос заключается в том, является ли QR-код динамическим или статическим:
1. Динамический QR-код означает, что QR-код будет генерироваться при его предъявлении, или он будет автоматически регенерироваться каждые несколько секунд. Поскольку он генерируется динамически, он может содержать детальную информацию, такую как причитающаяся сумма, тип транзакции и т. д.
2. Статический QR-код генерируется один раз и используется везде. Обычно он содержит только информацию об учетной записи.
Таким образом, есть 2 * 2 = 4 способа сканирования QR-кода:
1. Потребительский режим + статический QR-код
2. Потребительский режим + динамический QR-код
3. Режим, представленный продавцом + статический QR-код
4. Режим, представленный продавцом + динамический QR-код
👉 Вопросы к вам:
1. Один из указанных сценариев сканирования сопровождается красным символом - указано наличие высокого риска. Почему?
Ответ:
Статический QR, представленный потребителем, является наименее предпочтительным способом, поскольку он имеет высокий риск прослушивания и множества списаний у пользователя за одну операцию.
Идеальным случаем для методов статического QR являются случаи, когда предъявитель кода получает кредит (например, баллы, кэшбэк и т. д.). Для платежных процедур динамические QR-коды более безопасны.
2. Что лучше: динамический QR-код, представленный продавцом, или динамический QR-код, представленный потребителем?
Ответ:
QR, представленный продавцом, более удобен для обеих сторон, так как у торгового аппарата уже есть детали квитанции с ценами на все товары и общей стоимостью, налогом и т. д. Поэтому продавец создает код ссылки для операции, закодированный в форме QR, представляет его покупателю для сканирования, покупатель получает и проверяет данные до того, как он заплатит, чтобы избежать ошибок.
В противном случае потребитель должен установить детали платежа (по крайней мере, общую цену + имя продавца) вручную на своем телефоне, а затем самостоятельно создать код платежа, что требует больше времени.
- 👍 4
Post #209
284
Дорогие друзья, с наступающим Новым годом!
Сейчас у канала всего 200 подписчиков, но это очень качественная аудитория!
Более 100 человек знаю лично.
Спасибо за подписку и желаю всем нам профессионального роста и гармонии в 2023 году!
Сейчас у канала всего 200 подписчиков, но это очень качественная аудитория!
Более 100 человек знаю лично.
Спасибо за подписку и желаю всем нам профессионального роста и гармонии в 2023 году!
- 🔥 14
Post #208
324
Как строятся распределенные системы такого масштаба как Ozon, как тестируется готовность к нагрузкам и как прогнозируются узкие места, почему в хайлоаде часто пишут свои велосипеды и можно ли это делать в своем проекте?
#podcast
https://pca.st/episode/dc75a768-f55f-4cb5-8336-328ae4bc4840
Pocket Casts Спецвыпуск! Highload на практике — как готовиться и как держать высокие нагрузки - КОДА КОДА Спецвыпуск в формате открытой дискуссии. На этот раз разговор получился настолько подробным и точным, что я уже нарезаю его на небольшой обучающий курс 🙂
Не так много проектов могут похвастаться высокими нагрузками. Нам повезло, что этот сезон мы делаем… #podcast
https://pca.st/episode/dc75a768-f55f-4cb5-8336-328ae4bc4840
- 👍 4
Post #207
387

Какой технологический стек обычно используется для микросервисов?
#перевод_для_канала_itarchitecture
На диаграмме показан стек микросервисных технологий, как для этапа разработки, так и для этапа эксплуатации.
▶️ Разработка
🔹 Определение API - устанавливает контракт между фронтендом и бэкэндом. На данном этапе мы можем использовать Postman или OpenAPI.
🔹 Разработка - React, Angular и Vue популярны во фронтенд-разработке и Node.js/Java/Python/Go для разработки бэкэнда. Кроме того, нам нужно подготовить конфигурации в API Gateway в соответствии с определениями API.
🔹 Continuous Integration (непрерывная интеграция) - JUnit и Jenkins для автоматизированного тестирования. Код упакован в образ Docker и развернут как микросервисы.
▶️ Эксплуатация
🔹 Nginx, HAProxy и Apache - распространенный выбор для балансировщиков нагрузки. Cloudflare предоставляет CDN (сеть доставки контента).
🔹 API Gateway - мы можем использовать Spring Boot в качестве шлюза и Eureka/Zookeeper для Service Discovery (обнаружения сервисов).
🔹 Микросервисы развертываются в on-premise и в "облаках". У нас есть варианты: AWS, Microsoft Azure или Google GCP.
🔹 Кэш и полнотекстовый поиск: Redis - это распространенный выбор для кэширования пар ключ-значение. ElasticSearch используется для полнотекстового поиска.
🔹 Коммуникации - чтобы сервисы могли общаться друг с другом, мы можем использовать инфраструктуру обмена сообщениями Kafka или RPC.
🔹 Хранение - мы можем использовать MySQL или PostgreSQL для реляционной базы данных, NoSQL-решения (MongoDB/CosmosDB/DynamoDB) и Amazon S3/Minio для объектного хранилища. При необходимости можем использовать Cassandra для организации хранилища с широкими столбцами.
🔹 Управление и мониторинг - для управления таким количеством микросервисов потребуются инструменты Ops, включающие Prometheus, Elastic Stack и Kubernetes.
- 👍 4
Post #206
306
Какие моменты стоит учитывать при проектировании архитектуры, только ли этим занимаются архитекторы и как учиться архитектурным тонкостям?
#podcast
https://pca.st/episode/72283b11-a1dd-45bd-9e8d-debffc4fbcf2
Pocket Casts Архитектура IT решений / Филипп Дельгядо - { между скобок } Видео https://youtu.be/Lq17AMCMLAE
Вместе с Филлипом Дельгядо соберемся провести ревью архитектурных решений, что были представлены в книге System Design Interview от Alex Xu. Обсудим какие моменты стоит учитывать при проектировании архитектуры, только ли… #podcast
https://pca.st/episode/72283b11-a1dd-45bd-9e8d-debffc4fbcf2
- 👍 4
Post #205
288
ИТ-архитектура Данные кэшируются везде - от фронтенда до бэкенда! #перевод_для_канала_itarchitecture Эта диаграмма иллюстрирует, где мы кэшируем данные в типичной архитектуре. Вдоль этого потока лежит несколько слоев: 🔹 1. Клиентские приложения: HTTP-ответы могут быть…

- 👍 2
Post #204
249
Данные кэшируются везде - от фронтенда до бэкенда!
#перевод_для_канала_itarchitecture
Эта диаграмма иллюстрирует, где мы кэшируем данные в типичной архитектуре.
Вдоль этого потока лежит несколько слоев:
🔹 1. Клиентские приложения: HTTP-ответы могут быть кэшированы браузером. Мы впервые запрашиваем данные по HTTP, и они возвращаются с политикой истечения срока действия в заголовке HTTP; мы снова запрашиваем данные, и клиентское приложение сначала пытается получить данные из кэша браузера.
🔹 2. CDN: CDN кэширует статические веб-ресурсы. Клиенты могут извлекать данные с ближайшего узла CDN.
🔹 3. Балансировщик нагрузки: Балансировщик нагрузки также может кэшировать ресурсы.
🔹 4. Инфраструктура обмена сообщениями: Брокеры сообщений сначала хранят сообщения на диске, а затем потребители получают их по мере необходимости. В зависимости от политики хранения данные кэшируются в кластерах Kafka в течение определенного периода времени.
🔹 5. Сервисы информационной системы: В сервисах есть несколько уровней кэша. Если данные не кэшируются в кэше центрального процессора (CPU), сервис попытается получить данные из памяти (RAM). Иногда сервис имеет кэш второго уровня для хранения данных на диске.
🔹 6. Распределенный кэш: Распределенный кэш, такой как Redis, хранит пары ключ-значение для нескольких сервисов в памяти. Это обеспечивает гораздо лучшую производительность чтения/записи, чем в базах данных.
🔹 7. Полнотекстовый поиск: Иногда нам нужно использовать полнотекстовый поиск, такой как Elastic Search для поиска документов или поиска в логах. Копия данных также индексируется в поисковом движке.
🔹 8. База данных: Даже в базе данных у нас разные уровни кэшей:
- WAL(Write-ahead Log - упреждающая журнализация): Данные записываются в WAL перед созданием индекса B-tree
- Buffer pool: Область памяти, выделенная для кэширования результатов запроса
- Materialized View: Предварительно вычисляет результаты запросов и хранит их в таблицах базы данных для лучшей производительности запросов
- Transaction Log: Логирует все транзакции и обновления базы данных
- Replication Log: Используется для записи состояния репликации в кластере баз данных
👉 Вопрос к вам:
Как мы можем гарантировать, что конфиденциальные пользовательские данные будут полностью удалены из систем, если данные кэшируются на многих уровнях?
Ответ:
Системы кэширования обычно работают с учетом трех временных факторов:
- промежуток времени;
- повторная валидация;
- очистка.
В зависимости от необходимости мы можем стереть данные.
Кроме того, кэшем можно управлять на стороне пользователя.
- 👍 5