Fast and Space Efficient Trie Searches
Концепт префиксных деревьев впервые был описан в 1959м году, а назван в 1960м - retrieval, из information retrieval systems. Они считаются одними из самых распространённых структур данных, потому любое улучшение в производительности или пространстве крайне интересует индустрию. Масштабы, как никак.
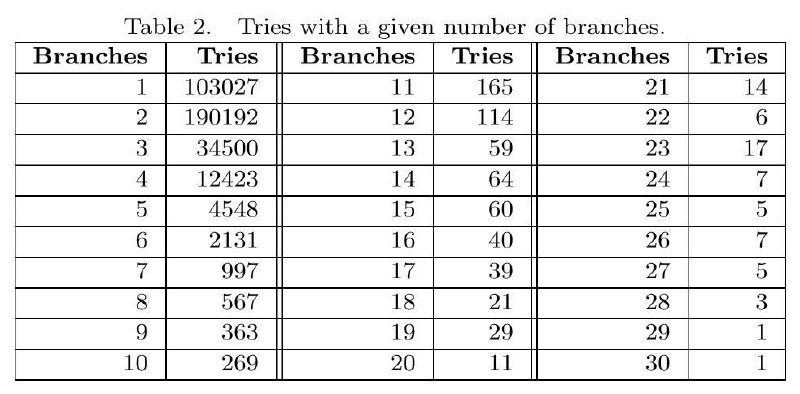
Возьмём тот же автокомплит слов в английском языке. Это примерно 150,000 уникальных слов, и при алфавите в 26 символов, согласуясь с законом больших чисел, каждое слово прокладывает уникальную путь в дереве уже в среднем после ⌈log₂₆150000⌉ = 4 символов. То есть, узлы уже на четвёртом уровне в дереве часто будут иметь по всего 1-2 исходящих узла. Что и прекрасно видно на таблице с распределением количества деревьев к количеству узлов в них (заметьте, как стремительно падает их число!). Таким образом, брать префиксы не вариант, их относительно мало.
Однако! Автокомплит использует абсолютно статичное дерево. Новые слова всё-таки редко добавляются. Значит, можем плевать на стоимость вставки - в таких объёмах, гораздо важнее смотреть на занимаемое пространство. Довольно эффективно его использует как раз ACT.
Post #631
175
- 🔥 3
- 👌 1