
همیشه برام سوال بود چرا وقتی با chatgpt فارسی صحبت میکنی خیلی کُندتر جواب میده نسبت به انگلیسی! الان اتفاقی فهمیدم
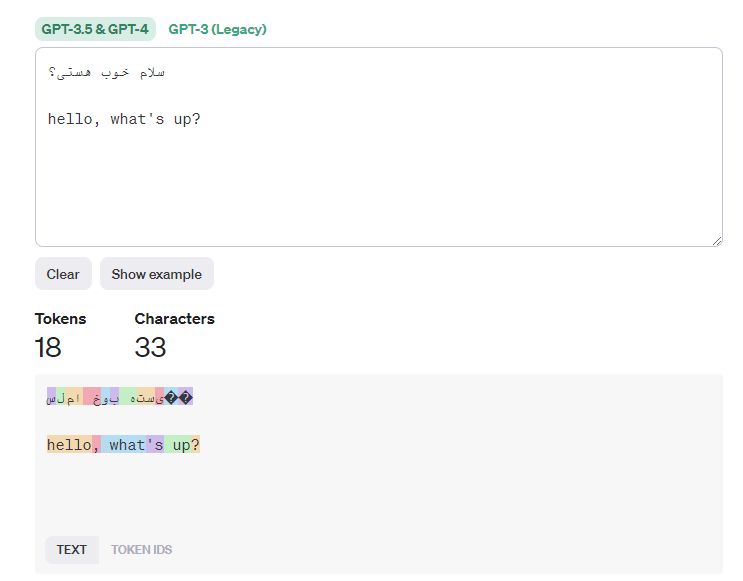
همه LLMها متن رو قبل از تبدیل به اعداد(امبدینگز)، بر اساس یک دیکشنری از پیش ساخته شده اصطلاحا توکنایز میکنن. الان دیدم تو دیکشنری gpt برای فارسی، فقط حروف الفبا توکن تعریف شده براشون و کلمات نماینده ای ندارن. مثلا کلمه 'خوب'، به جای یک توکن، سه توکن مصرف میکنه. ینی به جای یک ایتریشن، 3 ایتریشن زمان میبره تولیدش. در واقع میشه گفت تو فارسی وقتیکه تکست تولید میشه، داره حرف بعدی رو پیشبینی میکنه و نه کلمه بعد! عکسی که گذاشتم دقیق نشون میده تفاوت رو. اگه در آینده کلمات فارسیم اضافه کنن علاوه بر سرعت، صددرصد کیفیت و دقتش هم خیلی بالاتر میره.
خود OpenAI این امکانو گذاشته که ببینین یک متن چجوری به یه سری توکن شکسته میشه:
https://platform.openai.com/tokenizer
* bahar_dev_fix *
🆔 @IranCoderz | 👩💻🧑💻
Post #4417
850
- 👍 22