
Почему CoW увеличивает WAF? Часть 1
Использование файловых систем с копированием при записи (Copy-on-Write / CoW), таких как ZFS и Btrfs, оказывает специфическое влияние на коэффициент усиления записи (WAF — Write Amplification Factor) на SSD. Из-за своей архитектуры они могут как лавинообразно увеличивать WAF, так и уменьшать его.
Но критичным является именно увеличение WAF, которое при непонимании происходящих процессов может привести к самым неприятным последствиям.
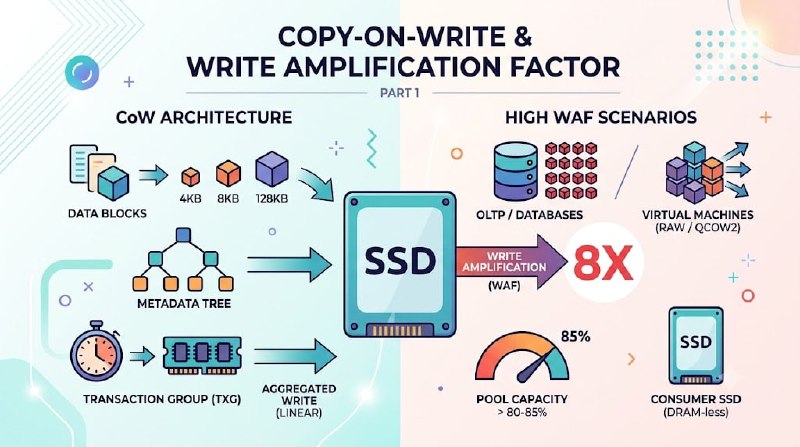
Основная причина усиления записи лежит в том, что файловые системы с CoW никогда не изменяют существующие блоки. Новые данные всегда пишутся на свободное место, а затем изменяются указывающие на них метаданные.
Даже при изменении одного байта запускается следующая цепочка событий:
▫️Записывается новый блок данных
▫️ Изменяется указывающий на него блок метаданных
▫️ Изменяется родительский блок метаданных, и так далее до корневого узла
Стоит отметить, что CoW системы оперируют достаточно крупными размерами блоков, скажем в ZFS вполне нормально увидеть блок в 128 КБ.
Таким образом активно пишущая база данных, скажем MySQL и оперирующая блоками по 4 КБ генерирует сотни килобайт записи на одну операцию, критически увеличивая объем реальной записи во флеш. Далее его умножит еще и сам твердотельный накопитель за счет алгоритмов уборки мусора.
При заполнении диска более чем на 80-85% (а при активной мелкоблочной записи и при меньших числах) происходит очередное лавинообразное увеличение WAF, потому что контроллер, не имея свободных ячеек для записи пытается на лету очищать текущие.
Таким образом худшие сценарии для CoW файловых систем и SSD это:
🔹 Базы данных с интенсивной случайной записью (OLTP): PostgreSQL, MySQL/MariaDB, Oracle. Постоянные мелкие транзакции (обычно по 8 или 16 КБ) и частые вызовы fsync вызывают колоссальный WAF.
🔹 Образы виртуальных машин: Запуск баз данных или активных ОС внутри raw-образов или qcow2 поверх CoW. Накладываются две ФС друг на друга, что умножает WAF.
🔹 Заполнение пула > 80-85%: В CoW-системах при дефиците места механизмы аллокации начинают тратить огромные ресурсы на поиск свободных блоков, что перегружает и ФС, и контроллер SSD.
🔹 Использование потребительских (Consumer) SSD: Бюджетные диски без DRAM-буфера и с агрессивным SLC-кэшированием при высоком WAF быстро теряют производительность и выходят из строя.
Чтобы минимизировать это явление можно использовать:
🔹 Включение встроенного сжатия (LZ4 / ZSTD). Если данные хорошо сжимаются, физический объем данных, отправляемых на SSD, уменьшается (например, в 2 раза). Это пропорционально снижает WAF. Даже с учетом накладных расходов на метаданные, итоговый износ диска часто оказывается ниже, чем на ext4 без сжатия.
🔹 Выравнивание блоков (Recordsize / Volblocksize). Размер блока ФС должен строго соответствовать размеру блока приложения. Если СУБД оперирует блоками по 8 KБ, то на ZFS также ставьте recordsize=8k
🔹 Ограничение синхронной записи. Если потеря последних 5 секунд данных при сбое питания не критична, можно установить sync=disabled (в ZFS), что уберет двойную запись через ZIL.
Последнее требует отдельного пояснения, так как синхронная запись не должна быть потеряна, ZFS использует ZIL (ZFS Intent Log), куда синхронные записи (fsync) пишутся немедленно. Это означает, что одни и те же данные сначала пишутся в лог (для отказоустойчивости), а затем, спустя короткое время, сбрасываются на диск.
Отказ от синхронной записи также позволяет более эффективно использовать:
🔹 Агрегирование записи в оперативную память. ZFS собирает все асинхронные записи в транзакции (Transaction Groups) в RAM и сбрасывает их на диск раз в несколько секунд большими линейными пачками.
На этом сегодня закончим, но на самом деле это только начало, в следующих публикациях мы разберем особенности, связанные с использованием виртуальных машин и снапшотов, которые тоже способны преподнести множество неприятных сюрпризов.
Post #6498
2.39K
- 👍 38
- ❤ 3
- 🤔 1