TGViewer
Channel Public Channel
InSAйт

InSAйт

@insight_t_bank

Привет! Это канал команды системных аналитиков Т-Банка. Здесь будем делиться кейсами, технологиями и инсайтами.

Анонсы митапов, статьи, подкасты и доклады: https://t.me/kod_zheltyi
О жизни команд, карьере и открытых вакансиях: https://t.me/t_crew
Subscribers
3.15K
Photos
246
Videos
3
Links
103
Recent Posts 18 shown
Post #329 597

Forwarded from System Design World (Владимир в IT)

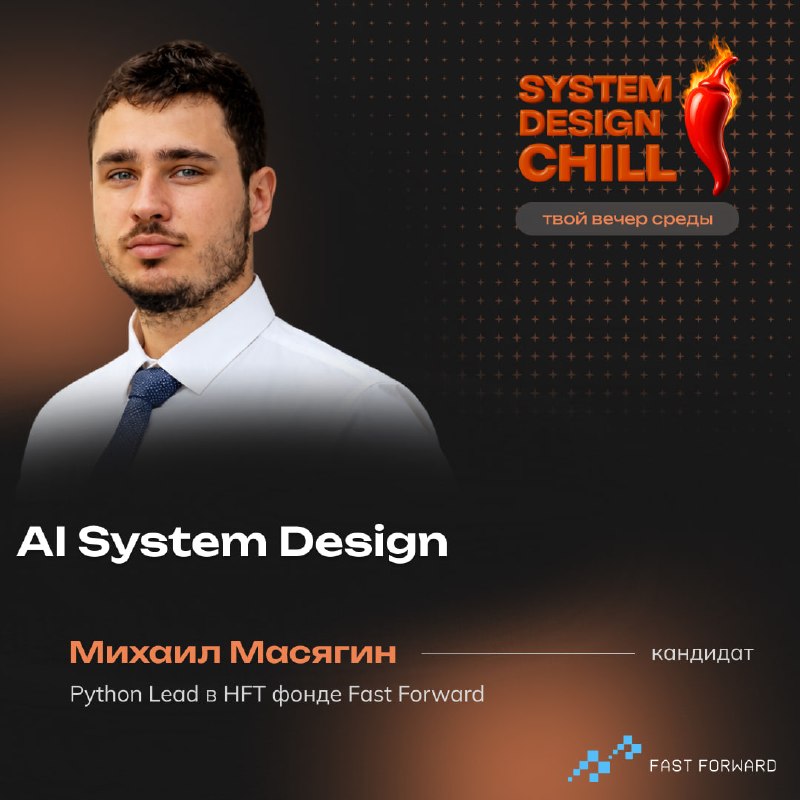
🏦 AI System Design Интервью. T-Банк edition.

👋 Встречаем обновленную секцию!
Которую совсем скоро будут проходить специалисты индустрии.✍️

Обкатываем на моём канале 😊
В эру разносов и разделений лично мне хочется сплоченности. Строить мосты. Находить общий интерес. 😃
Рад, что канал становится точкой притяжения крутых специалистов и ТОПовых компаний.

💬 Итак, в среду к нам придут:
1. Алексей Тарасов - Технический директор интерфейсов экосистемы Т-Банк.
➡️Алексей занимается платформой мобильных и веб-приложений компании, дистрибуцией, технологиями безрелизной доставки, авторизацией клиентов в экосистеме.

2. Александр Черников - Chief Reliability Officer в Т-инвестициях.
➡️Писал руками код еще когда ЭВМ были большие, а сети маленькие. Занимал ключевые позиции в бигтехах: OZON, Wildberries, Yandex.
Канал Александра про ИИ, разработку и безопасность - Слезы Тьюринга.
Встретиться на -> linkedin <-

3. Михаил Масягин - Team Lead backtest HFT фонда
➡️Тот самый Михаил, который в МГТУ готовится к защите диссертации, ведёт СУБД часть System Design Интенсива.
Михаил ведёт свой канал про python, phd, ИИ - P(hD)ython.
Будет решать задачу 💙 Станет первым кандидатом этого формата секции :)

🥁 Барабанная дробь! Описание секции в студию!
——————————————————-
—> AI System Design T-Банк readme <—
——————————————————-

❓ Вопросы
Можно задавать вопросы по акцентам прохождения. На интервью осветим. Может, сделаем отдельный чек-лист 🤔
Ну и освобождаем вечер среды для приятного времяпрепровождения 😊 2 ЧАСА 😮

👉 Получить ссылку можно в моменте регистрации.
Старт - 30.09.26(ср) 19:00.
\\\ Зарегистрироваться здесь. ///
Одновременное присутствие участников - 100. Надеюсь, вместимся 🎈
  • ❤ 9
  • 👍 2
  • 🔥 2
Post #328 648
От автора: данный пост написан с помощью ИИ. Агент получил задание проанализировать мои сессии и составить список типичных задач, с которыми я к нему обращаюсь. Но получилось у него не все, поэтому предлагаю угадать, какие пункты написаны вручную 😉

ИИ стал для меня рабочим инструментом. Ключевое — он не отвечает вместо меня, а считает и структурирует за меня.

Примеры конкретных кейсов:

1. Работа с документацией через IDE.
Ассистент смотрит в исходники: ищет по коду, как реализован функционал, сверяет документацию с фактической реализацией. Это позволяет не верить описаниям, а сверять их с кодом. Когда документация — это JavaScript приложения, где страницу нельзя прочитать напрямую, он достаёт контент из репозитория.
Пример — внедрение информации по новой фиче.

2. ИИ как вычислительный и аналитический движок.
Я приношу сырую постановку (объекты, критерии, ограничения) и прошу ИИ выполнить точный расчёт: отобрать, сгруппировать, перебрать варианты, составить порядок. При этом я сам задаю правила — какие признаки учитывать, что исключить, как трактовать «покрытие» или «готовность». ИИ быстро просчитывает многошаговые комбинации, которые вручную заняли бы часы.
Пример — просчёт приоритетов для нового продукта: подаю на вход результаты проведенного анализа, провожу сложные сортировки и комбинации по фичам и их влиянию на ключевых заказчиков.

3. Составление запросов и скриптов для работы с данными.
Отправляю агенту запрос на поиск или схему таблиц, пишу уточняющий промпт. В результате формируются скрипты в требуемом формате, проверяются на работоспособность и соответствие начальной постановке.
Пример — создание скрипта для получения статистики из чата поддержки.

Общие принципы:

✨ Итеративное уточнение постановки.
Это главный паттерн. Я редко формулирую задачу сразу корректно — начинаю с одной трактовки, вижу результат, затем подправляю условие. ИИ каждый раз пересчитывает с нуля. Получается «диалог-уточнение»: быстрая проверка гипотезы → коррекция → новый расчёт.

✨ Требовательность к достоверности.
Я требую от ИИ честно помечать неопределённость — «нет данных», «требует уточнения» — а не додумывать. Когда данных не хватает, он признаёт это и спрашивает, а не выдумывает цифру. Это работает и в обратную сторону: я проверяю выводы и возвращаю их на доработку.

✨ Работа со сложными корпоративными системами.
ИИ для меня — проводник в плотной внутренней инфраструктуре: документация, вики-пространства, метрики платформ. Он использует MCP для доступа к разным системам: Gitlab, Confluence, таск-трекеры, страницы с документацией от команд. Многое из этого вручную либо требует переключения между десятком инструментов, либо невозможно.

✨ Переиспользование накопленных решений.
Строю работу на принципе «уже делали — не начинай заново»: ИИ помнит рабочие скрипты и подходы, проверяет их на актуальность под новую постановку и дорабатывает точечно, а не пишет с нуля.

Главный принцип, который я держу: ИИ ускоряет и дисциплинирует мою работу, но решения и критерии — мои. Содержание, правила отбора и бизнес-смысл я задаю сам; ИИ отвечает за скорость вычислений, аккуратность структуры и честность.
  • ❤ 3
  • 👍 3
  • 🥰 1
  • 🐳 1
Post #326 896
Всем привет! 🔥

Сегодня – последний пост из серии Продвинутого SQL😭, и мы вернемся к задаче построения аналитического отчета.

Эффективное нормализованное хранение данных в реляционных СУБД противоречит визуальному удобству пользователей при анализе этих самых данных. В связи с этим прочтение и исследование аналитических отчетов, построенных на базе реляционного хранилища, становится сложным и неудобным.
В таких случаях и помогает функция crosstab, которая позволяет транспонировать структуру данных в СУБД PostgreSQL, превращая «длинный» формат строк в "короткий" (в других СУБД есть аналоги данной операции – к примеру, в Oracle есть команда PIVOT).

Когда crosstab эффективен⚡

Функция crosstab эффективна, когда:
➡️ нужно отдать фронтенду или аналитикам готовую матричную структуру сводной отчетности
➡️ количество столбцов-атрибутов в сводном отчете заранее известно и не изменяется
➡️ требуется высокая производительность на больших объемах (работает быстрее, чем ручная группировка)

Особенности синтаксиса команды crosstab

1. Установка расширения tablefunc *⃣
CREATE EXTENSION IF NOT EXISTS tablefunc;
Crosstab является инструментом из официального расширения, поэтому сначала требуется поставить это расширение.

2. Написание самой команды *⃣
Функция crosstab принимает в качестве аргумента SQL-запрос в формате текстовой строки и возвращает набор строк по определенным правилам. Входной SQL-запрос должен возвращать строго определенный порядок колонок, среди которых:
➡️ RowId – идентификатор записи (останется в левом вертикальном столбце сводной таблицы)
➡️ Category – категория для группировки (то, что конвертируется в столбец сводной таблицы)
➡️ Value – значение (то, что будет значением ячейки сводной таблицы)

Пример использования

Допустим, у нас есть таблица sales со следующей структурой:
| year | quarter | total_sum |
|------|---------|-----------|
| 2025 | Q1 | 100 |
| 2025 | Q2 | 150 |
| 2026 | Q1 | 120 |


Пишем запрос с crosstab:
-- включаем расширение
CREATE EXTENSION IF NOT EXISTS tablefunc;
 
-- выполняем сводный запрос
SELECT * FROM crosstab(
    'SELECT year, quarter, total_sum
     FROM sales
    -- без явного порядка сортировки СУБД может запутаться, к какому году относится какой квартал, и запрос корректно не сработает
     ORDER BY year, quarter',
    -- точный список будущих колонок-категорий
    'VALUES (''Q1''), (''Q2'')'
)
-- структура финальной таблицы
AS pivot_report(
    year INT,
    Q1 INT,
    Q2 INT
);


По итогам получаем следующий результат:
| year | Q1  | Q2   |
|------|-----|------|
| 2025 | 100 | 150 |
| 2026 | 120 | null |


🧡 А вам приходилось сталкиваться с функцией crosstab ?
  • 🔥 7
  • ❤ 3
  • 💘 1
Post #325 1.03K
Практические выводы🥸
Если возникает единый квант «потребитель-поставщик», стоит разрывать синхронную связь. Хорошие инструменты для этого — событийная архитектура и self-contained-сервисы.
Простой индикатор размера кванта — развёртывание. Монолит устроен по принципу «всё или ничего»: выкатить часть невозможно, значит, квант большой. А большой квант — это плохо: вы связаны с соседями на уровне данных и не можете развернуть компонент независимо. Микросервисы дают кванты поменьше, но за это приходится платить координацией и сложностями с транзакциями.

Квант — не абстракция ради абстракции. Это рабочий инструмент: если смотреть на систему через деплой, сплочённость и способ связи, сразу видно, где реально одна неделимая единица, а где их несколько.
  • ❤ 6
  • 👍 2
  • 👎 1
  • 🔥 1
Post #324 995
Что такое «архитектурный квант» и почему об этом стоит думать🔘
Разговоры про coupling, cohesion и гранулярность идут давно. Но есть понятие, которое собирает всё это в единую картину, — архитектурный квант.
Определение у Нила Форда звучит громоздко: независимо разворачиваемый артефакт с высокой функциональной сплочённостью, высокой статической связанностью и синхронной динамической связанностью. Однако смысл проясняется, если разобрать его по частям.

«Независимо разворачиваемый» 💅 — здесь всё однозначно. Квант — это то, что можно зарелизить отдельно. Монолит по определению один квант, потому что разворачивается целиком. В микросервисной архитектуре, наоборот, стремятся к тому, чтобы каждый сервис можно было деплоить самостоятельно.
«Высокая функциональная сплочённость»🤝 — речь про то, насколько часть системы самодостаточна в рамках рабочего процесса. Не про то, как сервисы взаимодействуют, а про то, достаточно ли одного из них, чтобы пользователь получил свою пользу. Для покупки в интернет-магазине нужны и заказ, и оплата, и доставка — именно такая связка и составляет сплочённость в рамках пользовательского сценария.
«Высокая статическая связанность»🔤 — про то, на чём квант держится: базы данных, фреймворки, библиотеки, операционная система. Здесь важен именно уровень. Общая база данных — это высокая связанность, очередь — средняя, оркестратор — низкая.
«Синхронная динамическая связанность»😎
 — самая важная часть. Это про то, как кванты взаимодействуют во время выполнения. Если один сервис синхронно вызывает другой, у них должны совпадать атрибуты качества: когда вызывающий масштабируется интенсивнее вызываемого, возникают таймауты и проблемы с надёжностью. Синхронный вызов автоматически включает вызываемого в тот же квант — вне зависимости от желания проектировщика.

Нагляднее всего это видно на примерах⬇️
Любой монолит — один квант: единый юнит деплоя, обсуждать здесь нечего.

Интереснее с SOA (Service-Oriented Architecture). Архитектура выглядит модульной, но если все сервисы работают на одной реляционной базе — это высокая статическая связанность, и вся система остаётся одним квантом. Разделить логически получилось, а развернуть по-настоящему независимо — нет.

Есть и более сложные случаи, когда квант формируется сразу из двух точек. Например, EDA (Event-Driven Architecture) с центральным медиатором. Связь даёт и общая база данных, и сам медиатор как единая точка входа. Если он оркестрирует операцию, фактически представляя собой распределённую транзакцию, — система схлопывается в один квант.

Микросервисы сами по себе дают много независимых квантов: восемь сервисов — восемь квантов. Но картина меняется, как только подключаются пользовательские сценарии. Если система тесно завязана на единый пользовательский интерфейс, сплочённость высокая, и это снова один квант. А при переходе на микрофронтенды возвращаются те же восемь независимых квантов.

Показателен пример интернет-магазина с синхронным оркестратором. Четыре сервиса: заказ, оплата, доставка, продукты. Казалось бы, четыре кванта. Но сервис заказа синхронно взаимодействует со всеми остальными и требует от них единой операционной доступности. Получается, что квант заказа охватывает остальные сервисы. Может показаться, будто кванты вкладываются друг в друга, но это не так: просто существуют разные пользовательские сценарии — одни живут сами по себе, другой тянет всю цепочку. Это не вложенность, а разные сценарии, по-разному группирующие сервисы.

Тот же магазин, но с асинхронной SAGA, выглядит иначе. Сервисы не связаны операционными характеристиками, в рамках рабочего процесса каждый самодостаточен — и получаются честные четыре независимых кванта. Одно лишь изменение способа связи радикально меняет архитектурную картину.
  • ✍ 5
  • ❤ 3
  • 🔥 1
  • 🫡 1
Post #323 1.21K
  • 😁 17
  • 👍 3
Post #322 1.15K
Всем привет! ⛈

На очереди третья #загадка 😦 Ждём ваши ответы!

Представь, что ты пришел в кафе и хочешь заказать бургер. Но ты не идёшь сам на кухню к повару и не несешь ему продукты из холодильника – вместо этого ты подходишь и проговариваешь свой заказ кассиру, который в свою очередь передает его на кухню, где его готовят. После того, как заказ готов – кассир забирает бургер с кухни и отдает его тебе, при этом вы с поваром так и не пообщались напрямую.
  • ❤ 4
  • 👍 2
  • 🔥 1
Post #321 1.66K
Почему хочется склеить обратно?🫂

А вот когда данные должны меняться атомарно - всё наоборот. Записали профиль пользователя в один сервис, а второй в этот момент упал - и здравствуй, пользователь-Шрёдингер. В распределённой системы настоящих транзакций не бывает, а если они правда нужны - это веский аргумент не дробить.
Дальше - межсервисное взаимодействие. Чем мельче нарезали, тем больше связей. И вот уже один запрос пользователя превращается в цепочку из пяти вызовов по 300 мс - 1,5 секунды на пустом месте, а если один сервис в этой цепочке упал, за ним транзитивно ложатся все остальные. А нужно ли тогда такое разделение?

Общий код - та же история. Сменили общую библиотеку - и все пять сервисов, которые её используют, надо менять, тестировать и деплоить вместе. Если так происходит постоянно, зачем они вообще отдельные? *️⃣

И последнее по порядку, но не по важности - данные. Можно сервис разрезать на функции A, B и C. Но если B и C завязаны на одни и те же таблицы, разносить их по разным сервисам - значит передавать через сеть то, что должно лежать рядом. Логичнее B и C оставить вместе, а отдельно вынести только A.

Так как же найти баланс?🤔
Универсальный ответ сложно подобрать, но можно руководствоваться правилом - если нет НФТ, которые принуждают разделить, держим вместе. Это не жёсткие правила, а вопросы, которые стоит задавать себе перед тем, как разделять или совмещать. Ошибки при определении границ могут проявиться позже при развитии - каждое изменение приходится согласовывать, и фичи доезжают до пользователя в разы дольше.

Поэтому вместо «как правильно разбить» стоит спросить себя о другом. Что меняется вместе - должно лежать рядом. Что меняется независимо - должно разворачиваться независимо. И главное - сколько стоит каждая связь. Связь с легаси-системой, которую не трогали годами, может быть максимально грязной и при этом совершенно не болеть. А идеально «правильная» архитектура, которую приходится постоянно согласовывать между командами, - болеть будет нещадно.

Гранулярность - это всегда компромисс. И искать его стоит не в идеальных схемах, а в том, насколько "больно" и "дорого" вам вносить изменения.😉
  • 🔥 12
  • ❤ 3
  • 👍 1
  • 🤔 1
  • 💘 1
Post #320 1.34K
Что заставляет сервис распухать (или рассыпаться в пыль)? 🤔

У каждого бывало: сервис разросся так, что любая правка - как поход в сапёр. А у кого-то наоборот - напилили двадцать микросервисов, и теперь, чтобы добавить одну кнопку, надо созвониться с тремя командами.📞

И то и другое - про гранулярность. Про то, на какие куски мы режем систему и насколько эти куски вообще надо было резать.

Нет одного «правильного» размера. Есть две силы: что-то толкает нас дробить сервис, что-то - склеивать обратно. Попробуем разобраться.

Почему хочется разнести?🥊
Самая очевидная причина - сервис начал делать слишком много несвязанных дел. Тут легко ошибиться. Например, сервис нотификаций: смс, почта, бумажные письма. Вроде бы можно разрезать на три, но они отличаются только способом доставки - и любое общее изменение придётся вносить и согласовывать сразу в трёх местах. Толку от такого разделения нет.

Дальше - частота изменений. Смотришь в репозитоирй, что и как часто меняется, и картина проясняется. Скажем, смс и почта трогают раз в полгода, а бумажные рассылки - каждые две недели. Очевидно, что самое «горячее» стоит вынести отдельно: меньше перетестировать того, что не менялось, меньше шансов задеплоить что-нибудь кривое в стабильный функционал.

Ещё бывает, что части нужно масштабировать по-разному - у вас смс - 220 тысяч за минуту, почта - 500, бумага - одна в минуту. Если всё в одном сервисе, вы будете тащить инфраструктуру под худший случай, а если разъединить, то каждая часть живёт под свою нагрузку.

А ещё отказоустойчивость. Если у почты регулярно что-то отваливается, это тянет за собой всё остальное. Выносим "капризный" модуль отдельно - остальные сервисы переживает его падение.

Иногда разделение вынуждено, например говоря про безопасность: карточные данные по PCI DSS должны лежать на своём контуре, а весь остальной функционал - на своём, иначе нам придется сертифицировать весь контур, а это больно и дорого.

Не стоит забывать и про расширяемость. Платёжный сервис принимает карты, подарочные карты. А дальше хочется бонусные баллы, Т-Pay, оплату по биометрии. Каждый раз, когда добавляешь новый способ оплаты, тестируешь весь сервис целиком и молишься, чтобы деплой прошёл гладко. Чем больше способов - тем тяжелее, в какой-то момент это и подталкивает разнести.

📚 А с какими причинами для разделения сервисов сталкивались вы? Делитесь в комментариях)
  • ❤ 6
  • 🤩 3
  • 👍 1
Post #318 1.04K
Всем привет! 🧡

Заканчиваем серию постов про сложные SQL-группировки, и на очереди - CROUPING SETS.

GROUPING SETS - выборочная группировка ✉️

Когда полезен ⚡️
Когда отсутствует единый паттерн группировки, и пользователь хочет настроить ее гибко: в таком случае использование ROLLUP малополезно (пользователю может быть не нужна иерархия), а CUBE - избыточно (зачем все комбинации, если нужна всего одна или две?).
В таком случае GROUPING SETS и становится лучшим выбором.

Пример 📚
Допустим, у нас есть все та же таблица grouping со следующим набором данных:
| year | month | day | total |
|------|-------|-----|-------|
| 2025 | 1| 1| 200|
| 2025 | 1| 1| 130|
| 2025 | 1| 2| 100|
| 2025 | 2| 1| 900|
| 2026 | 11| 13| 60|

Требуется написать запрос, который выведет суммарную прибыль с группировкой по числам и по месяцам разных лет (без учета дней).


В таком случае ROLLUP нам не поможет, так как он выведет информацию с группировкой по числам, по числам месяцев и по числам месяцев различных лет, что нам не требуется.
Что касается CUBE, он выведет все возможные комбинации, среди которых будут и нужные, но большинство из них мы рассчитывать не планировали.

Запрос *️⃣
SELECT year, month, day, SUM(total)
FROM grouping
GROUP BY GROUPING SETS (
(day),
(year, month)
);


Результат ✉️
| year | month | day | total |
|------|-------|-----|-------|
| | | 13| 60|
| | | 2| 100|
| | | 1| 1230|
| 2025 | 2| | 900|
| 2026 | 11| | 60|
| 2025 | 1| | 430|

Поскольку сортировка явно не задана, порядок строк выбран произвольно.


Какие из группировок (ROLLUP, CUBE, GROUPING SETS) вы знали до того, как мы опубликовали эту серию постов?

#SQL
  • ❤ 5
  • ✍ 2
  • 👍 1
  • 🔥 1
Post #316 1.36K
Всем привет! ⚡️

Продолжаем цикл "загадок для ребенка", на очереди вторая #загадка 🔍
Представь, что ты учишь стих. В первый раз ты долго ищешь книгу, открываешь нужную страницу и читаешь строки. Это продолжается еще несколько раз. Но потом, когда тебя в школе просит учитель – ты уже не бежишь за книгой, а достаешь его из своей головы, потому что он сохранился в твоей памяти на какое-то время. При этом после окончания урока через какое-то время ты можешь забыть этот стих, когда выучишь еще какое-то количество других стихов – потому что этот стал уже менее полезным, чем новые.
  • ❤ 1
  • 👍 1
  • 🔥 1
Post #315 1.83K
Привет! Сегодня мы познакомимся с краткой версией статьи на Habr от Ирины Матевосян, системного аналитика из T-Mobile Core.

Что это вообще такое?
gRPC — это протокол, для передачи информации и поведения между системами. Представьте, что один сервис говорит другому: «Эй, выполни вот эту функцию с такими-то данными». Второй сервис слышит запрос, выполняет и отвечает. Со стороны это выглядит так, будто функция вызывается прямо внутри программы, а не где-то на другом сервере.

Такой подход используют компании, у которых под капотом очень много всего происходит одновременно — Google, Netflix, IBM, Twitter.

Чем gRPC отличается от REST?
У REST логика такая — клиент просит данные или просит их обновить. В gRPC клиент говорит серверу: «Сделай вот это». То есть вызов конкретной функции вместо работы с ресурсами.

Ещё одно отличие: gRPC работает поверх HTTP/2 и держит постоянное соединение между клиентом и сервером, поэтому они могут обмениваться несколькими сообщениями одновременно — REST так не умеет.

Как описывается контракт?

Всё взаимодействие строится вокруг proto-файла — это текстовый файл, в котором описано, какие функции существуют, какие данные им передаются и что они возвращают. Файл читается как обычный текст, так что аналитик вполне может в нём разобраться.

syntax = "proto3";

package order;

// Сервис для работы с заказами
service OrderService {
rpc CreateOrder (CreateOrderRequest) returns (CreateOrderResponse);
rpc GetOrder (GetOrderRequest) returns (GetOrderResponse);
rpc CancelOrder (CancelOrderRequest) returns (CancelOrderResponse);
}

// Создание заказа
message CreateOrderRequest {
string user_id = 1;
repeated OrderItem items = 2;
string delivery_address = 3;
}

message CreateOrderResponse {
string order_id = 1;
string status = 2;
string created_at = 3;
}

// Получение заказа
message GetOrderRequest {
string order_id = 1;
}

message GetOrderResponse {
string order_id = 1;
string user_id = 2;
repeated OrderItem items = 3;
string status = 4;
string delivery_address = 5;
string created_at = 6;
}

// Отмена заказа
message CancelOrderRequest {
string order_id = 1;
string reason = 2;
}

message CancelOrderResponse {
bool success = 1;
string message = 2;
}


Про данные и типизацию
Данные в gRPC передаются не текстом, как в REST, а в бинарном виде. Это делает их легче по размеру, но прочитать их без декодера уже не получится.

Каждое поле в контракте имеет тип и номер. Эти вещи нельзя менять произвольно — если попробуете изменить тип или переиспользовать номер, получите ошибку. Единственный рабочий способ что-то скорректировать — удалить старое поле и добавить новое с новым номером. Это кажется неудобным, но именно такая жёсткость позволяет добиться обратной совместимости.

Плюсы:
🔥 Быстрое и стабильное взаимодействие между сервисами
🔥 Proto-файл сразу сообщает разработчикам об изменениях в контракте
🔥 Бинарный формат весит меньше, чем текст в JSON
🔥 Встроенная типизация снижает количество ошибок
🔥 Контракт при этом остаётся читаемым для человека

Минусы:
📚 Для работы в браузере требуется gRPC-WEB - прослойка между gRPC и браузером. Штатно браузер не поддерживает HTTP/2 и не может работать с gRPC
📚 Сообщения без декодера человек прочитать не сможет
📚 Нужна поддержка gRPC и на клиенте, и на сервере
📚 С обработкой ошибок ситуация не лучше, чем в REST: типовых кодов не хватает, и на практике приходится добавлять свои

Когда стоит смотреть в сторону gRPC?
🧡 Высоконагруженные системы и IoT
🧡 Передача больших объёмов данных
🧡 Приложения реального времени и потоковая обработка
🧡 Удалённое администрирование
🧡 Туннелирование

Итог
Решение о том, использовать gRPC или нет, принимается вместе с разработчиками и архитекторами. Аналитику не обязательно знать все детали реализации, но понимать, как это работает и на что влияет — важно. Это помогает участвовать в обсуждении осмысленно, а не просто соглашаться с тем, что предложат.

Кстати, буква «g» в названии gRPC каждый раз означает что-то новое. В версии 1.83 это garden.
  • 👍 17
  • 🔥 8
  • ❤ 7
  • 🤩 1
Post #314 1.25K
Всем привет! 🧡

Продолжаем тему сложных группировок, и сегодня на очереди - CUBE.

Cube - полная перекрестная группировка ✉️

Отличия от Rollup ✨
В случае с Rollup, порядок столбцов определяет иерархическую сортировку - то есть ROLLUP(year, month, day) означает, что группировка будет по дням, по месяцам (с учетом дней) и по годам (с учетом месяцев и дней).
Если мы говорим про Cube, то группировка осуществляется по всем комбинациям параметров. Например, в данном случае, по годам (с учетом конкретных дней, без месяцев). Подробнее - ниже в примере.

Когда полезен ✨
Используется нечасто, в основном для многомерного анализа данных, когда важно сразу несколько срезов, и параметры равноценны.

Пример 📁
Допустим, у нас есть таблица grouping со следующим набором данных:
| year | month | day | total |
|------|-------|-----|-------|
| 2025 | 1| 1| 200|
| 2025 | 1| 1| 130|
| 2025 | 1| 2| 100|
| 2025 | 2| 1| 900|
| 2026 | 11| 13| 60|

Требуется написать запрос, который выведет суммарную прибыль во всех возможных срезах.


Запрос *️⃣
SELECT year, month, day, SUM(total)
FROM grouping
GROUP BY CUBE(year, month, day);


Результат *️⃣
| year | month | day | total |
|------|-------|-----|-------|
| | | | 1390|
| | | 13| 60|
| | | 2| 100|
| | | 1| 1230|
| | 11| | 60|
| | 2| | 900|
| | 1| | 430|
| 2025 | | | 1330|
| 2026 | | | 60|
| | 1| 1| 330|
| | 11| 13| 60|
| | 1| 2| 100|
| | 2| 1| 900|
| 2026 | | 13| 60|
| 2025 | | 1| 1230|
| 2025 | | 2| 100|
| 2025 | 2| | 900|
| 2026 | 11| | 60|
| 2025 | 1| | 430|
| 2025 | 1| 2| 100|
| 2025 | 2| 1| 900|
| 2025 | 1| 1| 330|
| 2026 | 11| 13| 60|

То есть, запрос вывел общую сумму во всех возможных комбинациях/срезах.
Так как сортировка явно не задана, записи отсортированы в произвольном формате.


Приходилось ли вам выбирать между ROLLUP и CUBE в реальных задачах?

#SQL
  • ✍ 8
  • 👍 4
Post #313 1.37K
В наших диалогах про ИИ незаметно появилось новое слово – Harness

Давайте разберемся, это новая сущность, новый термин, собирательный образ или просто модное словечко?

Дословно harness переводится как упряжь или сбруя. То есть то, что помогает в точном управлении 😊
В контексте ИИ harness — обвязка вокруг модели.

Всё то, что превращает голый языковой движок в рабочий инструмент: промпты, инструкции, память, инструменты, проверки, логика вызовов.

Как пример:
🔥 GPT (API OpenAI) или Claude (Anthropic) - модель
🔥 ChatGPT, Codex, Cursor - уже harness

Каким бывает harness на практике? Рассмотрим абстрактное деление по уровням сложности реализации и эксплуатации:

✨ Простой: системный промпт с ролью и правилами. «Делай задачу, как синьор разработчик из FAANG». Уже harness.
✨ Средний: промпт плюс инструменты - поиск, калькулятор, доступ к базе данных. Модель не просто отвечает, а может проводить поиск, исследования, вычисления.
✨ Сложный: полноценная сервисная архитектура, давайте рассмотрим подробнее.

Как устроен сложный harness?

По сути это набор сервисов с чёткими зонами ответственности:
1⃣ Сервис оркестрации — workflow-движок: принимает входящий запрос, декомпозирует задачу на шаги, управляет последовательностью.
2⃣ Сервис исполнения — вызывает инструменты: внешние API, базы данных, запуск кода.
3⃣ Сервис памяти — два уровня: краткосрочный контекст сессии и долгосрочное хранилище БД. Отвечает за то, что система помнит контекст между вызовами.
4⃣ Сервис валидации — проверяет промежуточные и финальные результаты на соответствие требованиям, фильтрует недопустимые ответы (guardrails), логирует каждый вызов.
5⃣ Сервис роутинга — решает, какую модель подключить под конкретный шаг: дешёвую и быструю или точную и дорогую.

Между сервисами уже более классические принципы обещния: входные и выходные данные, таймауты, fallback-логика. Всё как в микросервисной архитектуре, только вместо бизнес-логики внутри каждого сервиса языковая модель.

Именно такой harness стоит за продуктами, которые кажутся умными: это просто хорошо упакованные базовые модели.

Итого: harness не модное слово. И чем сложнее задача, тем важнее понимать и управлять этой архитектурой.
  • ✍ 19
  • ❤ 9
  • 🥰 3
  • 🤔 1
  • 🥴 1
Post #312 1.67K
От школы до сеньора – сегодня на ИТ-Пикнике

Сегодня в Москве проходит ИТ-Пикник, и мы тоже будем там.

В 14:00 в лектории «Т-Образование» наши системные аналитики Илья и Александра расскажут, как построить карьеру в ИТ: от первых проектов ещё в школе до позиции сеньора – в системном анализе и не только.

Приходите – будет насыщенно, полезно и без скучных карьерных шаблонов.

А здесь собрали все ссылки из презентации. Сохраняйте, чтобы не потерять 👇

Для школьников

– Проекты и образовательные курсы
– Т-Класс
– Московская Школа программистов – несмотря на название, учиться можно не только в Москве

Для студентов и начинающих специалистов

– Образовательные программы Т-Образования
– Стажировки в Т-Банке
– Talents at T-Bank

Чтобы познакомиться с Т-Банком ближе

– Экскурсии в офисы в Москве и Санкт-Петербурге
– Центры разработки в регионах

Для тех, кто готов делиться опытом

– Стать преподавателем Т-Образования

Про всё это, и даже немного больше, расскажем сегодня на ИТ-Пикнике.

И да, вы узнаете, при чём тут аниме 😍
  • ❤ 7
  • 🔥 3
  • 👍 2
Post #311 1.52K
Всем привет! 🧡

Думаю, что многие из вас так или иначе занимались аналитическими выгрузками для бизнеса. Выбрать функцию, корректно подобрать группировку и посчитать агрегированные сведения (общее количество, мин. и макс. значения, среднее). Но мало кто смотрел дальше простого GROUP BY, потому что его хватало. А ведь возможности группировки намного шире... 🔍

В ведущих СУБД «из коробки» существует сразу несколько расширений традиционного оператора GROUP BY, позволяющих собирать сложные аналитические отчеты, не прибегая к многочисленному количеству отдельных SQL-запросов или использованию специализированных аналитических скриптов, первому из них и посвящен сегодняшний пост из серии "Продвинутого SQL".

Rollup - иерархическая группировка ✉️

Когда полезен ✨
Когда нужны не только общие итоги, но и каскадная группировка по каждому из промежуточного набора уровней.

Пример 📁
Допустим, у нас есть таблица grouping со следующим набором данных:
| year | month | day | total |
|------|-------|-----|-------|
| 2025 | 1| 1| 200|
| 2025 | 1| 1| 130|
| 2025 | 1| 2| 100|
| 2025 | 2| 1| 900|
| 2026 | 11| 13| 60|

Требуется написать запрос, который выведет суммарную прибыль в срезе дней, месяцев и лет.


Запрос ☑️
SELECT year, month, day, SUM(total)
FROM grouping
GROUP BY ROLLUP(year, month, day);


Результат ↗️
| year | month | day | total |
|------|-------|-----|-------|
| 2025 | 1| 1| 330|
| 2025 | 1| 2| 100|
| 2025 | 1| | 430|
| 2025 | 2| 1| 900|
| 2025 | 2| | 900|
| 2025 | | | 1330|
| 2026 | 11| 13| 60|
| 2026 | 11| | 60|
| 2026 | | | 60|
| | | | 1390|

То есть, запрос вывел общую сумму за каждый день, агрегированные показатели за каждый месяц, суммарное значение за каждый год, а также общую сумму.


А использовали ли вы группировку с ROLLUP в реальных проектах?

#SQL
  • 👍 8
  • 🔥 6
  • ❤ 2
Older posts →

About this channel

How can I read @insight_t_bank without a Telegram account?
TGViewer shows the public web preview Telegram publishes for InSAйт: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does InSAйт have?
InSAйт (@insight_t_bank) has 3.15K subscribers on Telegram, refreshed roughly every 30 minutes.
Does InSAйт know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →