TGViewer
Channel Public Channel
Information Retriever

Information Retriever

@inforetriever

Author: @kkhrylchenko

Рекламу не размещаю.
Subscribers
4.15K
Photos
328
Videos
2
Links
170

Showing posts older than #140 · Back to latest

Older Posts 10 shown
Post #139 3.37K
В далеком 2018-м году, уже после Attention Is All You Need, но до BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding, Суцкевер на лекции в MIT пугающе точно описывал что будет происходить в ближайшие годы. В ответ на вопрос “как нам побороть проблему с генеративными LM’ками? Они плохо работают”, он уже тогда отвечал, что скорее всего достаточно замасштабироваться по данным и по модели (e.g. бахнуть тысячу одинаковых слоев), и получится гораздо лучше чем то, что было доступно на тот момент.

Но лекция была не совсем об этом, а гораздо обширней:
* дал интуицию обучению нейросетей и бэкпропу в частности
* сделал небольшое введение в RL
* аналогично, сделал супер краткое введение в meta-learning
* рассказал про self-play, верил в него как способ конвертировать compute в данные
* и даже про alignment рассказал, Deep reinforcement learning from human preferences

Это было ШЕСТЬ лет назад. Пруфы — https://youtu.be/9EN_HoEk3KY?si=T4ef2gJtDPNoZ4so
YouTube Ilya Sutskever: OpenAI Meta-Learning and Self-Play | MIT Artificial General Intelligence (AGI) This is a talk by Ilya Sutskever for course 6.S099: Artificial General Intelligence. He is the Co-Founder of OpenAI. This class is free and open to everyone. Our goal is to take an engineering approach to exploring possible paths toward building human-level…
  • 🔥 33
  • 👍 9
  • 🥰 4
  • ❤ 2
  • 🤯 2
  • 🏆 1
Post #138 3.85K
Статья на Хабре про индустриальные тренды рексистем.

В мае я выступал на датафесте с докладом про тренды рексистем, а сейчас появился пост на Хабре, где мы подробнее расписали содержимое доклада, приложили ссылки на статьи, добавили больше пояснений.

Ссылка — https://habr.com/ru/companies/yandex/articles/857068/
  • 👍 36
  • 🔥 5
Post #137 3.46K
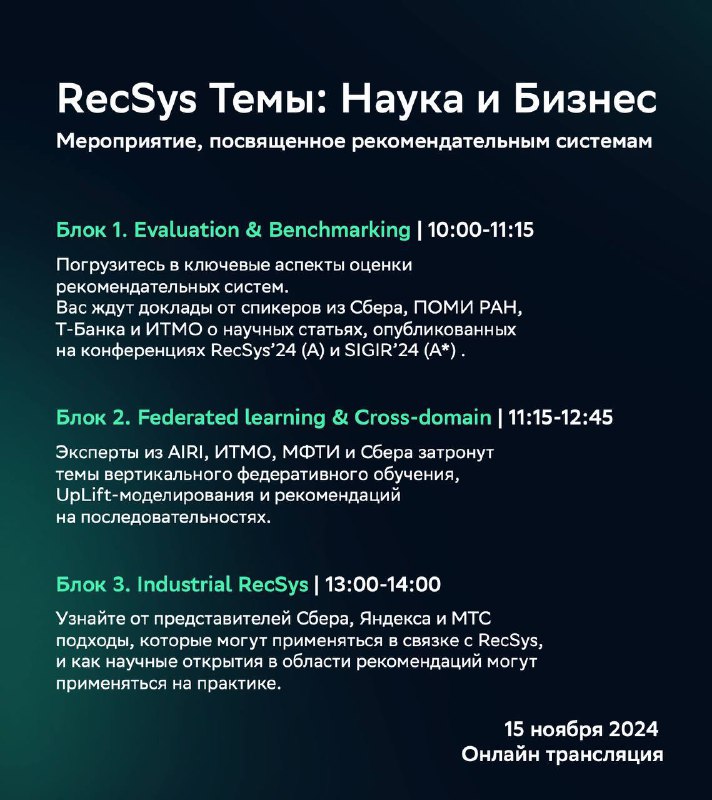
RecSys митап от Сбера.

Завтра буду выступать на митапе от Сбера. Попробую за 15 минут рассказать кейсы, когда идеи из статей помогали нам на практике. Выбрал следующие пять концептов: калиброванное ранжирование, logq-коррекцию, DCN-v2, unified эмбеддинги и генеративные рексистемы.

Ссылка на трансляцию — https://jazz.sberbank.ru/sber-2p5vw5?type=webinar&role=VIEWER&psw=OAEQUkIGAx9cERdEHRIUDFMbCg.

Презентацию приложу в комментариях после выступления.

UPD: для подключения к трансляции нужно отключить проверку сертификатов, e.g. Для хрома — open -a "Google Chrome" --args --ignore-certificate-errors; или установить некий sberjazz

Запись: https://www.youtube.com/watch?v=PwH69yapmPw
  • ❤ 16
  • 👍 7
  • 🔥 7
  • 💩 2
Post #128 2.5K

Forwarded from Yandex for ML

👷 RecSys 2024: всё о рекомендательных системах и тех, кто их делает

ACM Conference on Recommender Systems (RecSys) — крупнейшая международная конференция по рекомендательным системам. В этом году лидеры индустрии представили свои новейшие разработки и исследования в итальянском городе Бари.

Чем запомнилась RecSys 2024, рассказывает наш коллега Кирилл Хрыльченко, руководитель команды R&D рекомендаций в Яндексе.

🔳 P. S. Статьи, которые упоминает Кирилл:

⚪️ Better Generalization with Semantic IDs: A Case Study in Ranking for Recommendations

⚪️ Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations

⚪️ Demystifying Embedding Spaces using Large Language Models

Подписывайтесь:
💬 @Yandex4ML
📹 @YandexML
  • ❤ 21
  • 👍 10
  • 🔥 5
Post #126 3.87K
Google Shopping.

Оказывается, у Гугла есть такая штука, как Google Shopping — екомные рекомендации / поиск. Под капотом гигантский граф из товаров, продавцов, всякой инфы про эти товары (см. блогпост shopping graph explained). Прямо сейчас выкатывается большой апдейт:

1. Интеграция с Gemini: по поисковым запросам внутри платформы генерируется небольшая сводка, которая подсказывает на что стоит обратить внимание при поиске товара. И к рекомендованным товарам генерируются объяснения.

2. Тикток-подобная лента. В Гугле, судя по выступлению Ed Chi на рексисе, очень сильно верят в рекомендательные ленты в формате тиктока. Когда пользователь минимумом усилий может скроллить какие-то объекты, которые красиво отображаются в ленте. И вот здесь они тоже решили запилить такую ленту, в которой будут отображаться картинки и видео с товарами.

Полную новость про апдейт можно почитать в блогпосте Google Shopping’s getting a big transformation.

Ed Chi на днях получил повышение до VP of Research в Дипмайнде. Не знаю, правда, связано ли с этим релизом :)
  • 👍 12
  • 🔥 8
  • ❤ 6
Post #124 3.67K
RecSys, финальный день.

RecSys 2024 — всё. Однозначно, это была кульминация всех моих четырёх лет работы над рекомендальными системами. Учитывая, что я уже несколько лет живу в платоновском мире идей мире статей, для меня это было словно будучи анимешником попасть в Коноху. Ну вы поняли :) Следующий рексис будет в Праге. Обязательно постараюсь приехать; и вас к тому же призываю! Увидел вживую как минимум несколько новых подписчиков и коллег, надеюсь увидеть в следующем году еще больше :) А теперь по делу:

Посетил воркшоп ROEGEN, посвященный генеративным моделям.

Сначала был invited talk от Michael Ekstrand, про fairness в рексистемах. Есть пользователи, есть айтемы, не хотим каких-то странных перекосов и стереотипов в рекомендациях. На рексистемы можно смотреть как на задачу аллокации — нужно между пользователями так распределить айтемы, чтобы всё было справедливо нормально. Ещё, по-хорошему, рексистема не должна решать за пользователя что для него будет хорошо — у пользователя должна быть возможность самому решать что он хочет от рексистемы. Эдакие controllable recommender systems. Что еще:
* полезно рисовать график с распределением item exposure: по сути, закон ципфа для айтемов — по одной оси ранг айтема, по другой его популярность. Среди двух алгоритмов с одинаковым качеством ранжирования стоит выбирать тот, у которого площадь под этой кривой больше. Можно здесь еще приплести коэффициент Джини, matthew effect, popularity bias, etc
* люблю, когда в докладах ссылаются на старые статьи и книги. В данном случае это были книжка The Long Tail, статья Recommending and evaluating choices in a virtual community of use 95-го года, а также статья про Manipulation engines от Belkin and Robertson'а, которую я пока не нашёл.

Затем Craig Boutilier из Google Research выступил со своим видением использования LLM в рекомендациях. Пересказал две своих статьи: Demystifying Embedding Spaces using Large Language Models и Embedding-Aligned Language Models. Вторую не читал, а вот первая статья мне очень нравится. Когда она только вышла, канала ещё не было :) LLM научили "понимать" пространство эмбеддингов айтемов, и по произвольному эмбеду айтема генерировать описание. Можно тыкать в случайную точку в пространстве, в которой находится мало айтемов, узнавать у LLM что там за гипотетический айтем, а затем его производить. Free real estate =)

Также было выступление от Jinaling Wang (из группы Minmin Chen в Дипмайнде). Кажется, в итоге от каждой рекомендательной группы Дипмайнда было ровно по одному выступлению; все кратко пересказали свои статьи за ближайший год. Здесь речь шла про:
* Large Language Models as Data Augmenters for Cold-Start Item Recommendation: в оффлайне с помощью LLM генерируем пары для ранжирования, где оба айтема — холодные. Используем для них текстовые описания, и задачу формулируем как "вот описание айтема А, вот айтема Б, какой лучше? Напиши, A или Б". Полученные сэмплы используются как доп. лосс для классической рексистемы
* LLMs for User Interest Exploration in Large-scale Recommendation Systems: предсказываем с помощью LLM интересы пользователя, которые в рексистеме еще не реализовались, а затем в рамках кластера интересов находим конкретные айтемы с помощью классической рексистемы (e.g. двухбашенной модели)

Ещё один пост про рексис я напишу, но в целом путешествение подходит к концу. Давно я, конечно, так интенсивно не постил. Прямо вспомнились первые дни существования канала, когда каждую неделю строчил по три поста :) Буду ждать следующий рексис! Надеюсь, и вы тоже :)
  • 🔥 56
  • ❤ 16
  • 👍 3
Post #123 2.53K
RecSys, день четвёртый.

Сегодня был последний poster day. Наконец-то довелось пообщаться с Пинтерестом, и опять были какие-то жизненные разговоры с другими инженерами =) Успев обзавестись знакомствами за прошлые три дня, я уже ходил совсем уверенной походкой, кивая и улыбаясь знакомым :) Обо всём подробней ниже.

Bridging the Gap: Unpacking the Hidden Challenges in Knowledge Distillation for Online Ranking Systems от Google.

Есть многоголовая ранжирующая нейросеть для Ютуба. Хочется использовать дистилляцию, чтобы катать в прод модель с более хорошим качеством за те же параметры. Но при этом не хочется использовать "co-training", когда учитель и ученик учатся одновременно на одних и тех же сэмплах. Учат учителя отдельно, складывают его предикты в колоночную БД; у учеников учат отдельную голову на предикты учителя — говорят, что это еще и стабильней работает. Учитель обучается на данных со всех различных поверхностей (поиск, рекомендации, etc), а ученики только на данных с конкретной поверхности. Еще обсудили, что MSE на сигмоиды делать — норм тема :)

Learned Ranking Function: From Short-term Behavior Predictions to Long-term User Satisfaction от Google.

Используют cascade click model, моделируют вероятность клика, выхода из сервиса, а также некую долгосрочную награду. В более поздней итерации добавили условную оптимизацию, учли ограничения на какие-то другие метрики. В результате улучшили consumption / engagement метрики Ютуба. Понимаю, что рассказал очень невнятно — если интересно, лучше почитать статью :)

Taming the One-Epoch Phenomenon in Online Recommendation System by Two-stage Contrastive ID Pre-training от Pinterest.

Наконец-то выпала возможность пообщаться с кем-то из Пинтереста! Я ждал этого годами. Саму статью обсудили бегло, скорее сгружал все накопившиеся вопросы: про pinsage и pinnerformer, про текущие проекты, etc. Тоже используют torchrec. Еще говорят, что triton очень помогает пилить кастомные кернелы для оптимизации. Сейчас делают гетерогенный PinSage, пробуют учить pinnerformer end-to-end на ранжирование, работают над единым ранкером для всех поверхностей; заинтересовались semantic ids и генеративностью. Используют большие матрицы эмбеддингов, до 10ккк параметров.

Пообщался с еще одним инженером из Дипмайнда. Узнав, что я из России, начал расспрашивать меня про зиму — а еще сказал, что большую часть жизни не видел снег; зима ему не понравилась, потому что холодно и лицо морозит :) Я его убеждал, что смена времён года, цикличность природы — это очень красиво. Кажется, он проникся концептом =) Еще говорит, что work-life balance у них нормальный. В свободное время, внезапно, читает Властелин Колец; и хочет добраться до Сильмариллиона.

Разговаривал с инженером из инфры Меты. Обсуждали, что у нас образование гораздо жестче; что у них всё очень сильно разжевывают, а у нас хардкор. Он мне начал рассказывать какой-то анекдот, дескать русский профессор приехал прочитать курс лекций в какой-то зарубежный университет, и за одну лекцию рассказал то, что у них обычно за семестр проходили. Еще почему-то у него было мнение, что у нас очень развито искусство. Не стал его разубеждать, снял рюкзак, и повернувшись спиной продемнострировал на футболке "Демона Сидящего" Врубеля =)

Также поболтал с тимлидом команды, разрабатывающей torchrec; с инженером из mercari; еще инженер из меты почему-то спросил как много люди в России пьют =)

Вечером в театре Петруцелли выступал оркестр. Прикладываю фотографию. В какой-то момент исполняли музыку из Крестного отца :)
  • 👍 39
  • ❤ 27
  • 😁 1
Post #122 2.17K
RecSys, день третий.

Сегодня снова был poster day, но общения про статьи было еще меньше. Я с каждым днем всё больше осваиваюсь, сегодня, например, выцепил из толпы авторов HSTU, DCN и донимал вопросами =)

Сначала про рекомендательный дипмайнд. Это три команды, суммарно человек 25-30: одна команда занимается data / model efficiency, context understanding (e.g. DCN, data distillation), другая — трансформерами, масштабированием, генеративкой, LLM'ками (семантические айдишники от них), а про третью могу только спекулировать, так как ни с кем из нее не общался; как будто занимаются эксплорейшном. Основные два продукта, с которыми взаимодействуют — это Ютуб и Реклама; но также стараются распространять технологии на остальные сервисы, через репозитории / документацию.

Про torchrec. С постером про стотерабайтную матрицу эмбеддингов был товарищ из Меты, который активно пушит оупенсорс torchrec'а. Буквально с этой целью он на конфу и пришел! Пообещал через пару недель релиз stable версии, а также блогпост в пайторче. Пару дней назад он обновил документацию. На какие фичи стоит смотреть: jagged тензоры, эффективный эмбеддинг лукап, шардирование эмбедов для распределенного обучения. Было видно, что человек очень горит проектом и всеми силами стоит за оупенсорс! Меня точно убедил попробовать. Команда, делающая torchrec, довольно большая — около 8 человек.

Про создателей Actions Speak Louder than Words. В команде пять core мл инженеров: кроме (1) HSTU, делают еще (2) GPU retrieval (см. пост Миши) и (3) cross-service модели. Суммарно в разработке HSTU участвует примерно 20 человек. Статьи пишут в конце года, когда отдыхают =) Последние года 2-3 используют для своих обучений тот самый torchrec! Выцепил много технических подробностей про HSTU, их пока опущу :)

Подошел в постерном зале к одному директору из Гугла. Выяснилось, что оба любим музыкальные рекомендации. Посетовали что в Спотифае рекомендации плохие, и вообще они технологически очень отстали. Сам сценарий, когда тебе готовят по одному плейлисту каждую неделю — тоже отстойный. Стриминговый сценарий, как в Яндекс Музыке, гораздо лучше — все, что хочется, это нажать кнопочку "play" и получить какие-то новые крутые треки :)

С мл инженером, работающим в Youtube Shorts, обсудили тикток — что у них отдельные рекомендательные алгоритмы для США, Китая и Кореи; что исторически на севере всё более развито из-за того, что условия труда / добычи ресурсов были тяжелее, и нужно было выкручиваться :) На вопрос "на сколько технологически развита Россия" я сказал, что Москва довольно сильно развита инфраструктурно и логистически, но она отличается от остальной России. Внезапно, он спросил "but what about Saint Petersburg?" =)

Познакомился с еще одним инженером из Ютуба. Разговор строился примерно так: поздоровались, я спросил как ему работается в гугле, на что он ответил "capitalism is bad". Я сказал, что примерно на каждую рекламу в Ютубе это вслух повторяю =) Еще у него жена на половину русская, а ее сестра работает в Яндексе рекрутером. Свой человек!

Еще была инженер из инфры Меты, сказала довольно забавную вещь — больше нравится заниматься инфрой, потому что там ты всегда понимаешь как и почему происходят улучшения. А в ML, когда получаешь какой-то прирост, — его сложно нормально обосновать.

C автором DCN, DCN-V2 (и будущих DCN-V3, DCN-V4) тоже поболтали. Спрашивал, как вообще такие штуки можно разрабатывать, откуда идеи приходят — автор сказала, что в основном отталкивается от проблем, которые пытается решать. В случае DCN'ов было сильное стремление сделать более эффективную архитектуру. Так что problem-driven ресерч имеет место быть :)

А ещё Олег Лашинин завёл канал про рекомендательные системы — @recsys_for_all. Знаю Олега как очень вдумчивого и опытного специалиста по рексису. Подписывайтесь!
  • ❤ 44
  • 👍 9
  • 🔥 1
  • 🙏 1
Post #112 2.4K
RecSys, день второй.

Послушал opening keynote, поглядел на красоту театра Петруцелли, ушел смотреть постеры. Провел большую часть дня у постеров Дипмайнда =) Ниже небольшая выжимка из заметок.

Better Generalization with Semantic IDs: A Case Study in Ranking for Recommendations от Google.

Изначальный настрой с момента выхода статьи был скептический, но глядя на энтузиазм Дипмайнда, будем пробовать. Вместе с ней стоит читать Recommender Systems with Generative Retrieval и Aligning Large Language Models with Recommendation Knowledge. Подробный пост про них отложу, а сейчас напишу кратко:

* есть энкодер, с помощью которого можно получить эмбеды видеороликов. Учили его как автоэнкодер, без пользовательского фидбека
* поверх учим RQVAE на миллиарде айтемов, отобранных с помощью эвристик
* получаем из него те самые семантические айдишники. Их количество фиксированное (8-16 штук), при этом есть иерархичность — более ранние айдишники описывают более верхнеуровневые концепты. Для некоторых задач можно вообще оставить префикс (e.g. для категоризации айтемов)
* семантические айдишники можно использовать по-разному — обучать для них эмбеды; агрегировать мешком эмбедов, и затем подсовывать напрямую в ранжирующую модель
* а можно использовать в генеративной рекомендательной модели. В данном случае берется Gemini, формируется промпт вида "вот история пользователя: semantic ids ... semantic ids, что порекомендуешь?", и затем модель тюнится на ретривал. Достаточно небольшого трафика (в десятки раз меньшего, чем для моделей прошлого поколения), чтобы ее обучить

Подробностей еще много, оставлю для отдельного поста :) На таких мероприятиях можно узнать много ценной информации, которой нигде больше не узнаешь — чем авторы занимаются сейчас, что думают про другие статьи (в данном случае про Actions Speak Louder Than Words от Меты), какая у них структура R&D отдела, что уже внедрено, etc

Analyzing User Preferences and Quality Improvement on Bing's WebPage Recommendation Experience with Large Language Models от Microsoft.

Статья про рекомендации веб-страниц. Буду краток:
* используют InfoNCE, но про logQ-коррекцию до меня не слышали
* пробовали два вида позиционного дебаясинга: подставлять позицию как фичу и перевзвешивать сэмплы для обучения — не зажгло. Посоветовал подход, который используется в некоторых местах в Яндексе — делать отдельный позиционный бейзлайн и дообучать к нему основную модель как добавку
* графовые нейросетки не дают профит поверх коллаборативной фильтрации над графом совместных кликов. Единственное, что заработало — добавить в граф доп. ребра на основе семантической близости из content-based двухбашенной модели
* финальное ранжирование делается выпуклой комбинацией нейросетевого кросс-энкодера, обученного на релевантность, и кликового градиентного бустинга. Веса подбирают в оффлайне, глядя на парето фронт
* держат какой-то процент случайного трафика (случайного из 30 отобранных кандидатов), измеряют на нем в оффлайне качество алгоритмов

Co-optimize Content Generation and Consumption in a Large Scale Video Recommendation System от Google (YouTube Shorts).

Сама статья была не очень полезна, а вот общение с докладчиком интересное:
* pointwise лосс работает лучше, чем pairwise. Гипотеза команды — так как в сценарии youtube shorts у пользователя нет как такового сравнения разных айтемов, он их просто подряд листает, то и pointwise задача органичней. Похоже на Яндекс Музыку
* в ранкере две тысячи вещественных фичей, и еще две тысячи формируется через эмбеддинги
* кажется, используют hiformer; в статье этот момент сознательно опускают =)
* в проде есть два трансформера над историей пользователя: оффлайновый, обрабатывающий тысячи событий; и рилтаймовый, обрабатывающий сотни. Рилтаймовый учится end-to-end с ранкером, а оффлайновый учится отдельно, но на тот же самый лосс ранкера
* в модельке 14-20 разных голов; одна из основных — регрессия на watchtime
* используют дебаясинг, так как айтемы в начале сессии и в конце неравнозначны; делают некое перевзвешивание
  • 🔥 41
  • ❤ 4
  • 😁 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →